
Yates校正卡方检验
这个方法是做什么的
专门服务于 2×2 四格表的卡方检验。χ² 统计量本身是离散的(人数只能一个一个变),却拿连续的卡方分布去近似它的分布,这会让 p 值偏小、偏向“显著”。Yates 连续性校正把每格的 |O−E| 先减去 0.5 再平方,人为把统计量拉小一点,使结论更保守。示例中未校正的 Pearson χ²(1)=22.020,校正后是 20.928,就是这 0.5 带来的差。
报告不只给校正值:第二张卡把 Yates 校正 χ²、未校正 Pearson χ²、似然比 G² 与 Fisher 精确检验并排列出,四种口径结论一致时结果最稳健。第四张卡除 Cramér's V(0.271,95%CI[0.158, 0.384])外,给出四格表专属的一整套流行病学指标:两组率及其 Wilson 区间、率差 RD、相对危险度 RR、比值比 OR,以及与 Fisher 精确检验同源的条件极大似然 OR;最后是逐格调整标准化残差与 Bonferroni 校正 p。另有一个可选的权重变量拖拽区。
需要准备什么数据
- 分组变量X (行):定类变量(分组/标签)
- 分组变量Y (列):定类变量(分组/标签)
- 权重变量(可选):定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「分组变量X (行)」的类别数需在 2~10 之间。
- 「分组变量Y (列)」的类别数需在 2~10 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 吸烟与否 × 是否患病这类 2×2 的暴露-结局四格表
- 试验组与对照组 × 有效/无效
- 两种检测试剂 × 阳性/阴性(分别测两批不同标本时)
- 样本量不大、期望频数处在 5 上下、想给一个偏保守的 p 值
要求每个个体只贡献一格、观测之间独立,行列变量都恰好两类。第一张卡会逐格打出“观测频数 / 期望频数”并按 Cochran 判据判定(所有格期望频数 ≥1、E<5 的格不超过 20%),同时用一行“Yates 校正适用性”写明当前表是不是 2×2。注意校正的方向是让结论更难显著:它是在你担心假阳性时用的保险,不是用来把不显著的结果救成显著的。
什么时候不要用它
- 列联表不是 2×2:Yates 校正只在自由度为 1 时有定义,应改用「Pearson卡方检验」。
- 期望频数确实太小(有格子 E<5,尤其 E<1):校正只是让近似保守一点,并没有让近似成立,应改用基于超几何分布枚举的「Fisher精确检验」。
- 同一批对象前后两次测量、或同一批标本用两种方法各测一次:这是配对资料,四格表的四个数含义完全不同,应改用「配对卡方检验」。
- 需要控制混杂因素(年龄组、中心):用「分层卡方分析」在每层内部比较后再合并。
- 要同时校正多个协变量、或想直接得到校正后的 OR:分层会迅速把格子稀释,应改用「逻辑回归」把混杂因素作为协变量入模。
- 行列变量之一是有序等级、你关心的是等级高低:用「Ridit分析」。
容易误读的地方
- 拖进一个三分类变量,模块不会拒绝,而是给你一个名字叫“Yates 校正”、值却完全没有校正过的 χ²。 把示例的吸烟状况改成三类后实测:第二张卡里“Yates 连续性校正 χ²”与“Pearson χ²(未校正)”都是 26.507,一模一样——连续性校正在非 2×2 表上根本不施加。同时 Fisher 那一行、以及整张流行病学效应量表(RR/OR/率差)会整体消失,Phi 变成 N/A。唯一明说这件事的地方是第一张卡的“Yates 校正适用性”写着“不适用(当前为 2×3 表,应改用 Pearson 卡方)”,摘要里也有一句提示。看到 df 不是 1,就该换模块。
- Yates 校正在样本量大时是多余的,在期望频数很小时又不够。 它的适用带很窄:N 大的时候校正量被淹没(示例 22.020 与 20.928 都远超临界值,结论毫无差别),而真正稀疏的表该做的是精确检验而不是打个 0.5 的折扣。现代文献普遍认为它过度保守,报告时应写明用的是校正值还是未校正值,两者不要混用。
- OR 与 RR 的方向由类别的排序决定,不是由你心里的“暴露组”决定。 示例的参照组是“吸烟”、结局定义为“患病”,于是 OR=0.322 说的是不吸烟相对吸烟的患病比值——数值小于 1 并不意味着吸烟是保护因素,恰恰相反。表题里已经写明了结局取的是患病、比较方向是不吸烟对吸烟,报告前务必先读这一行再决定怎么措辞。
- RD、RR、OR 三个指标的可用性由研究设计决定,不能挑一个好看的报。 队列或横断面研究报 RR 与率差,病例对照研究只能报 OR——因为病例对照的入组比例是研究者定的,算不出真实发病率。示例三个指标同时给出(RD=−26.60%、RR=0.509、OR=0.322),是为了让你按自己的设计取用,不是让你三选一。
- 效应量一律基于未校正的 χ² 计算,与主结果表的校正 χ² 不同源。 表注对此有明确说明。所以不要拿 Cramér's V 反推校正 χ²,也不要因为“p 用了校正值、V 没用”就认为报告自相矛盾——刻画关联强度本来就不该做连续性校正。
报告里有什么
- 输出结果一: 数据概览与前提检验
- 输出结果二: Yates 校正卡方检验表
- 输出结果三: 交叉图
- 输出结果四: 效应量与事后分析
- 输出结果五: 结论与学术表述
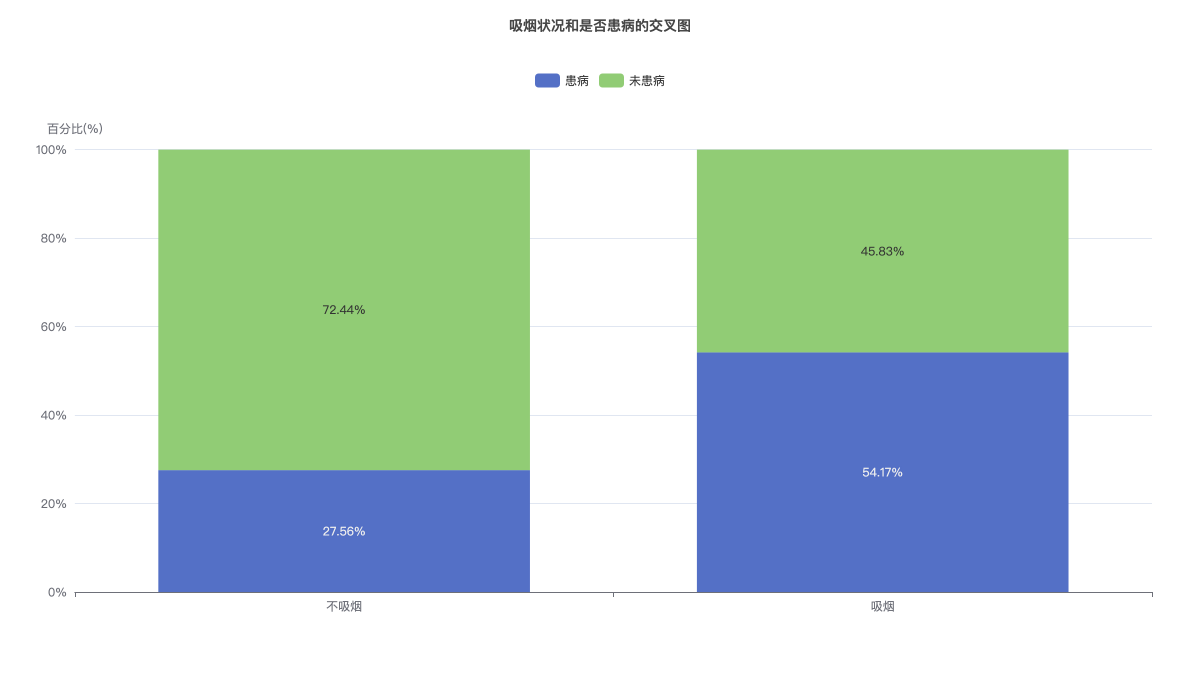
您可以通过图表上方的控件切换指标(如频数、行/列百分比)和图表类型。