
随机前沿分析(SFA)
这个方法是做什么的
别的回归拟合的是“平均水平”,随机前沿拟合的是“最好水平”,并回答每个单位离这条边界还差多远。做法是把残差拆成两截:对称的随机扰动 v(运气、测量误差)和单边的无效率成分 u(只会让你离前沿更远,不会更近)。生产前沿下复合误差 ε=v−u,成本前沿下 ε=v+u,前沿类型由控件在“生产前沿(产出最大化)”与“成本前沿(成本最小化)”之间选择,默认生产前沿。函数形式固定为 Cobb-Douglas 双对数:产出/成本与全部投入都取自然对数,因此系数直接就是弹性,弹性之和就是规模报酬。估计用 ALS(1977) 半正态设定的极大似然。
这份报告的第一落点不是平均效率,而是“该不该用前沿模型”的两条证据:卡① 的 Coelli(1995) 偏度检验看最小二乘残差是否朝无效率的方向偏(生产前沿要求负偏、成本前沿要求正偏),卡② 的单边似然比检验针对 H0:σu²=0——因为参数落在边界,临界值取 0.5χ²₀+0.5χ²₁ 混合分布(5% 约 2.706),不是 χ²₁ 的 3.841。卡④ 给方差分解 σu、σv、λ=σu/σv、γ=σu²/σ²、规模报酬的 Wald 检验,以及逐单元的 Jondrow(1982) 条件均值效率 TE=exp(−E[u|ε])。注意卡② 的系数表按表注声明不打星号,请自行按阈值判读。
需要准备什么数据
- 放入[定量]产出/成本 Y:1 个
- 放入[定量]投入 X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 要给一批同类单位(医院、支行、农场、地市、工厂)排效率,同时承认观测里既有真实的低效、也有运气成分
- 除了效率,还想一并得到各投入的产出弹性与规模报酬结论
- 你要回答的是“离最优还差多少”,而不是“平均而言多投一单位产出增加多少”
- 数据是截面,单位数量充足,且各单位的投入产出口径可比
产出/成本与全部投入必须是正数值:模块内部取自然对数,含 0 或负值的行会被剔除并在报告中如实说明数量。有效样本量至少为“投入变量个数+1+3”,建议不少于 30——样本过小时 λ 与技术效率都不可靠。投入取对数后不得完全共线。
什么时候不要用它
- 不愿设定函数形式,想要非参数的效率前沿:用「数据包络分析(DEA)」。它不假定 Cobb-Douglas,代价是不区分运气与无效率,把全部偏离都算成无效率。
- 数据是同一批单位的多期观测:本模块是截面随机前沿,卡⑤ 明写它无法区分持久性无效率与暂时性无效率。产品内可行的做法是分期各跑一次本模块、比较各期的效率水平与 γ,并在文中说明未使用面板前沿;若你要的只是弹性而不是效率,用能利用面板结构的「面板模型」。
- 投入或产出中有 0 或负值且该零值有实质含义(零产出、亏损):双对数取不了对数,这些行会被剔除,剔除本身就会让样本有选择性。别指望换个模块能绕开——产品内另一个前沿模块「数据包络分析(DEA)」同样按正值定义,它的校验原话是“投入与产出的所有取值必须为正数”,并直接提示“如有 0 值请先做平移”。所以两个前沿模块只有同一条出路:先在数据处理里用“非负平移”把该列推到正区间,再在文中声明平移量——双对数下平移会改动弹性估计,此时效率排序比效率数值更经得起引用。
- 你要的本来就是平均关系而不是边界:用「线性回归 (最小二乘法)」;因变量偏态时先做「数据变换(Box-Cox/Yeo-Johnson)」。
- 只是想把多项指标合成一个综合得分来排名:那是评价问题不是前沿问题,用「优劣解距离法(TOPSIS)」或「熵值法」。
- 需要给每个单位的效率配一个置信区间,或检验效率差异是否显著:本模块的 TE 是 Jondrow 条件期望的点估计,卡⑤ 写明未给出区间(需 Horrace-Schmidt 区间),产品内也没有能补上这一步的前沿模块。退一步的做法是把卡④ 的逐单元 TE 另存成一列,按单位类别用「独立样本 Mann-Whitney U 检验」比较效率分布有无系统性高低——那检验的是组间差异,替代不了单个 TE 的精度。
容易误读的地方
- 所有单元的效率都是 1.0000,不是“人人完全有效”,而是前沿方向选反了或数据不支持。 实测把同一份演示数据的前沿类型从“生产前沿”切到“成本前沿”:λ 与 γ 直接掉到 0.000,平均效率、最低效率、最高效率全部变成 1.0000,单边 LR=0.000、p=1.0000,报告同时打出提示“OLS 残差偏度=-0.435,方向与所选成本前沿相反……请核对前沿类型或数据质量”。见到 TE 齐刷刷等于 1,第一件事是回卡① 核对偏度方向,而不是庆祝。
- γ 与单边 LR 决定 TE 值不值得读,平均效率本身不是结论。 γ=σu²/σ² 回答的是“复合误差里有多大比例是系统性无效率”。γ 接近 0 或 LR 不显著时,模块照样能算出一串 TE 数字,但那只是把随机噪声解释成了效率差异。演示数据 γ=0.8842、LR=6.538(p=0.0053),先过了这一关,后面的效率排序才有意义。
- 卡① 的偏度检验与卡② 的 LR 检验可能不一致,报告会如实说,不要只挑一个看。 演示数据里偏度检验 p=0.0518 刚好没到 0.05,而单边 LR p=0.0053 显著,卡② 因此写下“本次两项证据并不完全一致,解读时请以样本量与经济含义综合判断”。两者一个看最小二乘残差的形状、一个比前沿模型与最小二乘的似然,方向一致时结论才最稳。
- 效率的绝对水平依赖“无效率服从半正态”这个假定,能稳健引用的是排序而不是数值。 卡⑤ 的模型局限写明:若真实分布是截断正态或指数分布,TE 的绝对水平会有偏。所以“平均效率 0.8436、尚有 15.6% 提升空间”里的 15.6% 不适合当作可核算的产能缺口去做预算或考核指标,而单位之间谁高谁低通常更靠得住。
- 弹性之和是规模报酬,与技术效率是两回事,别混着讲。 演示数据 Σβ=0.7286,卡④ 给了 H0:Σβ=1 的 Wald 检验(z=-4.794,p<0.0001),判定规模报酬递减。“按比例扩大投入产出能否同比例增加”与“在现有投入下离最好水平差多少”是两个独立的问题:一家单位完全可能技术效率很高,同时处在规模报酬递减区间——前者说它把手里的资源用好了,后者说它不该再扩张。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:前沿回归系数(弹性)与无效率存在性检验
- 输出结果三:技术效率 TE 分布与排序
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
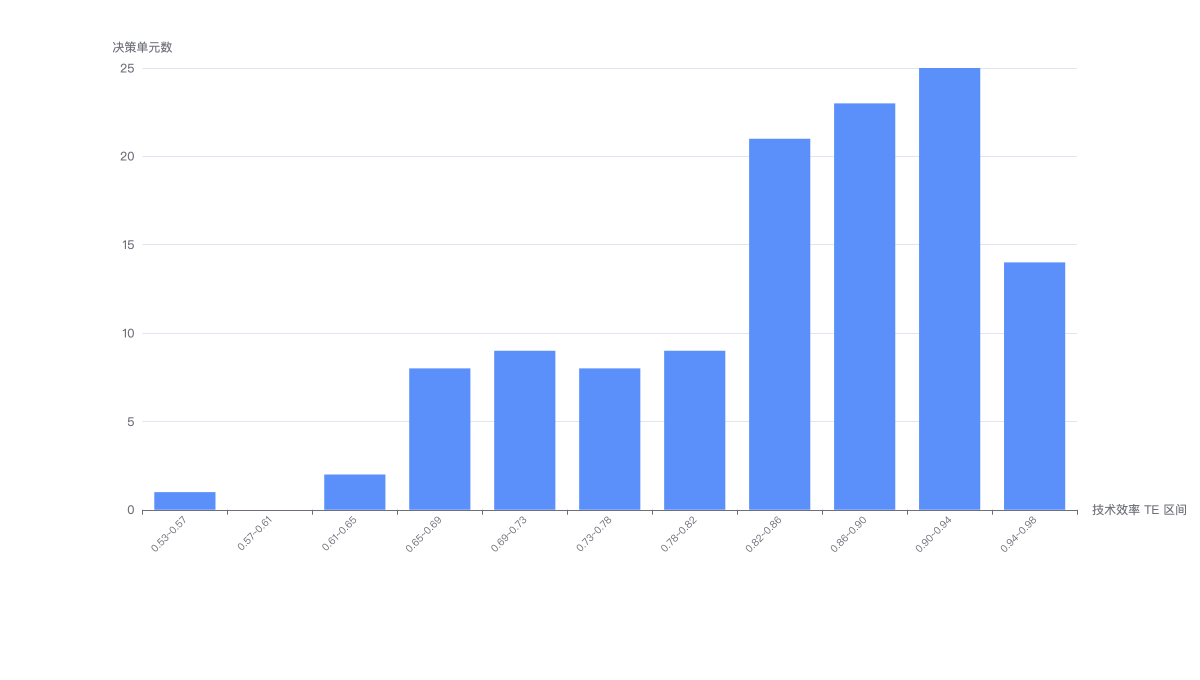
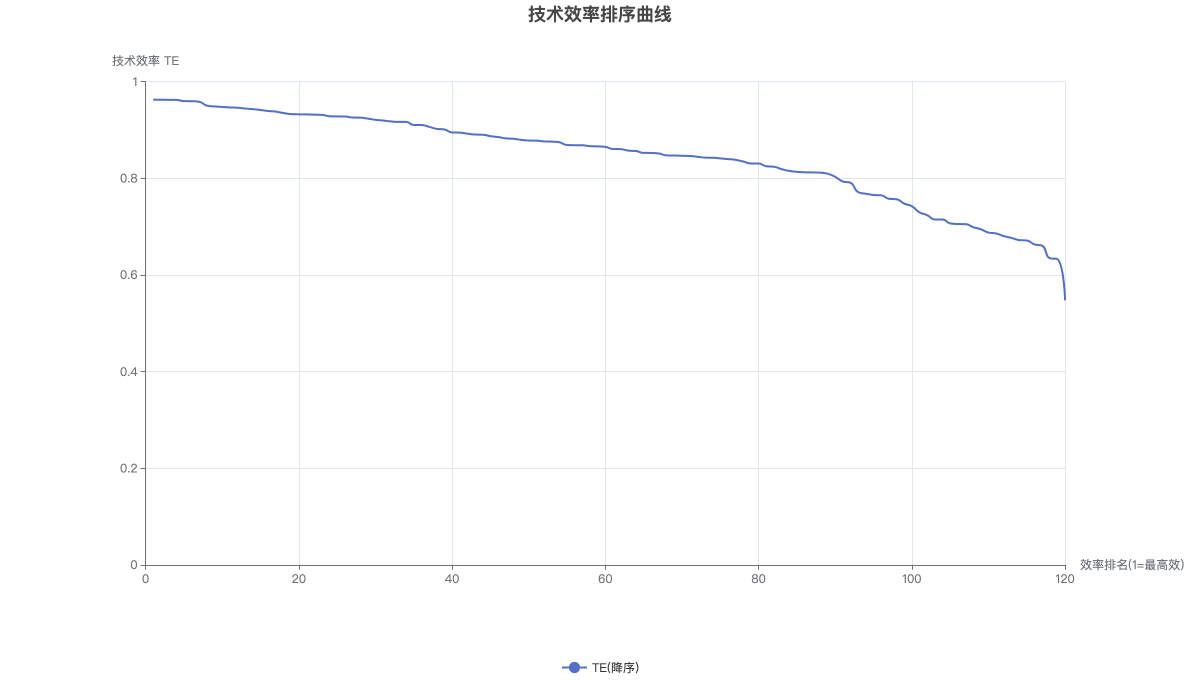
上图为 TE 分布直方图(横轴为 TE 区间、纵轴为落入该区间的决策单元数);下图为按 TE 由高到低排列的效率排序曲线。上图可用切换器改看表格/条形图。