
拟合工具箱
这个方法是做什么的
给散点找一条能描述其走势的曲线。它做的是多项式最小二乘拟合:一个自变量时拟合一条 d 次曲线,两个自变量时拟合一张 (d₁, d₂) 次的曲面,次数各可在 1~10 之间手选,也可以打开“拟合模型自动寻优”让它在 1~5 次的组合里搜。这里的目标是把形状描准,不是解释机制——回归系数那种“X 每增加 1 个单位 Y 变化多少”的读法在这里不成立。
报告给出每个参数的估计值、标准误、t、p 与 95% 置信区间(参数按 p_ij 命名,表示 X₁^i·X₂^j 的系数),模型整体 F 检验、R²(含 95% 置信区间)、调整 R²、RMSE 与 AIC/BIC,拟合效果图与标准化残差图,以及两样专门用来定次数的东西:候选次数的横向比较表(标出 AIC 最优、BIC 最优、调整 R² 最优与本次选定)和与降一次模型的嵌套 F 检验。卡① 还会算标准化设计矩阵的条件数——高次项之间天然近乎共线,条件数一大,单个系数的符号和显著性就都不能逐个解读了。
需要准备什么数据
- 放入 [定量] 因变量Y (变量数=1):定量变量(数值)
- 放入 [定量] 变量X1 (变量数=1):定量变量(数值)
- 放入 [定量] 变量X2 (变量数≤1)(可选):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 散点明显不是直线,想先找一条平滑曲线把趋势描出来,用于作图与展示
- 需要一个在观测范围内可用的插值/内插公式(标准曲线、校准关系、工艺响应)
- 想判断“到底要几次才够”,需要嵌套 F 检验和 AIC/BIC 这样的客观依据
- 有两个自变量,想看它们联合作用下的响应曲面形状
因变量与自变量都必须是定量非常数列,最多两个自变量(第二个可选),列表删除缺失后样本量必须大于待估参数个数。参数个数随次数急剧膨胀:一元 d 次是 d+1 个,二元 (d₁, d₂) 次是 (d₁+1)(d₂+1) 个——两个变量各取 5 次就是 36 个参数。卡① 会实测“每参数观测数 ≥ 10”这条经验下限、条件数、残差正态性(Shapiro-Wilk)与同方差性(Breusch-Pagan),并把两个自变量的取值范围列出来当作方程的有效区间。
什么时候不要用它
- 目的是解释每个自变量的净效应、要一张可解读的系数表:多项式系数没有结构性含义,高次项之间还高度共线——用「线性回归 (最小二乘法)」,它给出偏效应、标准化系数、共线性与残差的完整诊断。
- 超过两个自变量:本模块最多收两个 X——用「线性回归 (最小二乘法)」,非线性关系可先对变量做「数据变换(Box-Cox/Yeo-Johnson)」再拟合。
- 只想描述一个连续变量与结局之间的非线性形状,并保留统计推断:多项式在数据稀疏处会剧烈摆动——用「限制性立方样条(RCS)」,它对结局连续或二分类都适用,且不会在端点发散。
- 真实关系有理论形式(指数增长、幂律、Logistic 饱和、寿命分布):用高次多项式硬拟出来的曲线没有参数含义也不能外推——时间序列的趋势外推用「时间序列分析(ARIMA)」或「灰色预测模型GM(1,1)」,寿命与失效数据用「Weibull可靠性(寿命分布)」。
- 数据来自试验设计、要找最优工艺点:那有专门的设计与分析口径——用「响应面分析(RSM)」,配合「中心复合设计(CCD)」或「Box-Behnken设计」。
- 只求预测准,不在乎公式长什么样:多项式不是好的预测器——用「支持向量回归(SVR)」或「随机森林回归」。
容易误读的地方
- “自动寻优”的寻优指标选 R²,等于事先决定要过拟合。 R² 随次数单调不减,按它挑必然挑到搜索范围内能拟合成功的最高次;候选表的表注也把这句话写在那里。实测的例子很直观:同一批数据手选 2×2 次得到 9 个参数,打开自动寻优按 R² 搜出的是 5×2 次、18 个参数,条件数从 468 飙到 30 万,每参数观测数掉到 6.67(不满足 ≥10),而候选表里 AIC 与 BIC 最优的其实是最简单的 1×1 次。另一个指标 RMSE 是按残差自由度算的,与比较调整 R² 完全等价,会惩罚参数个数——要用自动寻优就选它;但它仍比 AIC/BIC 宽松,选完还得回到候选表看那两列标的是哪一行。
- 看到某个 p_ij 不显著就删掉那一项,是错的做法。 x、x²、x³ 之间近乎共线,单项的标准误被撑得很大,各项 p 值都不显著、但它们整体仍可能显著;反过来某一项碰巧显著也说明不了那个次数必要。判断次数够不够只有一个可靠依据:卡④ 的嵌套 F 检验,它的原假设是“降一次的简约模型已经够了”。它不显著就该降次,即使 R² 会掉一点。
- 整体 F 显著只说明多项式比常数模型好,不说明次数选对了。 这两件事经常被混为一谈:模型整体 F 的原假设是“除截距外全部项的系数同时为 0”,拒绝它是很低的门槛。实测里可以出现整体 F 极显著(p < 0.001)而嵌套 F 检验提示应当降次的组合——两张表回答的根本不是同一个问题。
- 严禁外推,这是多项式最凶的一条。 卡① 把两个自变量的取值区间明确列成“方程的有效区间”,并注明这一项属于“未做该检验”——外推风险由使用方式决定,数据本身检不出来。多项式在区间外会剧烈发散,次数越高发散越快;一条在样本内 R² 很漂亮的 5 次曲线,往外挪一点点就可能给出负的销售额。
- 拟合优度高不等于找到了机制。 R² 只说明这条曲线离这批点近,它不区分“真实关系确实是二次的”与“恰好这批噪声让二次曲线贴得紧”。真正能提示设定问题的是残差图:标准化残差里残留 U 形或 S 形,说明当前次数还不足以刻画趋势;呈喇叭形则提示异方差——这两样都比 R² 可靠。
- 调整 R²、AIC、BIC 三者结论不一致时,不要挑对自己有利的那个。 它们的惩罚强度不同:BIC 对参数个数罚得最重、最偏好简约模型,调整 R² 罚得最轻。惯例是样本量较小或以解释为目的时优先 BIC。另外 AIC/BIC 只在同一因变量、同一批样本之间可比,跨数据集比大小没有意义。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:拟合参数与模型整体检验
- 输出结果三:拟合效果图与残差诊断图
- 输出结果四:效应量、模型比较与次数必要性检验
- 输出结果五:结论与学术表述
蓝点为原始数据、绿色曲面为拟合结果(三维散点 + 曲面)。 拟合次数:广告投入(万元) 次数 = 2,门店面积(平米) 次数 = 2。可用右上角切换器切到「表格」逐点读数。
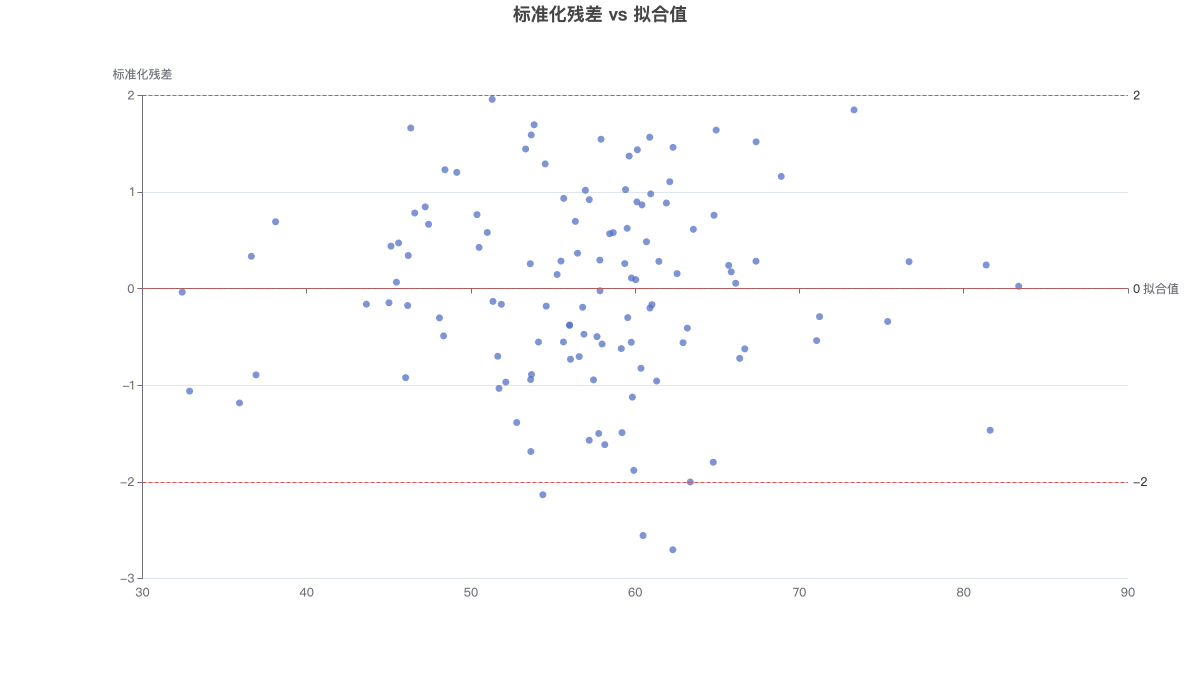
横轴为拟合值、纵轴为标准化残差;红色虚线为 0 与 ±2 参考线。理想情况下散点应在 0 线上下无规律均匀散布。