
c 图
这个方法是做什么的
监控每个检查单元上的缺陷个数是否稳定。它统计的是缺陷数而不是不合格品件数——同一块电路板上三个虚焊记 3 个缺陷,同一匹布上五处疵点记 5 个缺陷,所以计数没有上界,模型用的是泊松分布而不是二项分布。每一行是一个子组,中心线取平均缺陷数 c̄=ΣX/k,控制限取 c̄±3√c̄(泊松的方差等于均值,σ 由 c̄ 直接决定),下限在 0 处截断。它的硬前提是各子组的检查机会必须恒定:受检面积、长度、时间或件数都要一样,否则应改用 u 图。
有一处与其他计数型控制图不同、值得单独留意:c 图的单点报警率是按受控泊松分布精确算出来的,不是 3σ 的名义 0.0027。演示数据 c̄=7.48 时,卡②给出的 α=0.004496,受控时 25 个子组的期望误报因此是 0.1124 个而非 0.0675 个。中心线的区间用的也是精确方法(泊松均值的 Garwood 区间,演示为 [6.4463, 8.6323])。其余结构:卡①用泊松离散 χ² 检验等离散性、用 c̄≥5 判断正态近似是否可靠、用一阶 Ljung-Box 查自相关;卡④给离散比 φ、观测 CV 与泊松理论 CV 之比、最大标准化偏离,以及各子组与其余子组合并水平的条件二项精确检验(Holm 校正);判异准则是 Nelson 8 条。
需要准备什么数据
- 缺陷数:1 个,定量变量(数值)
- 子组编号/批次:1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 10%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 固定面积/长度/数量的检验单元上数缺陷:每 100 米布的疵点数、每块板的焊点缺陷数、每台整机的外观瑕疵数
- 每个班次时长固定,统计该班次的故障次数、报警次数、投诉件数
- 一件产品可能同时有多个问题,你关心的是问题总量而不是“有没有问题”
- 需要把缺陷水平写成带精确置信区间的形式(泊松均值的 Garwood 区间不依赖正态近似)
前提:缺陷数为非负整数计数;各子组的检查机会恒定;缺陷相互独立发生、不成簇(这是泊松分布的实质要求,卡①用离散 χ² 检验它);数据要求把行数下限定在 20,少于 20 个子组会被前置校验拦下。3σ 控制限的正态近似需要 c̄≥5,卡①会给出实测值并在不满足时提示改用精确泊松控制限。
什么时候不要用它
- 各子组的受检面积/长度/时间不一样:缺陷数会随检查量水涨船高,必须先除以检查量,改用「u 图」。
- 统计的是“坏了几件”而不是“有几处缺陷”:一件产品最多只能坏一次,那是二项而非泊松,样本量固定用「np 图」,样本量浮动用「P 图」。
- 质量特性是连续测量值:用「X-bar/R 控制图」「X-bar/S 控制图」或「单值-移动极差(I-MR)控制图」。
- 要抓缺陷数的小幅持续上升:3σ 限对这类漂移迟钝,可把标准化后的序列交给「CUSUM累积和控制图」或「EWMA控制图」。注意这条路要你手工做两步:先在数据里自己加一列 zᵢ=(cᵢ−c̄)/√c̄,再在 CUSUM 里把目标值 μ0 显式填 0(留空它取的是样本均值)。
- 只想检验这批计数是否服从泊松分布,不做过程监控:用「泊松分布检验」。
- 想解释缺陷数受哪些因素影响(机台、班次、原料),而不是随时间稳不稳:用「计数数据回归」;零特别多时用「零膨胀计数回归(ZIP/ZINB)」。
容易误读的地方
- 别拿 0.27% 当 c 图的误报率。 泊松是离散且右偏的分布,c̄±3√c̄ 这条界限并不对应对称的 0.27% 尾概率。演示数据实测 α=0.004496,是名义值的 1.67 倍,25 个子组的期望误报 0.1124 个。c̄ 越小这个偏差越大——这也是卡①要专门检查 c̄≥5 的原因。所以“出现一个越限点”的稀奇程度,比你按 3σ 直觉估计的要低。
- 卡②说“可由随机误报解释”,卡⑤仍判“未受控”,两者不矛盾。 演示数据里,超限点数的精确二项检验 p=0.107(1 个越限点确实不算多),但泊松离散检验 χ²(24)=64.471、p<0.001 已经拒绝了等离散假设,卡⑤据此把两项证据合并后判失控,并在结论里逐字说明了这个分歧。读报告时不要只挑其中一句,它们回答的是“越限点多不多”和“整体波动像不像泊松”两个不同问题。
- “检查机会恒定”这一条报告查不了,只能你自己保证。 卡①的前提表里这一行的统计量、df、p 全是破折号,结论栏写的是须由抽样方案保证。数据里根本没有检查量这一列,模块无从判断。如果各批的受检面积其实差了一倍,缺陷数自然跟着差一倍,图上会呈现成漂亮的“过程失控”——而真实原因只是你没除以检查量。
- 过离散在这里的物理含义是“缺陷成簇”。 演示数据 φ=2.686,观测 CV 与泊松理论 CV 之比 1.639:实际波动明显大于泊松预期。泊松假定缺陷彼此独立地随机出现,而现实中一个根因常常一次造成好几个缺陷(一次装夹偏移导致同一批板上多个孔位超差),于是缺陷不再独立、方差被放大。此时 3σ 限太窄、越限点成片,追查“哪一批出了问题”会越查越乱。卡①的结论文案会建议改用负二项模型或 Laney u′ 图,但产品目前不提供 Laney 图型;能落地的方向是先把成簇的根因拆出来,或用「计数数据回归」把批次因素显式建模。
- 卡④表里的 z 与它旁边的 p 不是一一对应的,别用 z 反推显著性。 那一列 z=(cᵢ−c̄)/√c̄ 是绘图口径的标准化偏离,Nelson 规则 2~8 用的就是它;而 p 值来自条件二项精确检验(缺陷总数固定时 cᵢ~Bin(X, 1/k)),两者的松弛差异是预期内的,表注专门写了这一点。看显著性请看 p 与 Holm 校正 p,看图上位置请看 z。
- 下控制限被截断在 0 时,改善永远报不出来。 演示数据 c̄=7.48、LCL=max(0, 7.48−3×2.735)=0,缺陷数下降到 0 也不会触发任何越限信号。想确认改善是否真实,看的是 c̄ 及其 Garwood 区间随时间的变化、以及卡④对各子组的事后比较,而不是等控制图给你一个红点。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:控制限与稳态检验(主结果)
- 输出结果三:c 控制图可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
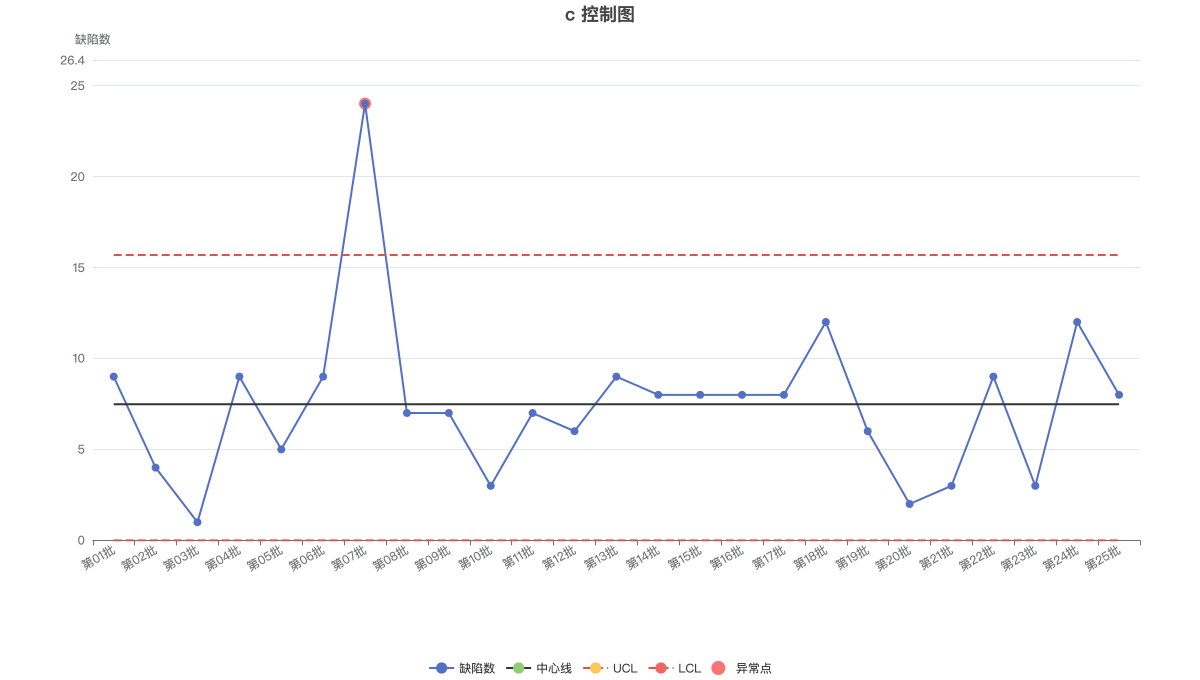
c 图用于监控固定检查机会下的缺陷数;黑色实线为中心线 c̄,红色虚线为 3σ 控制限,红点为超限子组。可用切换器在折线图/柱状图/数据表之间切换。