
分位数回归
这个方法是做什么的
普通回归估的是条件均值:广告每多投 1 万元,销售额“平均”多几万。分位数回归换一个问法:对本来就卖得差的那批店(低分位)和本来就卖得好的那批店(高分位),同样多投 1 万元,效果是不是一样?它对每个选定的分位点 τ 各估一套系数,用的是加权绝对偏差最小化,因此既不要求误差正态,也不要求同方差,还不会被少数极端值主导。
除了各分位点的系数、标准误、t、p 与 95% 置信区间,第四张卡给两层效应量:一是各分位点的 Koenker-Machado Pseudo R² 与显著自变量数;二是最低与最高两个分位点之间的系数差异检验(差值、差值标准误、z、p,以及该变量在全部分位点上的系数极差)。第三张卡给每个变量一张系数随分位数变化的折线图,带 95% 置信带。本模块特有的着眼点是:折线斜不斜是看点估计,效应到底有没有异质性要看第四张卡那张差异检验表——第二、第三张卡的结论文案都专门提醒了这一点。
需要准备什么数据
- 因变量 (Y):定量变量(数值)
- 自变量 (X, 可多选):1~50 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 因变量偏态或有厚尾(收入、住院费用、销售额),均值代表不了“典型”水平
- 你关心的问题本来就是“对高端人群和低端人群的作用是否不同”
- 存在异方差,OLS 的一条均值线掩盖了不同水平上的差异
- 只想要一条不被极端值拉走的中位数回归线
前提是每个待估分位点附近都有足够观测,尾部分位(0.05 / 0.95)尤其吃样本量,拟合失败的分位点会被直接跳过、不出现在报告中。本模块的估计不做哑变量编码,自变量必须是真数值的定量列,定类列会被拦截并提示先做编码;因变量为定量,且因、自变量都不能是常数列。
什么时候不要用它
- 只关心平均效应,且误差近似正态同方差:用「线性回归 (最小二乘法)」,同样条件下它更有效率,也更好沟通。
- 因变量是“是 / 否”:用「逻辑回归」;是等级用「有序逻辑回归」;是计数用「计数数据回归」。
- 问题其实是少数离群点污染了估计,而不是各分位段的效应真的不同:用「稳健回归(Huber M估计)」,它给的仍是一条均值型的线,但对离群点不敏感。
- 想看的是自变量与因变量之间的非线性形状:用「限制性立方样条(RCS)」,或用「拟合工具箱」比较各种函数形式。
- 数据是个体 × 时期的面板:分位数回归不处理个体效应,用「面板模型」。
容易误读的地方
- 点估计随分位数上下浮动是常态,多半不显著——看差异检验,不要看折线的坡度。 实测默认的三个分位点上,同一个自变量的系数分别是 2.709、2.551、2.343,看起来单调下降,画在图上也是一条明显向下的线;但第四张卡给出的差值是 −0.3657、差值标准误 1.0015、z = −0.365、p = 0.7150,四个参数没有一个达到 5% 显著。仅凭折线走势断言“效应随水平递减”,是这份报告最容易犯的错。
- 那张差异检验只比最低与最高两个分位点,而且偏保守。 表注写明差值标准误按 √(SE²低 + SE²高) 计算,忽略了两个分位点估计量之间的协方差;由于该协方差通常为正,本检验会高估差值方差,因而不显著不等于没有异质性,严格推断建议对整套分位数过程做自助法重抽样。同时,你在控件里选的分位点范围直接决定了它拿哪两端来比:实测把 0.25~0.75 换成 0.05~0.95,显著的参数数就从 0/4 变成 1/4。
- 那张表里的“参数”包含常数项,而第五张卡的模板句会把它说成自变量的异质性。 实测 0.05~0.95 这一档,唯一显著的差异出在常数项(τ=0.05 时 −8.6341、τ=0.95 时 13.2103,差值 21.8444,p = 0.0341),三个自变量一个都不显著;可第五张卡的学术表述模板写的是“1 个参数的系数差异达到 5% 显著水平,表明自变量的效应随因变量水平存在异质性”。常数项在各分位点上不同,只说明因变量的条件分布本身是散开的——这恰恰是做分位数回归的前提,而不是自变量效应有异质性的证据。誊模板句之前,回第四张卡数一遍到底是哪一行显著。
- Pseudo R² 与 OLS 的 R² 不可比,数值小不代表模型更差。 实测三个分位点的 Pseudo R² 在 0.2845~0.3127 之间,而同一组变量的 OLS 基准 R² = 0.5081。表注点明 Pseudo R² 是绝对偏差口径、R² 是平方偏差口径,第一张卡的结论文案也写着“二者口径不同,不可直接比较大小”。拿 0.28 对 0.51 说“分位数回归拟合更差”是把两把不同的尺子摆在一起量。
- 第一张卡的正态性与异方差检验不是分位数回归的前提。 图注说得很清楚:分位数回归本身不要求误差正态或同方差——这正是它相对 OLS 的优势;因此本卡的正态性 / 异方差检验不是分位数回归的前提条件,而是用来判断“是否值得改用分位数回归”的依据。实测这份数据两项都不显著(Shapiro-Wilk p = 0.8952、Breusch-Pagan p = 0.7113),判定列给的是“各分位点的斜率若仍有差异,则来自分布形状而非尺度变化”,而不是“不该用分位数回归”。把这两个 p 当成前提检验去卡门槛,方向就反了。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:各分位点回归系数表
- 输出结果三:变量系数随分位数变化图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
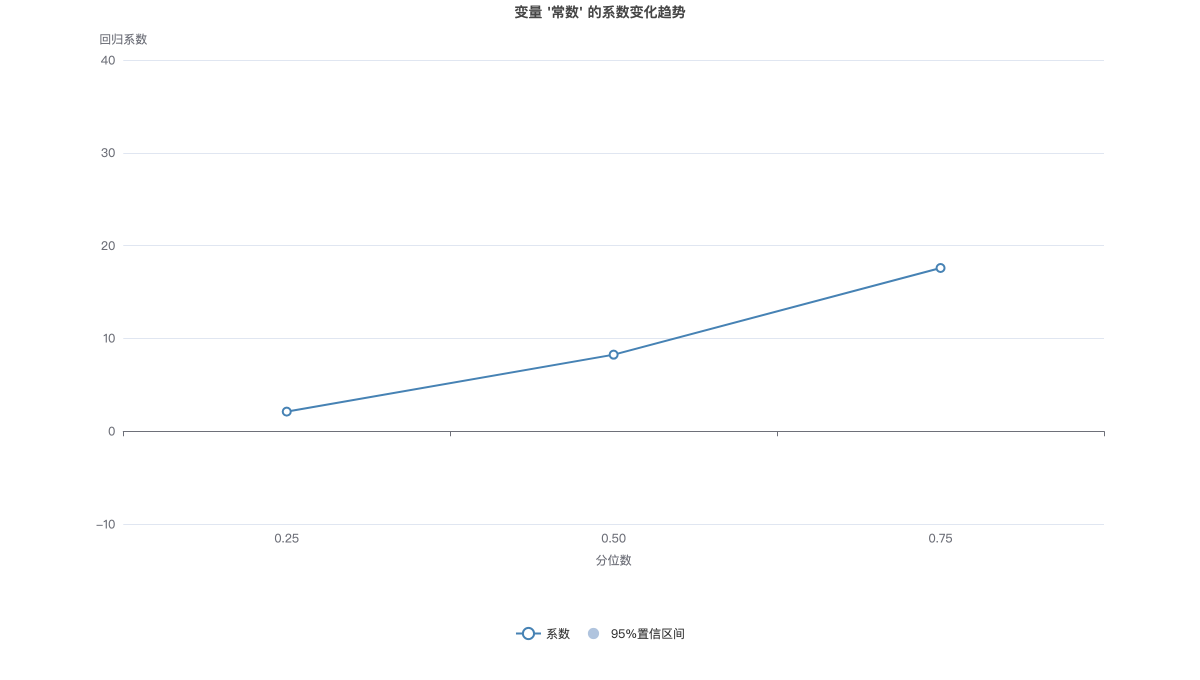
上图为每个变量(含常数)生成一张系数变化图。蓝线为回归系数,阴影区域为95%置信区间。您可以通过点击图表上方的标签页切换查看不同变量的图;也可用切换器改为「表格 / 柱状图」查看所有变量的系数随分位数变化的汇总。
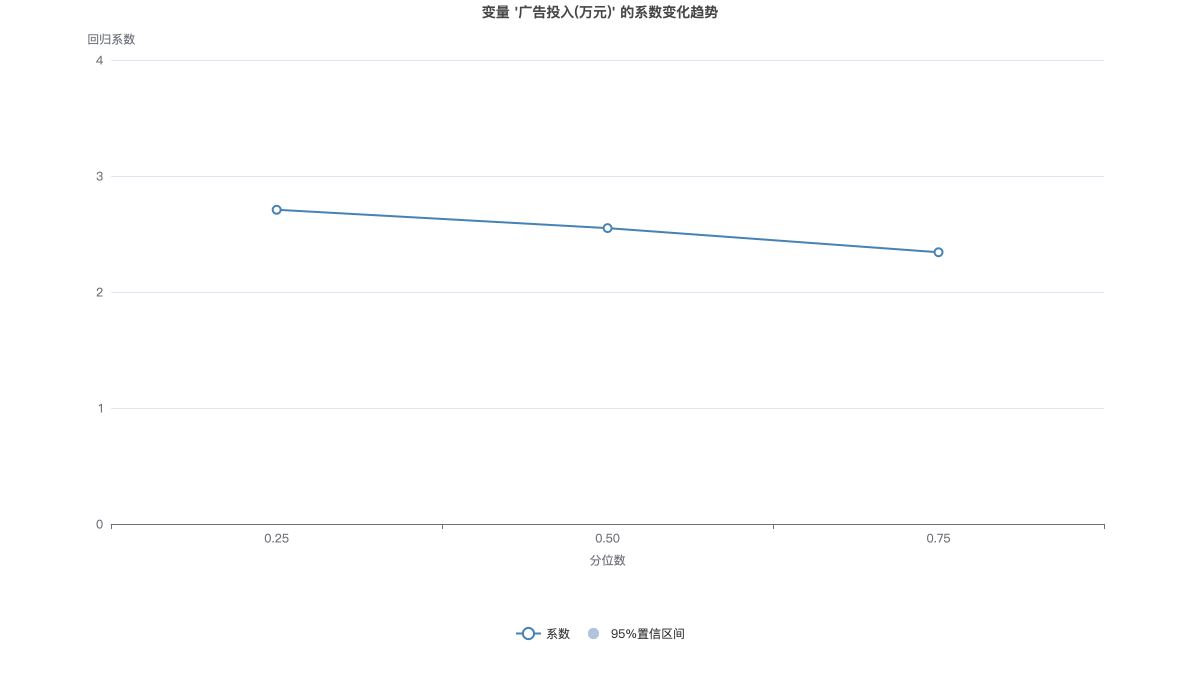
上图为每个变量(含常数)生成一张系数变化图。蓝线为回归系数,阴影区域为95%置信区间。您可以通过点击图表上方的标签页切换查看不同变量的图;也可用切换器改为「表格 / 柱状图」查看所有变量的系数随分位数变化的汇总。
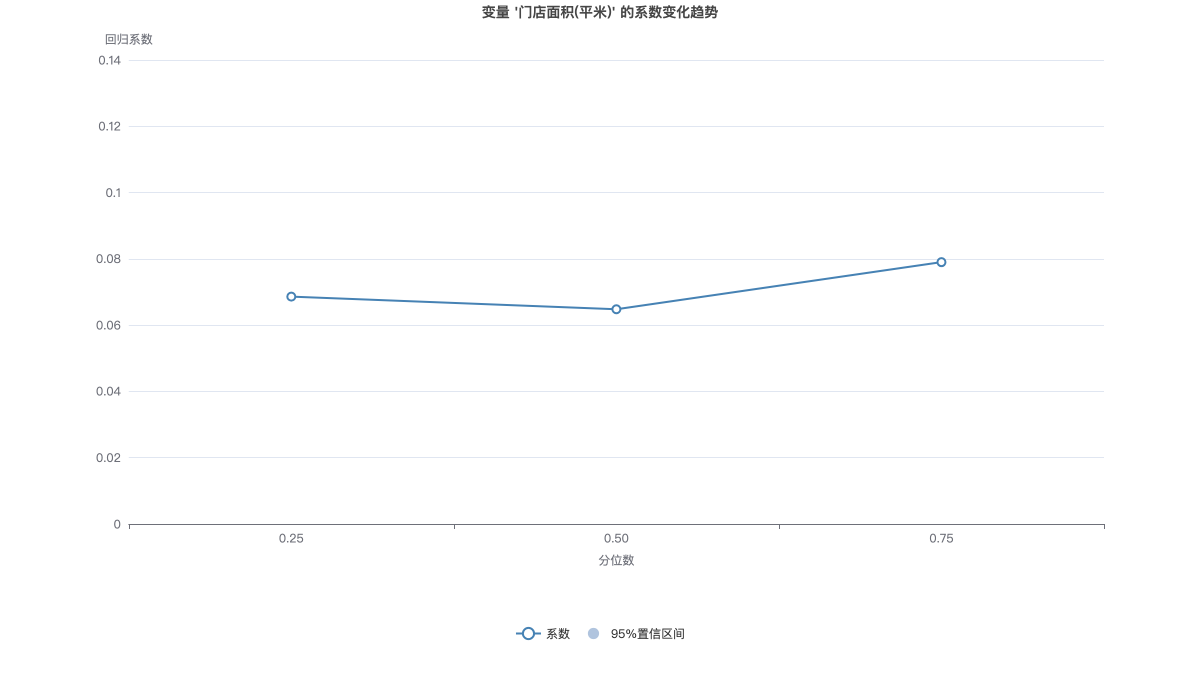
上图为每个变量(含常数)生成一张系数变化图。蓝线为回归系数,阴影区域为95%置信区间。您可以通过点击图表上方的标签页切换查看不同变量的图;也可用切换器改为「表格 / 柱状图」查看所有变量的系数随分位数变化的汇总。
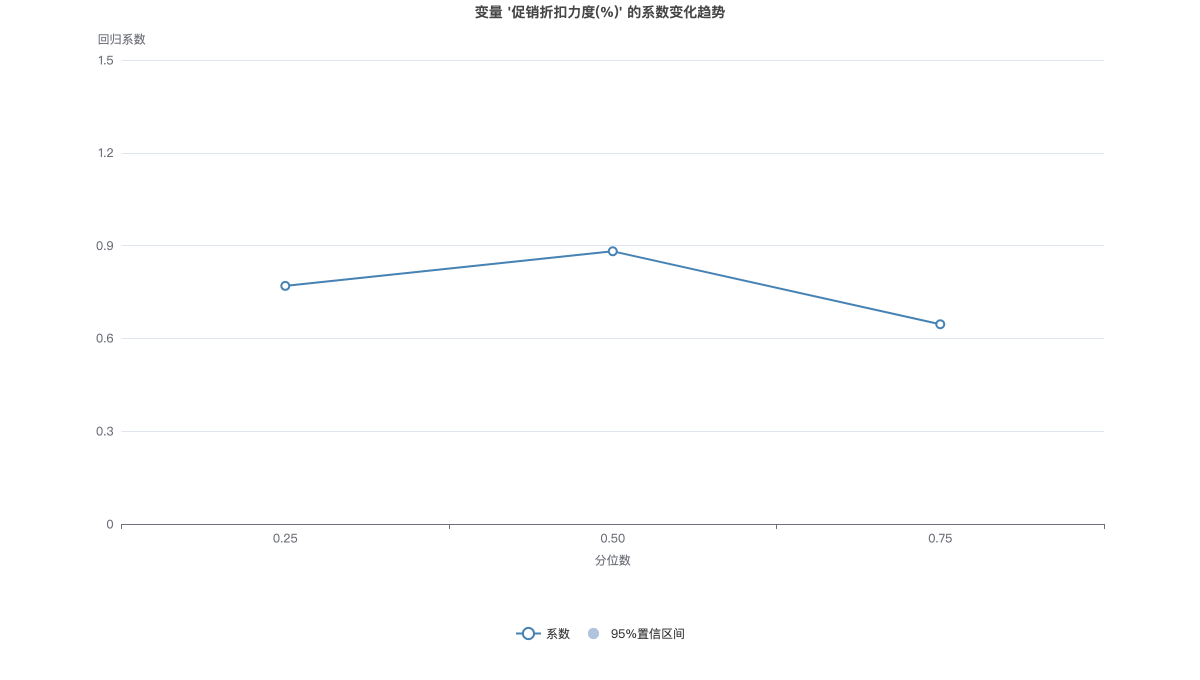
上图为每个变量(含常数)生成一张系数变化图。蓝线为回归系数,阴影区域为95%置信区间。您可以通过点击图表上方的标签页切换查看不同变量的图;也可用切换器改为「表格 / 柱状图」查看所有变量的系数随分位数变化的汇总。