
Deming回归
这个方法是做什么的
同一批样本用两种方法各测一次,问这两种方法能不能互换——这就是方法学比对。普通最小二乘假定 X 完全没有测量误差、只最小化 Y 方向的竖直残差,可两种方法都是“测量”,X 那一边同样有误差;这时 OLS 会系统性地把斜率往 0 压(回归稀释),于是本来一致的两种方法被判成有比例偏倚。Deming 回归同时考虑两个方向的误差,最小化到回归线的加权正交距离,这就是它存在的理由。
方法学比对的主结果不是“斜率显不显著”,而是两个特定的原假设:截距 = 0(无恒定偏倚)与斜率 = 1(无比例偏倚),卡② 专门列了这两行。报告同时给出 Deming 散点图(含 y = x 等同线)、Bland-Altman 差值图与 95% 一致性界限、Pearson r、Lin 一致性相关系数 CCC(含置信区间与分级),以及由回归方程推算的 P5/P25/P50/P75/P95 五个决定水平上的预期偏差与相对偏差。
需要准备什么数据
- (因变量Y):定量变量(数值)
- (自变量X):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 新方法 / 新仪器 / 新试剂盒与参考方法比对,判断能否替换或并行使用
- 两个实验室、两台设备测同一批标本,评估结果可比性
- 需要区分“整个量程上差一个固定值”(恒定偏倚)与“差距随浓度成比例放大”(比例偏倚)
- 需要一份符合 CLSI EP09 表述习惯、能写进方法学验证报告的结果
X 与 Y 必须是同一批样本按行一一对应的配对定量结果,成对删除缺失后至少 20 对(CLSI EP09 建议不少于 40 对),且测量值要覆盖足够宽的范围——量程太窄斜率就估不稳,卡① 会用极差与极差/均值给出判断。误差方差比 δ = σ²_Y/σ²_X 默认由“自动选择误差方差比”开关用样本方差之比近似;这个近似只在两法的分析变异与总变异成比例时才成立,严格做法是关掉开关、按各方法重复测量的精密度手工填 δ。
什么时候不要用它
- X 确实没有测量误差(配制的标准品浓度、设定的加样量、标称值):那是标准的回归情形,正交距离反而多此一举——用「线性回归 (最小二乘法)」。
- 只想描述两法差多少、差异范围有多宽,不需要拆成恒定与比例两种偏倚:用「Bland-Altman法」,它另有比值与差值百分比两种口径,还能设定允许的最大误差区间。
- 数据里有明显离群配对或误差分布偏态:Deming 的推断建立在正态误差上,对离群点不稳健;不作分布假定的 Passing-Bablok 本产品未提供,产品内可行的做法是先看卡① 的差值离群点诊断,用「缩尾处理(Winsorize)」压掉极端值后重跑并对比结论,再用「Bland-Altman法」核对偏倚量级是否一致。
- 要比对的方法多于两种,或每个样本被重复测量多次:本模块每次只收两列、每列一次测量——用「组内相关系数(ICC)」评估多次测量的一致性;带操作员与零件因素的测量系统分析用「量具GageR&R(测量系统分析)」。
- 两种方法给的是分类判读或等级(阳性 / 阴性、分级),不是定量值:用「Kappa一致性检验」;多个评价者对多个对象排序的一致性用「Kendall一致性检验」。
- 目的其实是“用 X 预测 Y”而不是判断两者能否互换:预测用的是条件均值,不需要正交口径——用「线性回归 (最小二乘法)」。
容易误读的地方
- δ 设错了,斜率就跟着错,比例偏倚的结论也跟着错。 δ = 1 表示两法精密度相同(此时退化为正交回归),δ 越大表示 Y 的误差相对越大、结果越趋近普通 OLS。自动模式用的是两列的总变异之比,而总变异 = 真值变异 + 测量误差,两者并不是一回事——描述统计表的表注专门标了这个警告。真要下方法学结论,应当用各方法重复测量得到的精密度(CV 或 SD)手工设定 δ。
- 系数表里的 p 值不是你要看的那个 p。 那张表检验的是“参数 = 0”:斜率显著不等于 0 在方法学比对里是必然的,毫无信息量;截距那一行倒是恰好等价于恒定偏倚检验。真正的主结果在下一张表——H₀ 是截距 = 0 与斜率 = 1,判定优先看置信区间是否覆盖 0 与 1,这与 p < 0.05 完全等价,但同时给出偏倚的量级范围。
- Pearson r 高不能作为两法可互换的证据。 r 只衡量点是否落在一条直线上,而一致性要求点落在等同线 y = x 上。一种方法系统性地是另一种的 2 倍时,r 仍然等于 1。CCC 才是同时衡量精密度与准确度的指标,报告把 r 与 CCC 并排给出就是为了让你比这两者的差距。
- 统计学显著的偏倚未必临床不可接受,不显著的也未必可接受。 样本量一大,几个单位的恒定偏倚就会被判显著;样本量小的时候,真正要紧的偏倚也可能藏在宽置信区间里。卡④ 把各决定水平上的预期偏差和相对偏差都算了出来,就是要你拿它们与本专业的允许总误差(TEa)逐一比较。本模块不预设任何 TEa 阈值——它依专业与项目而异,必须由你提供。
- 两法一致的结论只在你测过的浓度范围内成立。 描述统计给出了两列的最小值与最大值,回归线之外的推断没有数据支撑;量程太窄时斜率的置信区间会宽到无法判定比例偏倚,此时“未检出比例偏倚”很可能只是没检出来。散点若沿回归线呈喇叭形展开,提示测量误差随浓度增大,那种情况应当考虑加权 Deming,本模块给的是非加权版本。
- 配对关系本身没有任何检验能替你把关。 卡① 的最后一行明写着这一条“未做该检验”:X 与 Y 是不是同一批标本、行序有没有对齐,数据本身看不出来。两列一旦错位,上面所有偏倚、CCC 与 LoA 全部失效,而报告仍会照常输出一套漂亮的数字。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Deming 回归系数与偏倚检验
- 输出结果三:散点拟合图与 Bland-Altman 差值图
- 输出结果四:一致性效应量与决定水平上的偏差
- 输出结果五:结论与学术表述
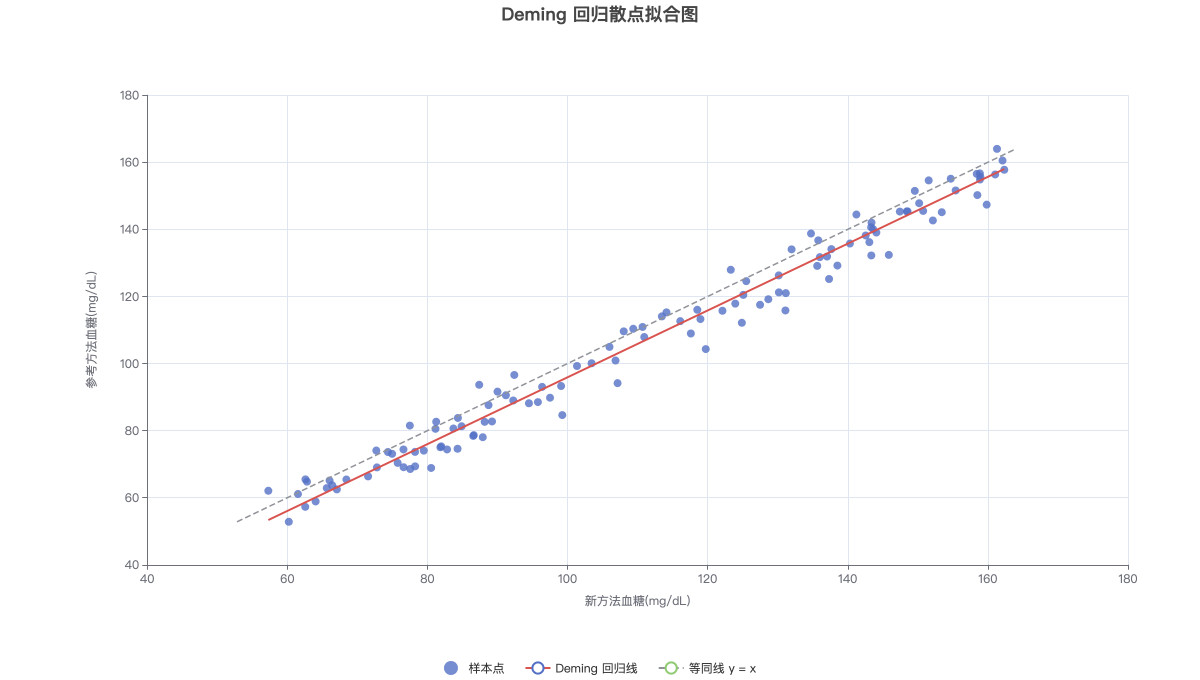
蓝点为 120 对实测值,红线为 Deming 回归线(参考方法血糖(mg/dL) = -3.6913 + 0.9959 × 新方法血糖(mg/dL)),灰色虚线为等同线 y = x(两法完全一致时所有点应落在这条线上)。
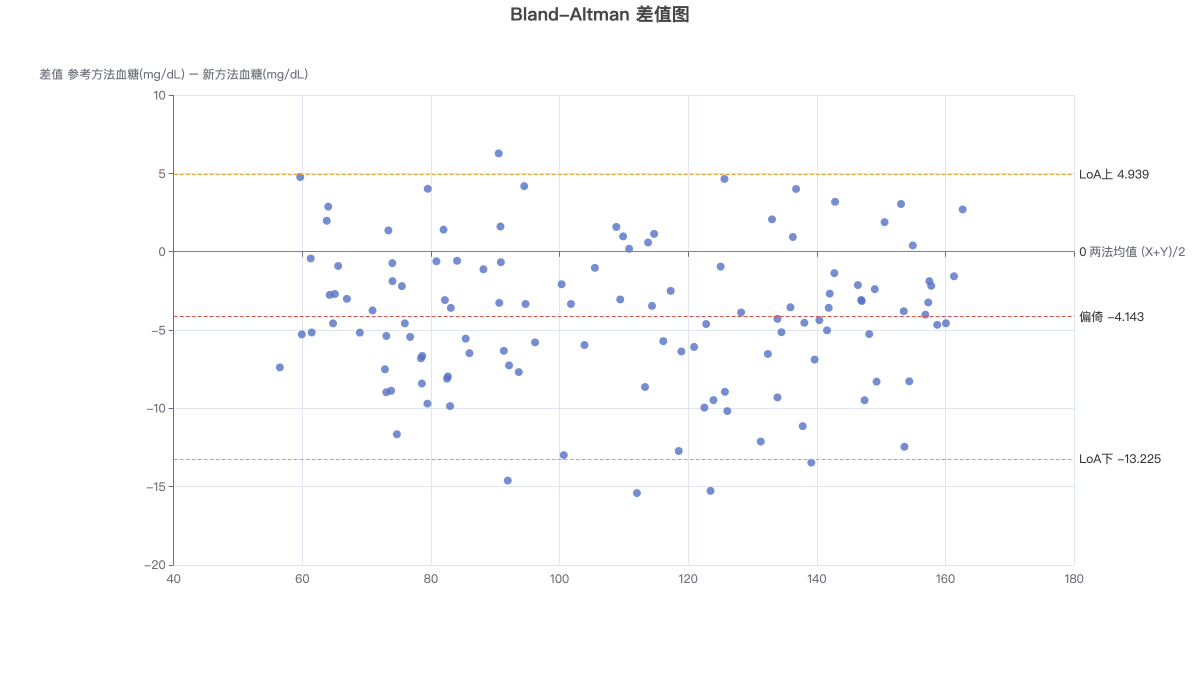
横轴为两法均值、纵轴为两法差值;红线为平均偏倚 -4.1430,橙色虚线为 95% 一致性界限(LoA = 偏倚 ± 1.96×SD = [-13.2253, 4.9393]),灰色点线为 0。