
季节性ARIMA模型
这个方法是做什么的
在 ARIMA 的基础上再挂一套季节项:非季节部分写作 (p,d,q),季节部分写作 (P,D,Q,m),m 是一个完整季节循环包含的期数(月度数据填 12、季度填 4)。D 阶季节差分处理的是“今年这个月与去年同月”的关系,与普通差分处理相邻期的关系互相独立。参数默认交给 pmdarima 的 auto_arima 按 AIC 逐步搜索,也可以关掉开关手工指定六个阶数。
卡① 会在九种差分组合上各做一次 ADF,作为 d 与 D 的定阶参考。卡④ 除常规的残差诊断外,用 MASE 和 Theil's U2 承担效应量的角色——基准是季节朴素法(用上一个周期的同相位值当预测),小于 1 才说明建模真的带来了增量。这个模块最需要留意的一处是卡③ 会明写“前 N 期没有拟合值”并拆开它的两个来源:差分燃烧期,以及状态空间扩散初始化下滤波器尚未收敛的热身期,取两者较大值。样本内的 R² 就是扣掉这些期之后算的——演示实测差分燃烧期 0 期、热身期 28 期,有效拟合期数 92 期,R²=0.8521。
需要准备什么数据
- 放入时间序列变量(可选):1 个,定量变量(数值)
- 放入时间变量(可选)(可选):0~1 个,定类变量(分组/标签)或定量变量(数值)
数据要求
- 数据表至少 48 行。
- 单列缺失率不超过 5%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 月度、季度这类有稳定年周期的销售、客流、用电量序列
- 已经用非季节 ARIMA 建过模,残差 ACF 在 12 或 4 阶处仍然显著
- 需要带 95% 预测区间的多期外推,且周期性必须体现在预测路径里
- 需要一套写进论文的完整定阶依据(多组差分 ADF + 信息准则)
前提是等间隔且季节相位对齐——中间缺失整行会让后续观测的季节相位整体错位,所以缺失容忍度只有 5%。至少 48 行,47 行会被直接拦下;但 48 行只是硬下限,要估计季节 AR/MA 项,样本应覆盖 3 到 4 个完整周期。拖入“时间变量”后模块会按它排序:把演示数据行序打乱重跑,输出逐字不变。
什么时候不要用它
- 序列没有固定周期:季节项估不出来只会白耗自由度,用「时间序列分析(ARIMA)」。
- 不打算建模,只想知道旺季淡季各偏离多少:用「季节分解模型」看逐相位季节指数。
- 要的是一条平滑外推曲线、不需要定阶与参数显著性:用「指数平滑模型」,它的 Holt-Winters 同样含季节项。
- 季节振幅逐年明显变化:固定阶数的季节项刻画不了漂移,先用「季节分解模型」确认漂移程度,或改用「时序滑窗特征」造特征后接回归。
- 周期长度未知:先用「谱分析」找出主导周期,再回来填 m。
容易误读的地方
- 样本内拟合优度对燃烧期口径极其敏感,这一处出过实际的教训。 燃烧期若只扣差分、不扣状态空间扩散初始化的热身期,前若干期会拿尚未收敛的滤波值去和真实值比,这个模块历史上就这样错过一次:同一份数据算出的样本内 R² 是 −2.4095、残差检验报出显著自相关,而扣掉热身之后是 R²=0.8521、残差无显著自相关——每一句结论都是反的。现在模块取两者较大值并在卡③ 写明期数与来源,读报告时先确认这一行,再看卡④ 的 R²。
- 摘要不会说,但卡⑤ 会说:优化器可能没收敛。 演示这次跑出来,卡⑤ 的“模型拟合”一行就带着一条警告:优化器在 50 次迭代后未收敛(statsmodels 默认迭代上限),意味着参数与信息准则都不是驻点值,而 auto_arima 的自动定阶正是拿这些未收敛的 AIC 比出来的。看到这条提示,结论要谨慎,可改用手工指定阶数或降低阶数后重试;只看摘要会完全错过它。
- auto_arima 只搜了模型空间的一部分,AIC 最小不等于真模型。 演示里卡① 的九种差分组合中 AIC 最小的是“1 阶季节差分”,而最终模型采用 d=0、D=0,两者不一致——卡① 的表注对此有说明:各行 ADF 回归的样本长度与被解释变量都不同,AIC 不可跨行直接比。定阶的最终依据是逐步搜索加残差诊断,不是卡① 那一列 AIC。
- 系数不显著的季节项照样会留在模型里。 演示的 SARIMA(4,0,0)×(2,0,2,12) 有 9 个模型系数(sigma2 是新息方差不计入),只有 4 个显著;剩下的 ar.L2 到 ar.L4 与两个季节移动平均项,p 分别落在 0.099 到 0.775 之间。ARIMA 族的阶数是一个整体设定,逐个剔除中间的滞后项会破坏平稳性与可逆性,所以不能看到不显著就删;但报告时要如实写出显著参数的个数。
- 模块以放宽约束的方式拟合,平稳/可逆性要另行核对。 卡② 表注写明拟合时关闭了 enforce_stationarity 与 enforce_invertibility 以提高收敛率,因此估计结果不保证落在平稳/可逆域内,需要看它给出的 AR 与 MA 特征根最小模(演示是 1.0096 与 1.0107,刚过 1)。这两个数贴着 1 时,长期预测的稳定性是可疑的。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:模型设定、系数与预测值
- 输出结果三:序列诊断与拟合预测可视化
- 输出结果四:预测精度效应量与残差诊断
- 输出结果五:结论与学术表述
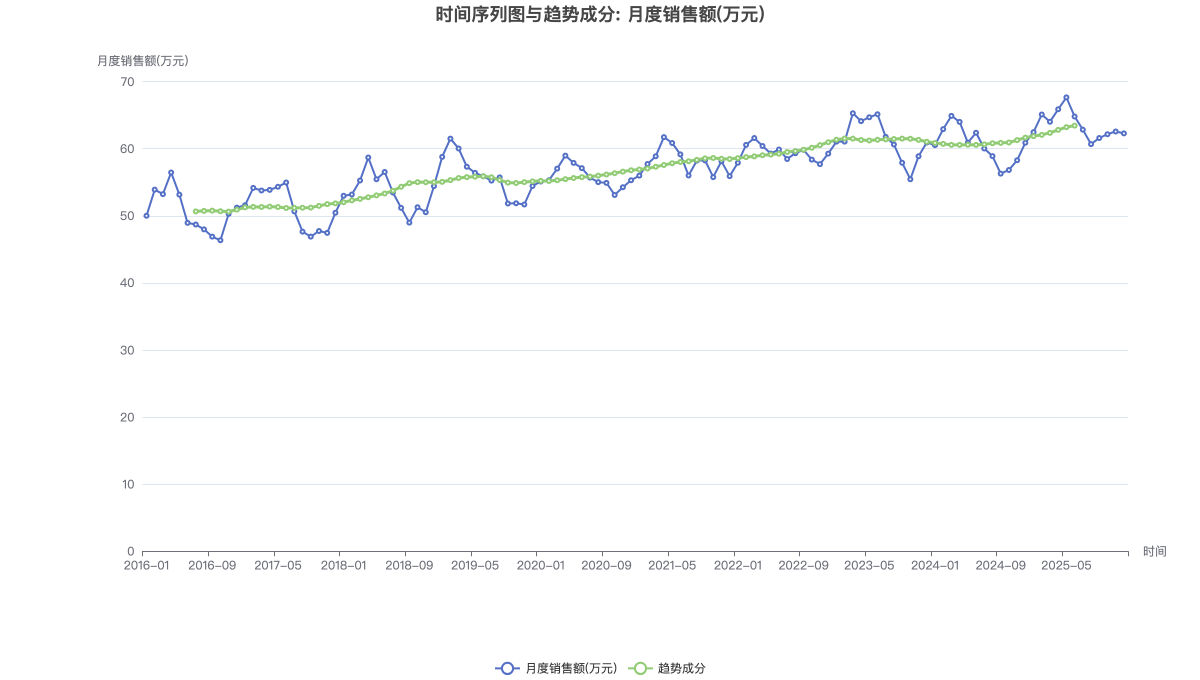
原始时间序列走势,叠加经典加性分解提取的趋势成分。
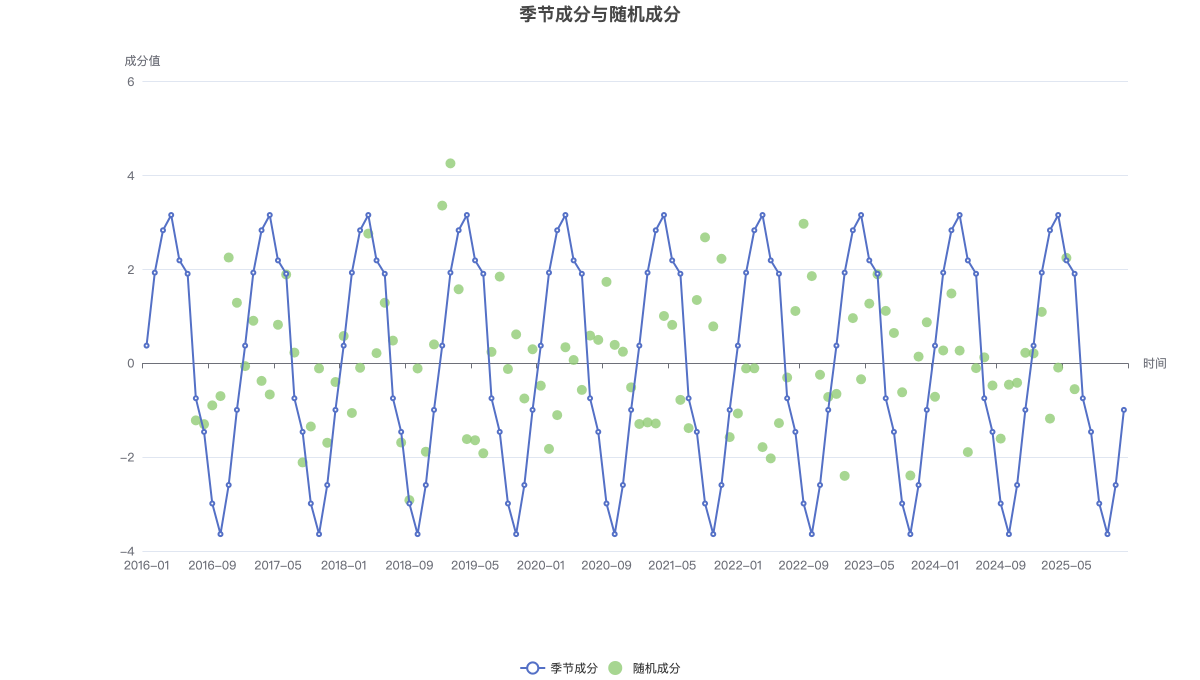
季节成分展示固定周期内重复出现的波动模式;随机成分是剔除趋势与季节后的不规则波动。
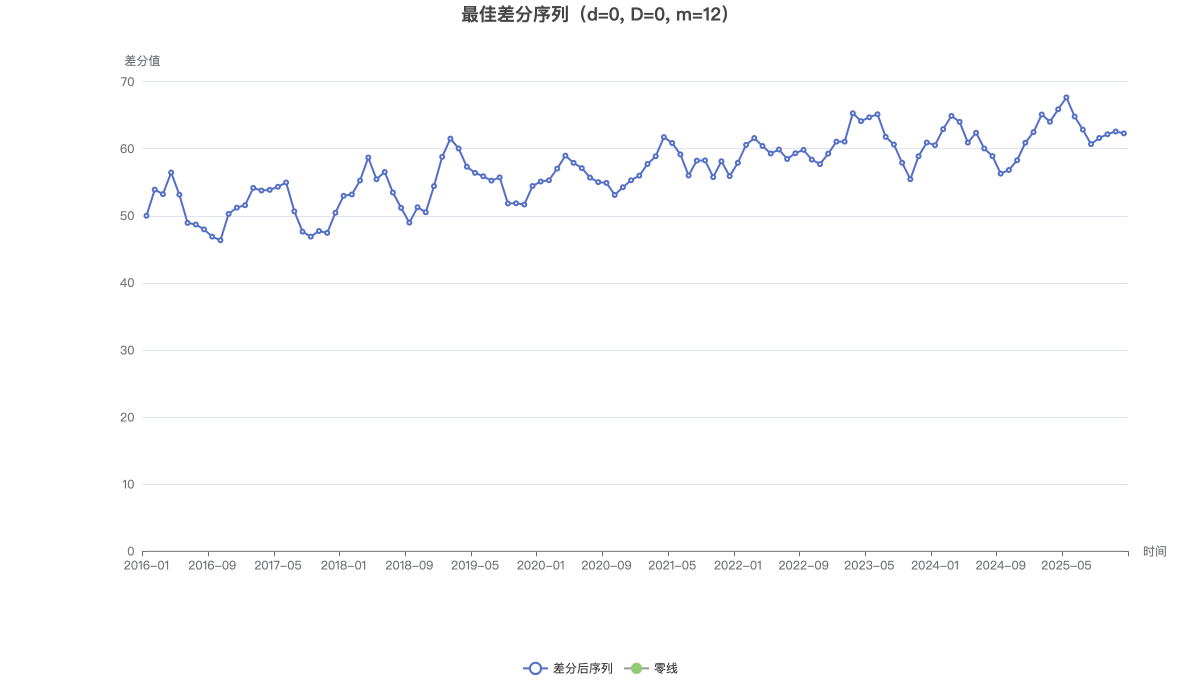
模型实际拟合所基于的平稳序列:原序列经 d 阶普通差分与 D 阶季节差分后的结果。
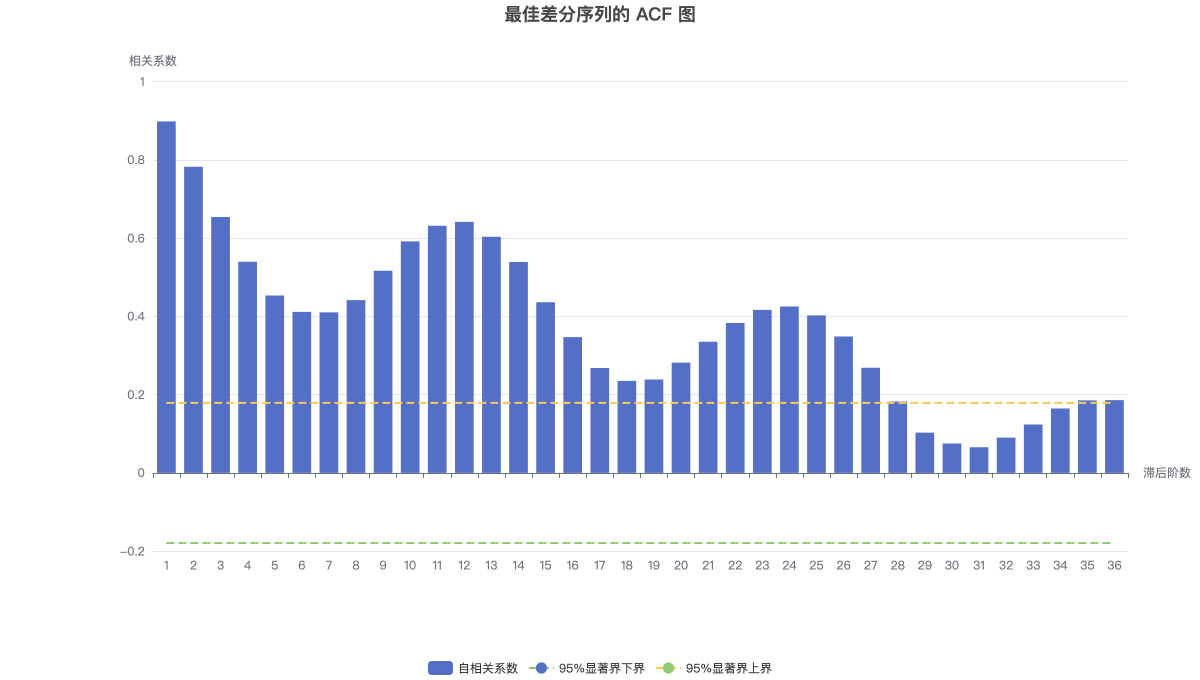
ACF 图显示差分后序列与其自身过去值的总相关;虚线为 95% 显著界。
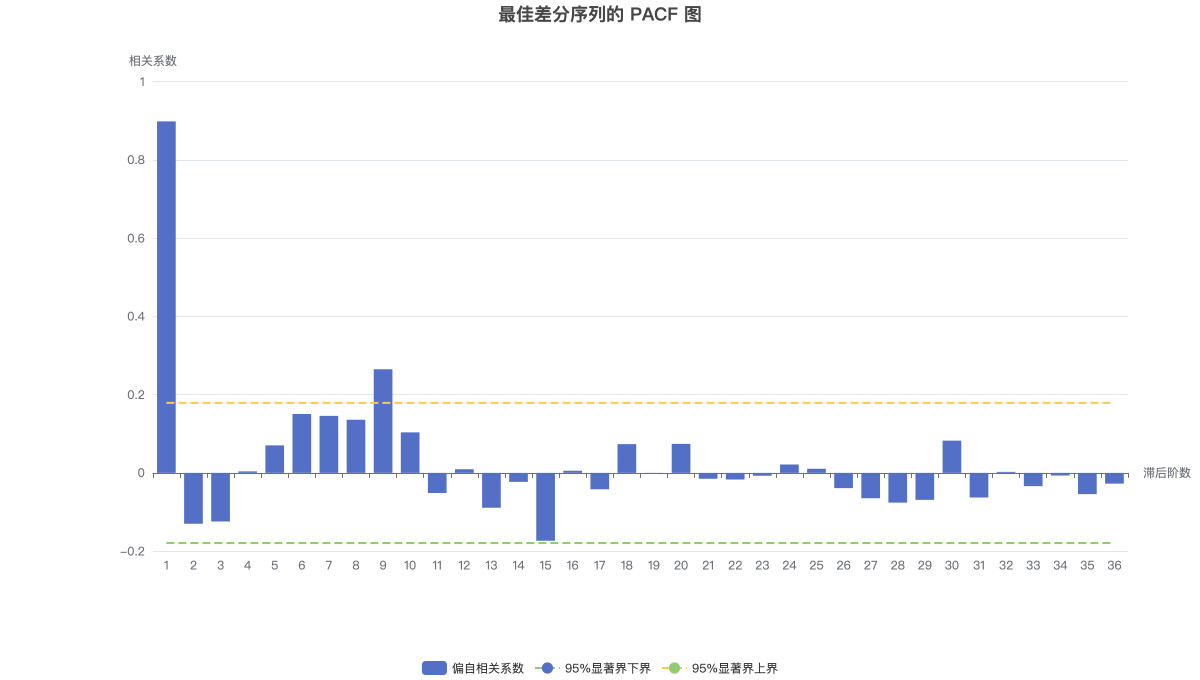
PACF 图剔除中间滞后项的传导,显示直接相关;虚线为 95% 显著界。
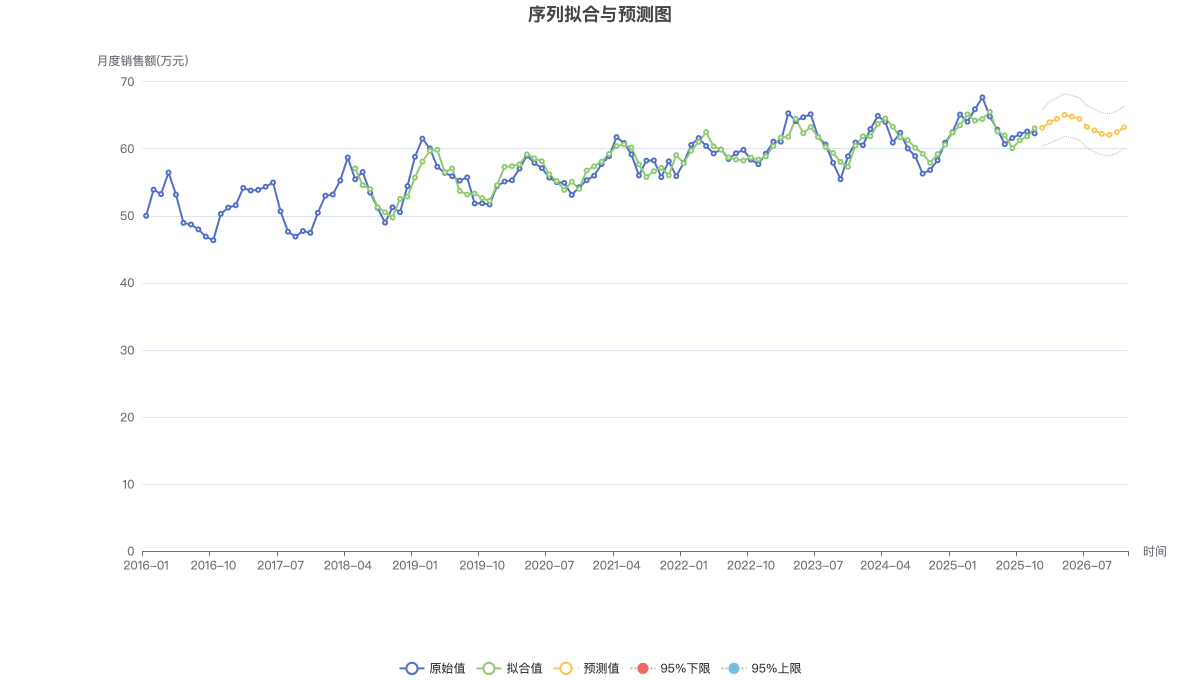
样本内拟合值、未来预测值与原始数据的对比,含 95% 预测区间。