
组内相关系数(ICC)
这个方法是做什么的
判断多位评价者(或同一台仪器的多次测量)给同一批对象打的定量分数,彼此有多一致。它的本质是一个方差比例:分子是被评对象之间的真实差异,分母是真实差异加上测量误差。所以对象越同质、误差越大,ICC 越低。数据要摆成宽表——一行一个被评对象,一列一位评价者。
除了 ICC 值和 95% 置信区间,报告还给出整套“这个数字能不能信、该怎么用”的材料:判断前提是否成立的 F 检验(对象之间是否真的有差异)、评价者主效应检验(谁打分偏松偏紧)、完整的方差分解表、六个 ICC 型号的横向对照,以及换算回原始量纲的测量标准误 SEM 与最小可检测变化 MDC₉₅——后者告诉你个体前后两次评分要差多少,才能排除测量误差认定为真实变化。它还会用 Spearman-Brown 公式反推“要把信度提到 0.90 需要几位评价者”。
需要准备什么数据
- 放入[定量]评价者评分列:2~50 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 多位阅片医师、评审专家对同一批对象打连续分数,评估评分者间信度
- 同一份量表隔一段时间对同一批人施测两次,评估重测信度
- 同一台仪器对同一批样品重复测量,评估测量系统的重复性
- 正式评审开始前做人数规划:在现有信度水平下需要几位评委才够
前提是数据摆成宽表:一行一个被评对象,一列一位评价者,且所有评分列来自同一量表、同一量纲,不同尺度的分数不能混算。另外被评对象之间必须真的存在差异——如果卡① 的 F 检验不显著,说明这批对象本身几乎没有区分度,此时 ICC 趋近 0,反映的是“对象太同质”而不是“评价者不可靠”。下方数据要求里的行数下限是技术下限;信度研究通常建议至少 30 个对象,否则置信区间会宽到没法下结论。
什么时候不要用它
- 评价者给的是类别而不是分数(阳性 / 阴性 / 可疑,合格 / 不合格):用「Kappa一致性检验」。
- 你只关心大家排出来的名次是否一致,不关心给分尺度(各位评委松紧差别很大,但谁好谁坏看法一致):用「Kendall一致性检验」。注意它要求的表方向与本模块正好相反——那边一行是一位评分者、一列是一个被评价对象。
- 列是问卷题目而不是评价者,你想问的是一份量表内部若干道题是否在测同一个东西:用「信度分析」。
- 比较的是两种测量方法(新仪器与金标准、两个问卷版本):ICC 只回答一致不一致,说不出偏差有多大、又随分数水平怎么变,用「Bland-Altman法」。
- 要把测量误差拆成零件、操作员与两者的交互(工业测量系统分析):用「量具GageR&R(测量系统分析)」。
- 你要问的是“各评价者的平均分有没有差别”而不是“一致不一致”:那是差异性问题,用「重复测量方差分析」。
容易误读的地方
- ICC 有三种模型,报告里不写型号等于没报。 顶部的“ICC类型”下拉默认选中“双向随机 - 绝对一致 (ICC2)”,另两个选项是“双向混合 - 一致性 (ICC3)”和“单向随机 - 绝对一致 (ICC1)”。三者的区别只在于什么算误差:ICC(2,·) 把评价者视为从评价者总体中随机抽出,并把系统性偏倚计入误差(绝对一致);ICC(3,·) 把这几位评价者视为固定的,不惩罚系统性偏倚(只看排序一致);ICC(1,·) 只适用于“每个对象由不同的评价者评分”的设计。每种模型又各自输出“单个测量”与“平均测量”两行,所以第四张卡把六个型号一起列出来并标出本次选用的两行,就是为了让你看到模型选错会差多少。选型号不是挑数值大的,而是由你的设计决定:评价者是不是随机抽来的、你在不在乎打分宽严的系统偏差。
- “单个测量”和“平均测量”不能挑好看的那个报。 平均测量 ICC 必然不低于单个测量——它把 k 位评价者的平均分当成一次测量,误差被平均掉了一部分。差距可以很大:示例中单个测量 ICC = 0.884、平均测量 ICC = 0.958,一个落在“良好”档、一个落在“极好”档。报哪个取决于将来怎么用:今后由一个人独立打分,就必须报单个测量;今后确实使用这 k 位评价者的平均分,才可以报平均测量。
- 判断达标要看置信区间下限,不是点估计。 报告按 Koo & Li (2016) 的 0.5 / 0.75 / 0.9 三档给出信度等级,而这三档应当对照 95%CI 的下限做保守判断。对象数少的时候点估计可能很漂亮,区间却宽得跨了两档,这种结果不能写成“信度极好”。
- 主结果表里的 F 检验显著,不是“一致性好”的证据。 它的原假设是 ICC = 0,也就是被评对象之间毫无真实差异——这是个极低的门槛,只要对象有点区分度就会显著,和一致性高低没有关系。它的用途是反向的:F 不显著说明前提已经塌了,此时的 ICC 数值不必再解释。真正说明一致性的是 ICC 本身与它的区间。
- ICC 是这批样本的属性,跨研究比较之前必须先比样本的变异范围。 同一份量表用在更同质的人群上,ICC 必然更低,因为分子就是对象之间的真实方差。所以别人论文里报告的 ICC 不能直接搬来当自己数据的信度。还有一层边界:ICC 衡量的是一致性与可重复性,不是准确性——所有评价者完全可能一致地偏离真值,那种情况下 ICC 依然很高。要评估准不准,只能拿金标准来比。
ICC 的格子里是分数、Kappa 是类别、Kendall 一致性检验是名次;前两者一行一个被评对象、一列一位评价者,Kendall 恰好相反。表拖反了不会报错,只会算出一个几乎为 0 的 W。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:组内相关系数(ICC)主结果表
- 输出结果三:一致性可视化
- 输出结果四:效应量与测量精度分析
- 输出结果五:结论与学术表述
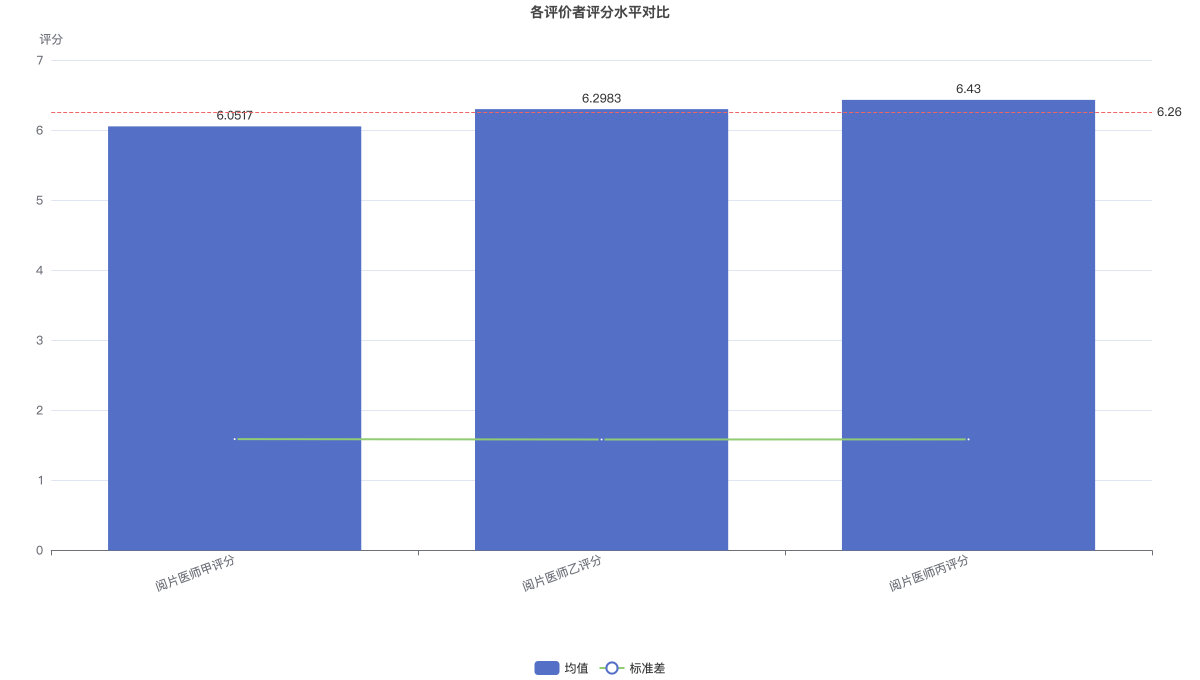
该图对比 3 位评价者的评分水平:柱为各自的均值,红色虚线为总均值 6.260,绿线为各自评分的标准差。
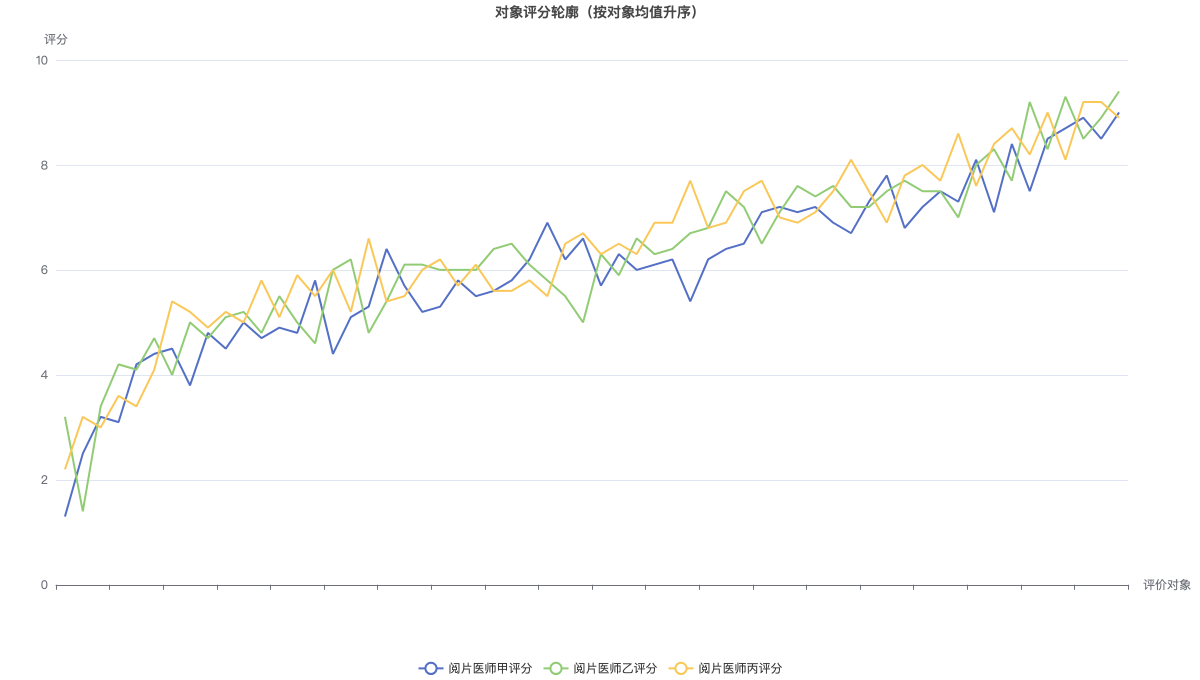
该图把评价对象按均值升序排列,每条折线是一位评价者的评分轨迹。折线越贴合、越同步上升,说明评价者之间的一致性越好。