
t-SNE降维可视化
这个方法是做什么的
把多个定量特征压到二维画成一张散点图,让你用眼睛看样本有没有聚集倾向。降维前统一做 StandardScaler 标准化——t-SNE 靠欧氏距离工作,不标准化的话结果由单位选择决定。可选拖入一个定类变量给点着色。困惑度在控件里设(默认 30),模块要求它小于 n/3 并会按样本量自动裁剪。
它不止给图,还给这张图"有多可信"的量。第二张卡:三个近邻规模下的 trustworthiness(图上看着相邻的点在高维里是否真的相邻)、KL 散度、高低维成对距离的 Spearman 秩相关及其 bootstrap 95%CI——这个区间只在 n ≤ 700 时算,样本更多时只给点估计并在同一行注明原因。第四张卡:kNN 邻域保持率与"随便摆点"的随机基线 k/(n−1) 之比(这是本模块的效应量);换一个随机种子重跑一次、比较两次嵌入 k 近邻集合的 Jaccard 重合率;有着色变量时再给二维坐标上的轮廓系数、Calinski-Harabasz、Davies-Bouldin 与组间/组内平均距离比。全篇没有 p 值,t-SNE 不检验任何假设。
需要准备什么数据
- 放入[定量]降维特征:至少 3 个
- 放入[定类]着色分组(可选)(可选):不限
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]着色分组(可选)」的类别数需在 2~20 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 十几个指标描述一批样本,想先看一眼有没有自然分群的迹象
- 聚类之前的探索:大致有几团、哪些点游离在外
- 已有分组标签,想直观看看这个分组和特征空间的结构合不合
- 高维数据的初步质检:明显的孤立点、重复样本往往在图上一眼可见
前提是至少 3 个定量特征、列表删除缺失后至少 10 个完整样本、无常数列,样本量上限 5000。着色变量须为定类且不超过 20 类,否则图读不出来。
什么时候不要用它
- 你要的是每个样本属于哪一群的结果:t-SNE 只给坐标、不给归属,用「聚类分析(K-Means)」;形状不规则或要识别噪声点用「密度聚类(DBSCAN)」;类别与数值混合用「二阶聚类」。别选「分层聚类」——本产品的它是 R 型的,聚的是变量不是数据行。
- 你要可解释的降维维度(每个维度由哪些变量构成、解释了多少方差):t-SNE 的两个轴没有载荷也没有方差解释率,用「主成分分析(PCA)」;要可解释的潜在结构用「因子分析(探索性)」。
- 你要论证几个组在特征上确实分得开:这是推断问题,必须回到原始特征空间做,用「线性判别分析」,或建一个有交叉验证的分类模型再看「ROC曲线分析」。
- 你要看的是分类变量之间的对应关系:用「对应分析」,多个分类变量用「多重对应分析」;已有距离或相似度矩阵用「多维尺度分析(MDS)」。
- 样本超过 5000 会被直接拒绝:先聚合或抽样,或者改用能吃大样本、结果又确定的「主成分分析(PCA)」。
容易误读的地方
- 簇之间的距离和簇的大小,在 t-SNE 图上没有意义。 两团离得远不代表它们差异大,一团看着松散也不代表组内异质。t-SNE 的目标函数只保证局部邻域概率分布尽量还原,全局几何是被牺牲掉的——这正是报告同时给 trustworthiness(局部)与距离秩相关 ρ(全局保序性)的原因,后者通常明显低于前者,那是常态不是故障。图上唯一能读的信息是"谁和谁挨在一起",坐标轴的数值、方向、正负都不要解释。
- 换一个随机种子,图形就会变。 t-SNE 是随机算法,模块把主嵌入的种子固定为 42 以保证同一输入可复现,另用种子 2026 重跑一遍算 Jaccard 重合率作对照。这个对照有明确边界:两次运行都用 init="pca" 的确定性初始化,所以它检验的只是梯度优化过程的随机性,不含初始化的随机性;结构清晰的数据上重合率常常接近 1.00,那是预期结果,不能读成"这张图在任何设置下都稳"。要一并检验初始化敏感性,得改用随机初始化重跑,本模块不做这件事。还有一条规模门槛容易漏看:n > 1500 时这项对照整个不做,稳定性表标"未做"并写明本次没有对嵌入稳定性作出任何判定——而模块能收下 5000 个样本,所以 1500 到 5000 之间跑出来的图,稳定性是一次都没查过的。
- t-SNE 会在完全没有结构的数据上造出看起来很干净的簇。 这是它最危险的性质:把纯随机的高维噪声喂进去,二维图上照样会出现几团分明的点。所以第四张卡那几个分离度指标——轮廓系数、CH、DB、组间组内距离比——全都是在二维坐标上算的,它们回答的只是"这张图里这些组分不分得开",绝不能用来论证"这些组在原始特征空间中真的可分"。报告的表注专门标了这条边界。
- 困惑度是超参数,改了图就变,不报参数就不可复现。 它大致相当于"每个点考虑多少个邻居":小困惑度突出局部碎片、容易把一团拆散,大困惑度偏向整体形状、容易把小群吞掉。模块要求它小于 n/3 并会自动裁剪后在第一张卡告知生效值。论文里必须同时报告困惑度、随机种子与标准化方式,否则别人拿不到同一张图。
- 图上的"距离"是标准化之后的距离,原始量纲已经被抹掉了。 模块强制做 StandardScaler,示例里各特征原始标准差最大与最小相差 32 倍,不标准化的话距离几乎完全由那个大量纲特征决定。代价是每个特征在距离里的权重被拉平了:一个测量噪声很大的无关变量,标准化后与核心变量同等重要。特征之间高度冗余时也一样——两个 |r| 接近 1 的特征等于把同一份信息计入两遍,第一张卡的最大 |Pearson r| 那行就是提示这件事的。
- 邻域保持率要和随机基线一起读。 0.6878 这个数字单看不知道好坏,关键是随机摆点的基线只有 0.0279,两者之比 24.62 倍才是"降维确实保住了结构"的依据。基线随 k/(n−1) 变化,所以不同样本量下的保持率不可直接比较,比较的应当是倍数。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:降维质量指标
- 输出结果三:t-SNE 二维散点图
- 输出结果四:结构保持、嵌入稳定性与分组分离度
- 输出结果五:结论与学术表述
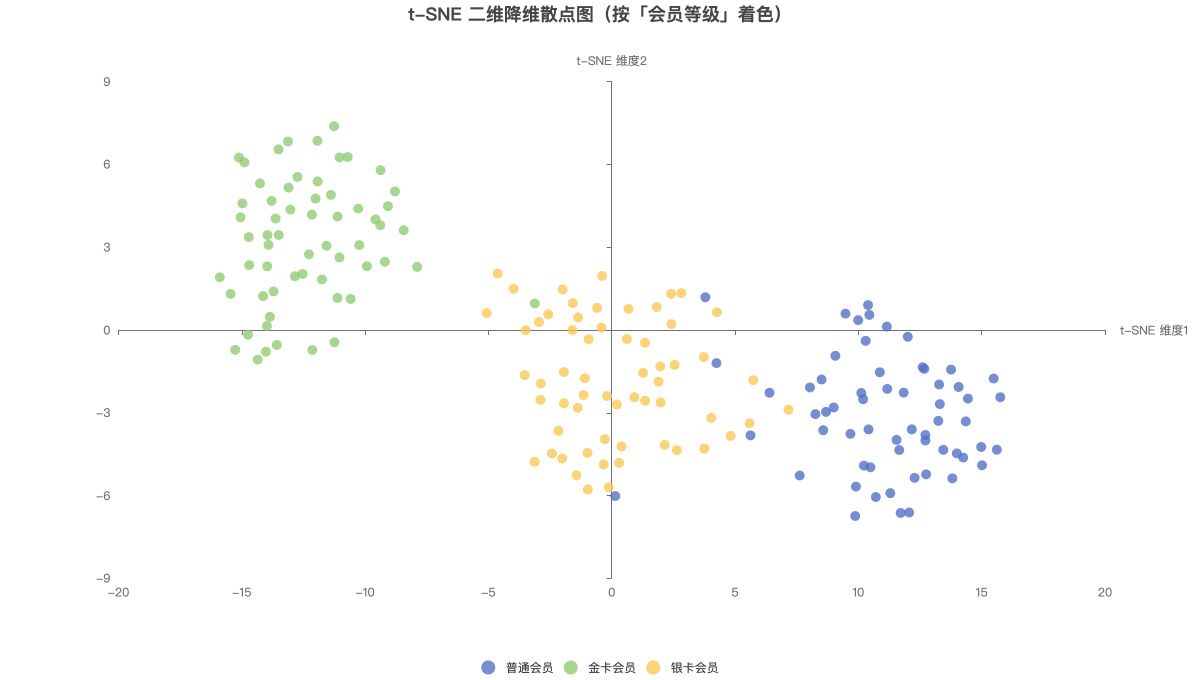
每个点为一个样本在 t-SNE 二维空间的位置;彼此靠近的点在原始高维特征上更相似。 可用右上角切换器切到「表格」读取二维坐标。