
竞争风险模型
这个方法是做什么的
竞争事件指的是“一旦发生,就使你关心的那个事件不可能再被观察到”的其他结局——研究肿瘤特异死亡时的非肿瘤死亡、研究移植后排斥时的术前死亡、研究出院时的院内死亡都属于这一类。把竞争事件当成普通删失处理,等于假装这些人以后还有机会发生主要事件,结果是系统性高估主要事件的累积发生率。本模块用 Fine-Gray 子分布风险模型估计协变量对累积发生率的影响,用 Aalen-Johansen 估计量画累积发生函数 CIF。
结局列必须编码成 0=删失、1=主要事件、2=竞争事件,且 1 与 2 都要真实出现。除子分布风险比 sHR 及其 95% 置信区间外,报告给模型整体 Wald 检验、每参数事件数 EPV、各列 VIF、Holm 校正后的 p、sHR 森林图、各类结局的例数构成,以及随访终点处主要事件与竞争事件各自的累积发生率(示例 0.6029 与 0.2608)。第一张卡还专门核对“确有竞争事件”这一条——竞争事件占比可忽略时,用这个模型本身就是多余的。
需要准备什么数据
- 生存时间变量 T:定量变量(数值)
- 结局事件变量 E:定量变量(数值)
- 协变量 X(可选):定量或定类变量
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「结局事件变量 E」的类别数需在 2~5 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 研究某一类死亡原因,而队列中有相当比例的人死于其他原因
- 研究某个必须“活着才能发生”的事件(再入院、二次手术、移植后排斥)
- 需要报告绝对风险:“5 年内发生该事件的概率是多少”
- 已经跑过生存分析,审稿人要求补竞争风险的敏感性分析
数据要求:至少 30 行、缺失比例不超过 20%、不允许常数列;随访时间为正的定量列;结局列必须是数值列,取值落在 {0, 1, 2} 内。经验准则是主要事件数至少为待估参数个数的 10 倍(示例 EPV=95/2=47.5)。删失仍须是无信息删失——Fine-Gray 的 IPCW 权重正建立在这一假定之上,统计上无法检验,由研究设计保证。
什么时候不要用它
- 压根没有竞争事件,只有事件与删失:Fine-Gray 没有用武之地,多因素分析用「Cox比例风险回归」。
- 只有一个分组变量,你要的是曲线和中位生存时间:用「Kaplan-Meier生存分析」——前提是确认没有竞争事件,否则它的 1−KM 会高估。
- 研究目的是病因机制而不是风险预测:这时该看的是特定原因(cause-specific)的瞬时风险比,把竞争事件按删失处理、改用「Cox比例风险回归」,并在文中写明用的是 cause-specific 口径。
- 只想描述各类结局的例数与构成比、不做回归:用「列联(交叉)分析」。
- 数据是配对或精细分层的病例对照,结局没有时间维度:用「条件逻辑回归」。
容易误读的地方
- sHR 与 cause-specific HR 不是同一个量,论文里必须写清楚报的是哪一个。 卡①与卡④两处结论文案都点了这件事:sHR 刻画的是对累积发生率的影响,cause-specific HR 刻画的是对瞬时风险的影响,两者可以方向一致而大小不同。更容易被忽略的是 sHR 的风险集——已经发生竞争事件的个体被 IPCW 权重保留在里面,所以 sHR 不能读成“某人尚未发生任何事件时的瞬时风险比”,那是 cause-specific 的含义。
- 模块不检验子分布比例风险假定,卡①那六条前提里没有一条是它。 卡①查的是结局编码合法、确有竞争事件、时间为正、EPV、删失、共线性;子分布风险是否成比例完全没查。卡⑤的局限性说明如实写着“本模块暂未提供子分布比例风险的诊断检验,建议辅以分层 CIF 曲线目视核查”。这一点和「Cox比例风险回归」不同——那里有 Schoenfeld 残差检验,不要把两个模块的前提检验混着记。
- 结局编码错一位,报告照样出结果,只是全错。 必须严格 0=删失、1=主要、2=竞争。把竞争事件误编成 0,模型会照常收敛、CIF 照常画出来,得到的却正是那个被高估的口径;反过来把删失编成 2,竞争事件的 CIF 会被凭空抬高。卡①有一行“其它编码”专门统计落在 {0,1,2} 之外的记录数,先看它是不是 0。
- CIF 用的是 Aalen-Johansen,不是 1−KM,两者不能混用。 卡③的图注写明:Aalen-Johansen 的分母是全因生存函数,因此各类事件的 CIF 之和加上生存概率恒等于 1;而把竞争事件当删失后逐类算 1−KM,各类加起来可以超过 1,这是竞争风险文献里最经典的悖论。报告绝对风险时只能引用卡③的这条曲线。
- sHR 大不等于绝对获益大。 卡④的表注写得很直接:“大 sHR 叠加低基线风险,绝对获益仍可能很小。”“累积发生风险变化”那一列是 (sHR−1)×100% 的相对变化,不是绝对风险差。要谈绝对量,回卡③的 CIF 或卡④“队列层面的绝对风险”两行去读。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Fine-Gray 子分布风险模型主结果表
- 输出结果三:可视化(累积发生函数与结局分布)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
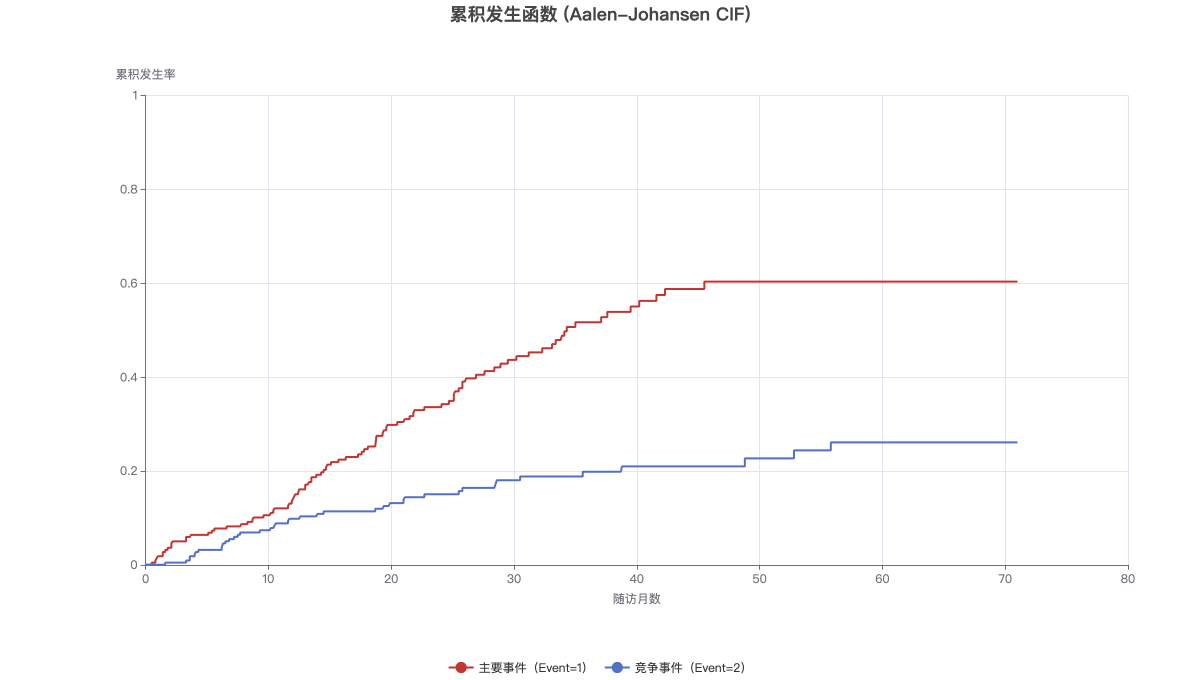
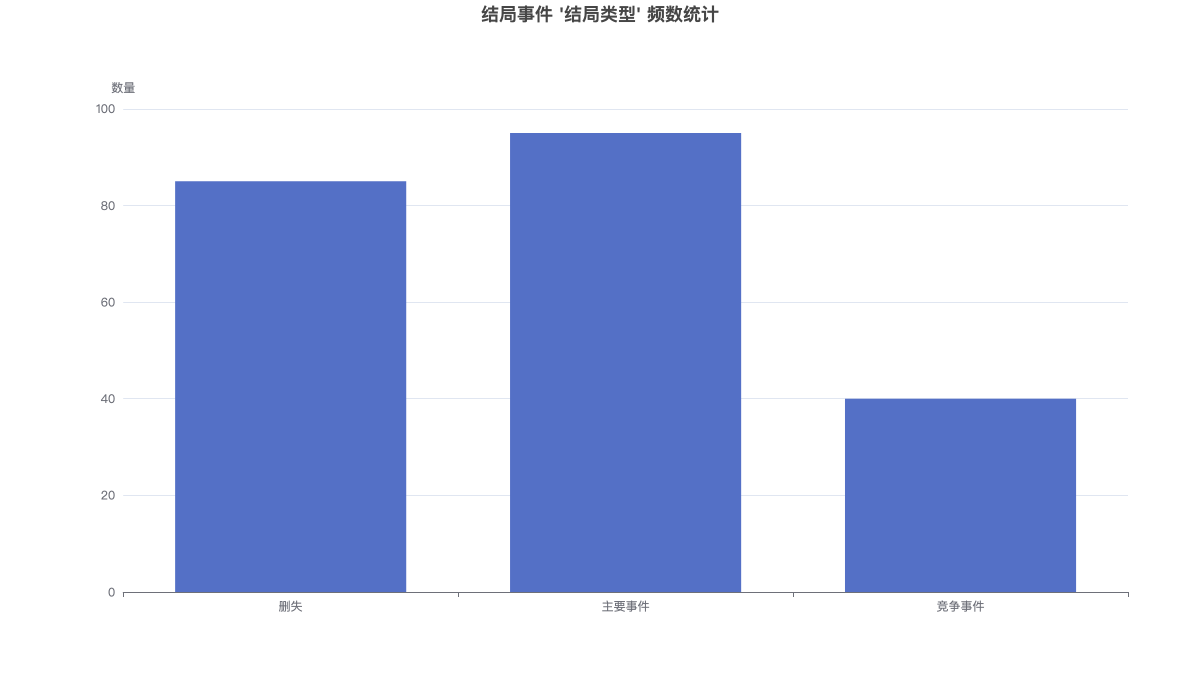
CIF 曲线用 Aalen-Johansen 估计量绘制:CIF_k(t)=Σ S(t⁻)·d_k/n,分母是全因生存函数,因此各类事件的 CIF 之和 + 生存概率恒等于 1,不会像「1−KM(把竞争事件当删失)」那样出现总和超过 1 的悖论。可用切换器在折线图/柱状图/里程碑时点表之间切换。
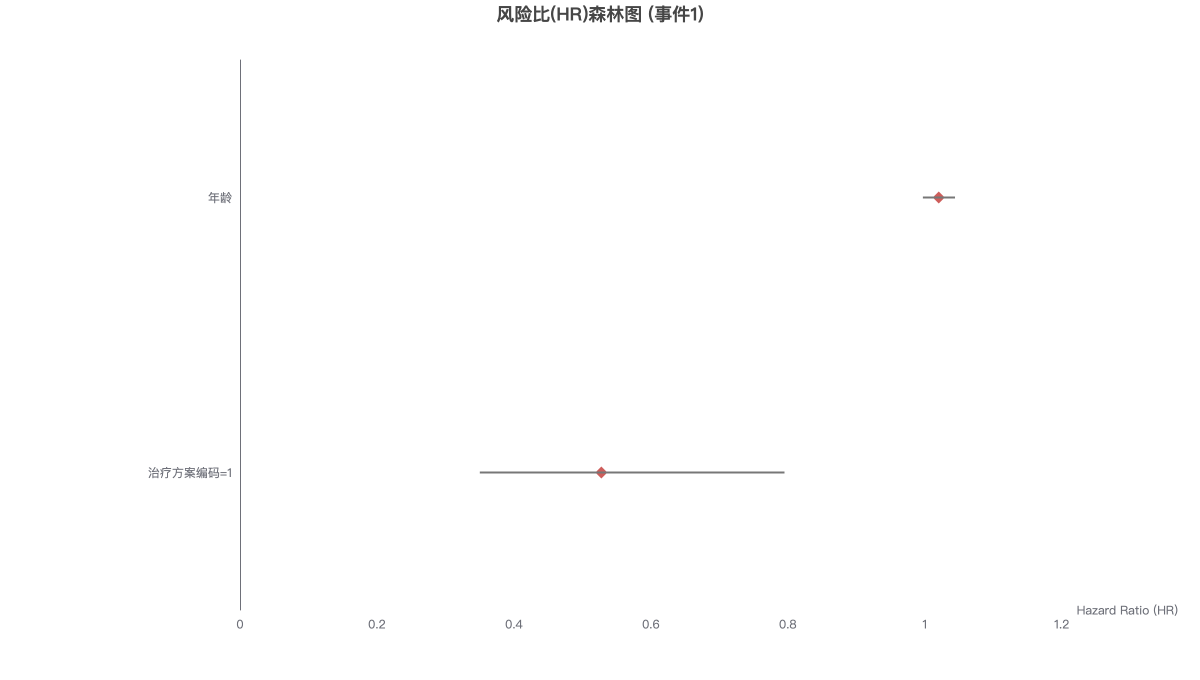
图表说明:森林图以图形方式展示了模型系数表中各协变量的风险比(HR)及其95%置信区间。