
多维尺度分析(MDS)
这个方法是做什么的
把一批对象两两之间的“远近”还原成一张平面图:原始距离大的对象在图上画得远,距离小的画得近。输入有两种,由控件“数据格式”决定:一种是给它一张普通数据表、由它算欧氏距离(此时还要选分析对象是列上的变量还是行上的样本),另一种是你已经有一张对象两两之间的距离方阵,直接选“数据为距离矩阵”。它常被用来画品牌、产品或属性的知觉定位图。
因为是把高维距离硬压到二维,一定会有损失,所以报告的重心是拟合诊断。卡② 给 Kruskal Stress-1(示例 0.1679,按 Kruskal 基准属“勉强”)、距离解释率 DAF、Tucker 一致性系数 φ,以及原始距离与再生距离的相关 r 及其“删一对象”jackknife 置信区间,并用 Mantel 置换检验(B=999)判断这个构形是否比随机排布更贴合原始距离。卡③ 有 Shepard 图与 Stress 随维数变化的曲线;卡④ 逐对象、逐距离对定位局部失真。
需要准备什么数据
- 放入分析变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 品牌 × 属性的知觉图、产品相似度定位图这类需要“一张图看关系”的场景
- 手上已有一张相似度或相异度方阵(专家两两评分、混淆矩阵、共现距离),想把它可视化
- 想看一组量表题项在几何上是否分成几簇(分析对象选变量)
- 想把受访者按其在多个指标上的取值摊到平面上(分析对象选样本)
前提:若由数据计算距离,参与列必须全部是定量数值,文本类别请先转成数值;至少 2 个变量。若数据本身是距离矩阵,必须行列数相等、对称、对角线为 0、元素非负——卡① 会逐条实测给出偏差量。二维构形的稳定性依赖对象数量,Kruskal 的经验准则是对象数不少于 4×维数+1,即二维至少 9 个对象。
什么时候不要用它
- 对象是分类变量的类别(品牌 × 形象词这类交叉表):距离要从列联表的卡方距离来定义,用「对应分析」;三个及以上定类变量用「多重对应分析」。
- 你要的是可命名的潜在维度(“价格导向”“品质导向”):MDS 的坐标轴没有含义、不可命名,要提取并解释潜在构念请用「因子分析(探索性)」,只做正交降维用「主成分分析(PCA)」。
- 目的是把对象分成若干组并拿到组标签:MDS 只给坐标不给分组。分析对象是样本(行)时用「聚类分析(K-Means)」直接得到类别;分析对象是变量(列)时才轮到「分层聚类」——本产品的它是 R 型的,聚的正是变量,拿它去分样本会答非所问。
- 样本量很大、只想看高维数据里的局部邻域结构:MDS 保的是全局距离,样本多时构形拥挤,用「t-SNE降维可视化」。
- 只想知道两个变量之间关联有多强:一个相关系数就够了,用「Pearson相关性分析」,非线性或定序用「Spearman相关分析」。
容易误读的地方
- 默认分析的是“变量”而不是“样本”,对象数因此常常不够。 控件“分析维度”默认按变量(列):示例拖入 6 个变量就只有 6 个对象,卡① 的前提表当场判定不满足 Kruskal 准则(二维要求 n≥9),并写明“自由度过少会使 Stress 人为偏低,此时低 Stress 不能作为拟合好的证据”。同一份数据切到按样本(行)分析,n 变成 200、该条前提转为满足,Stress-1 也从 0.1679 变成 0.1870。选错分析对象,整张图回答的就不是你的问题。
- DAF 与 Tucker φ 天生比 Stress 好看,因为三者是同一个残差量的不同写法。 φ=√DAF=√(1−Stress-1²):示例 Stress-1=0.1679 只算“勉强”,而 DAF=0.9718、φ=0.9858 看着接近完美。模块的结论句直接写明判断拟合优劣请以 Stress-1 为准。只挑 φ=0.986 写进论文,是这三个指标最常见的误用。
- 整体 Stress 低,不排除个别对象或个别距离对被严重扭曲。 卡④ 的两张事后表专治这件事:逐对象看 Stress 贡献占比(均分基准是 1/n,示例 16.67%,达到 1.5 倍判为拟合较差),逐对看残差方向。示例失真最严重的是“产品体验Q2”与“产品体验Q3”,原始距离 13.3791、再生距离 8.6536,也就是图上把它们画得比实际更近。解读构形时要主动避开这几对的相对远近。
- 坐标轴没有固有含义,不要给“维度1”“维度2”起名。 坐标表的表注写明 MDS 解在旋转、反射、平移下等价,解释时只看点与点的相对远近与聚簇结构。卡⑤ 进一步提示:若要给维度赋予实质解释,需另行用外部变量对坐标做回归或结合领域知识,算法本身给不出。把两个轴当成因子来命名,是从对应分析或因子分析带过来的习惯性错误。
- 量纲差异会主导欧氏距离,而这一条不会被任何前提检验拦下。 前提表最后一行的判定写的是“不适用”——MDS 确实没有分布假设——但同一行的说明里写着“量纲差异会主导欧氏距离,若各变量量纲不同,建议先标准化再分析”。把“月收入(元)”和“满意度(1~5 分)”一起拖进来,构形几乎完全由收入决定,而七条前提仍会全部显示满足、Stress 也可能很漂亮。标准化要在进模块之前自己做。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:模型拟合优度主结果表
- 输出结果三:可视化(构形图、Shepard 图、Stress 贡献图、Stress 曲线)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
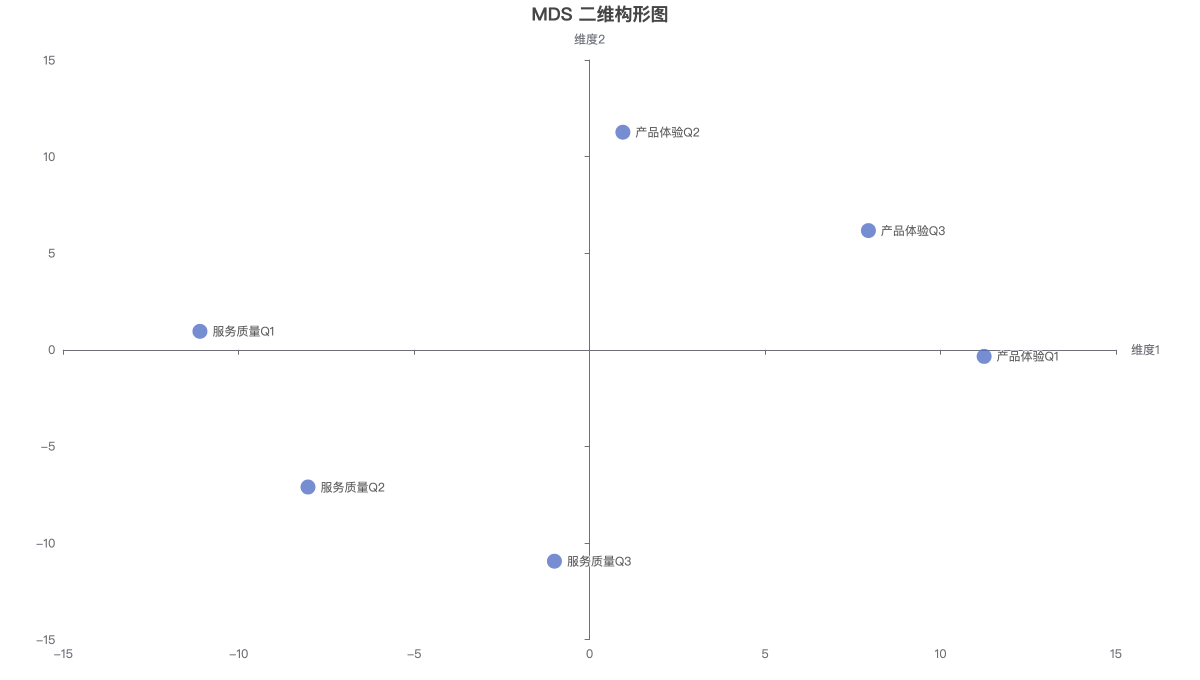
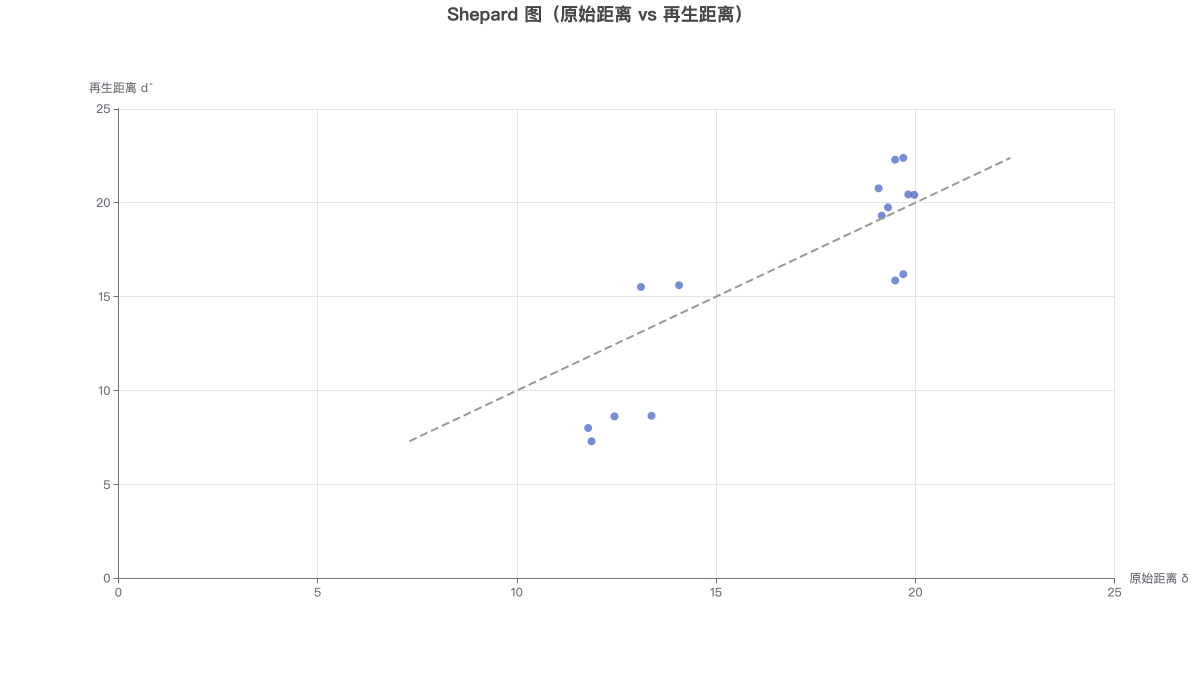
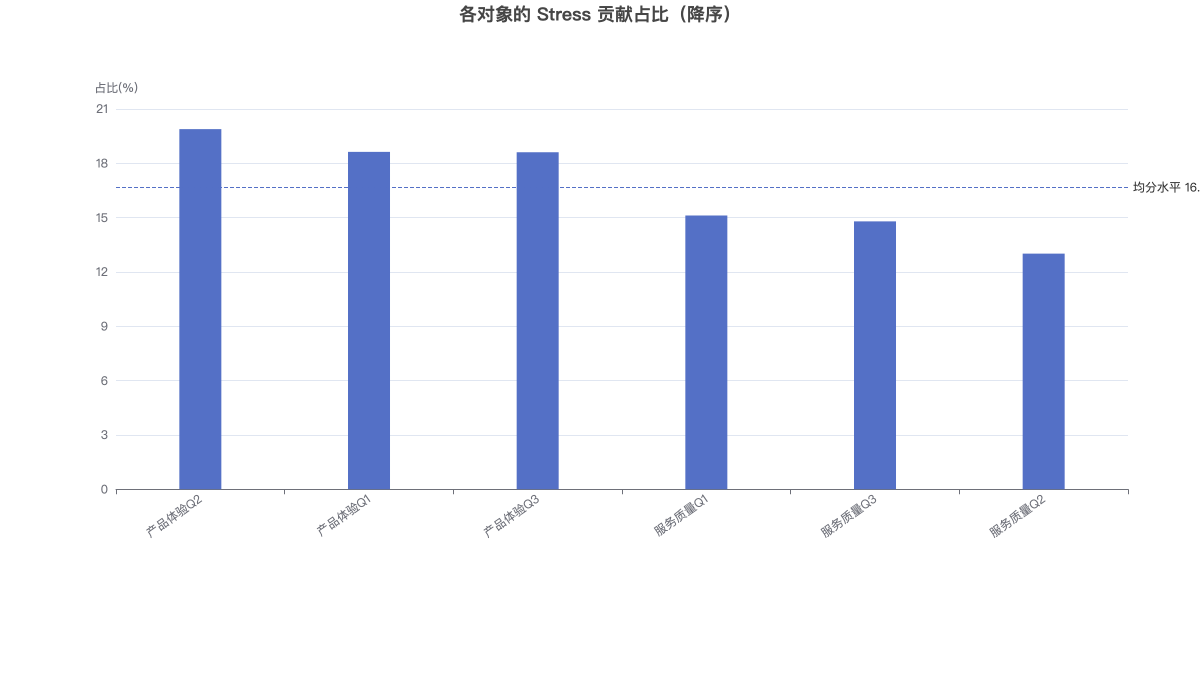
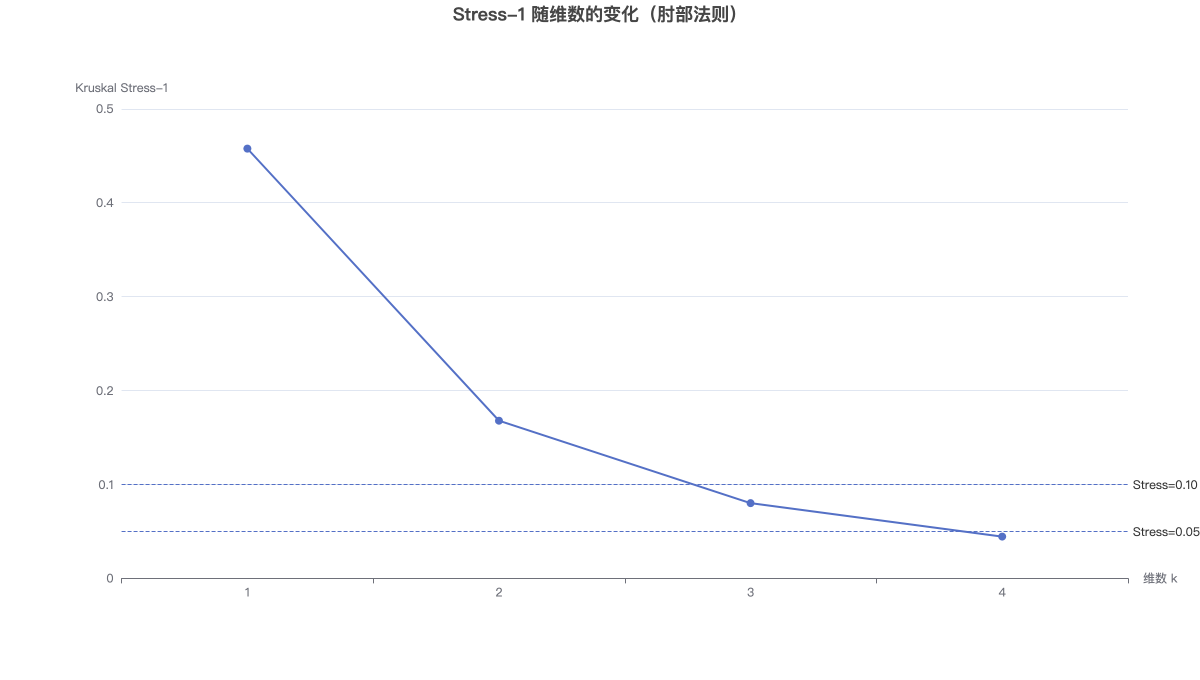
构形图给出对象的相对位置;Shepard 图把每一对距离画成一个点,点越贴近虚线 y=x 说明二维还原得越准。Stress 贡献图按对象降序展示各对象对总 Stress 的贡献占比,超过红色虚线(1.5 倍均分)的对象在二维平面上放不下(该图可用左上角切换器切到条形图/数据表)。Stress 曲线用肘部法则辅助选择维数(该图可用左上角切换器切到柱状图/数据表)。