
空间杜宾模型(SDM)
这个方法是做什么的
空间计量里设定最宽的一个:y=ρ·W·y+Xβ+W·X·θ+ε。它同时留出两条跨单元通道——邻居的因变量(W·y,系数 ρ)与邻居的自变量(W·X,系数 θ)。前者是扩散,后者是“隔壁修了路,我这儿的房价也涨”这种自变量外溢。空间权重 W 由经纬度按大圆弧距构造 K 近邻(k=min(8, n−1))再行标准化,无可调开关;估计用 spreg 的空间两阶段最小二乘(GM_Lag,slx_lags=1)。代价是待估参数增至 2×自变量个数+2 个,必须严格小于有效样本量。
读这份报告的特有着眼点是“β 与 θ 的对照”:卡② 的系数表用“变量类型”一列把直接项 X、空间滞后项 W·X 与空间自回归 ρ 分开列出,卡③ 下图把每个自变量的 β 与 θ 并排画在一起,一眼能看出本地作用与邻近溢出谁大、方向是否一致。真正可解释的效应量在卡④ 的 LeSage-Pace 分解里。因为是两阶段最小二乘而非极大似然,报告不产生对数似然,也就没有 AIC/BIC 与似然比检验。
需要准备什么数据
- 放入[定量]因变量 Y(1 个):不限
- 放入[定量]自变量 X(≥1 个):至少 1 个
- 放入[定量]经度(1 个):不限
- 放入[定量]纬度(1 个):不限
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 卡① 的 LM-Lag 与 LM-Error 同时显著,单一的滞后或误差设定都不足以刻画空间结构
- 理论上邻近单元的自变量就该影响本地:邻县的基建投资、上游的排污量、周边商圈的密度
- 你需要区分“哪个自变量的外溢更强”,而不只是知道存在外溢
- 担心遗漏了带空间结构的变量——SDM 常被当作稳健设定,因为它把 W·X 显式放进模型而不是留在误差里
- 空间单元数量充足,能承受 2×自变量个数+2 个参数的自由度消耗
每行必须是一个带坐标的空间单元;经度、纬度各一个定量列,不能同列、不能与因变量或自变量重复,坐标须为十进制度且有空间变异。至少 10 个空间单元;因变量与自变量须为定量非常数列,自变量个数不宜多。
什么时候不要用它
- 诊断只指向滞后型(稳健 LM-Lag 显著、稳健 LM-Error 不显著):用更简约的「空间滞后模型(SLM/SAR)」,白白多估一组 θ 只会摊薄精度。
- 诊断只指向误差型:用「空间误差模型(SEM)」,那里的空间结构在扰动项而不在自变量里。
- 自变量个数相对空间单元数偏多:2p+2 个参数会迅速吃光自由度,且 X 与 W·X 高度相关。先用「特征筛选」压缩自变量,或用「VIF共线性诊断」排掉冗余列,再回来。
- 只想确认空间自相关是否存在、热点在哪:用「莫兰指数(全局+局部LISA)」,不必先设定回归方程。
- 手上没有坐标,只有个体×时期结构:本模块必须由经纬度构造 W,用「面板模型」。
- 需要用信息准则在多个空间设定之间正式比较:三个空间模块都是矩估计/两阶段最小二乘,都不产生对数似然,拟合只能看伪 R² 与空间伪 R²。可行的替代路径是:先用「莫兰指数(全局+局部LISA)」独立确认空间自相关确实存在,再按卡① 的 LM 诊断在三个空间模块之间取舍;至于自变量集合的挑选,只能在不含空间项的「线性回归 (最小二乘法)」里用 AIC/BIC 先定下来,并在文中说明该比较未计入空间结构。
容易误读的地方
- θ 不是溢出效应,单看 θ 会把溢出说错。 卡② 表注写明“β/θ 为模型系数,当 ρ≠0 时不等于边际效应”,卡⑤ 更直接:“仅报告 θ 会低估或高估真实的空间溢出”。演示数据里“路网密度”的 θ=2.1656 显著,它的间接效应却是 1.4764;“人均可支配收入”的 θ=2.6261 不显著(p=0.0904),间接效应反而有 1.4943——数值不同,显著与否也不同步。要报溢出,报卡④ 的间接效应。
- 每个自变量可以有各自的溢出强度,这才是选 SDM 的实质理由。 演示数据里“人均可支配收入”的间接/直接约为 1.4943/1.7527≈0.85,而“路网密度”是 1.4764/0.5743≈2.57——后者外溢比本地作用还大。只含 W·y 的空间滞后模型做不到这一点:那里所有自变量共用同一个空间乘数,这个比值对每个变量恒等,“谁溢出更强”无从区分。
- 卡① 判定滞后型显著、卡② 的 ρ 却不显著,两者并不矛盾。 卡① 的 LM 检验做在不含 W·X 的最小二乘基准残差上(表注写明了这一点),而 SDM 一旦加入 W·X,原本只能由 W·y 承担的那部分空间信息就被分走了。演示数据里 ρ=-0.3707、p=0.4725、95%CI 宽到 [-1.3823, 0.6408],而 W·路网密度 显著(p=0.0018):结论是溢出走“邻居的自变量”这条路,不是“邻居的因变量”。W·y 与 W·X 携带高度重叠的信息,ρ 的标准误因此被放大,这是 SDM 的常态,不是数据出了问题。
- 效应分解照样用 ρ 的点估计,哪怕它不显著,而且分解没有置信区间。 卡④ 按 (I−ρW)⁻¹ 换算,演示数据用的就是那个不显著的 ρ=-0.3707,表注把 ρ 与它的 p 值一并印在下方;同一条表注还写明“未给出效应的置信区间(需蒙特卡洛模拟)”。所以直接/间接/总效应是三个没有区间的点估计,不能拿它们声称某项溢出“显著”——显著性只能引用卡② 里对应的 θ 或 ρ 的检验。
- “SDM 设定最宽所以最保险”这个想法只在样本撑得住时成立。 参数个数 2p+2 与 X、W·X 之间的共线一起作用,会让每个系数的标准误都变大;演示数据只有 2 个自变量、100 个单元就已经要估 6 个参数,卡① 表注专门印了这一行提醒它必须严格小于 N。设定更宽换来的是更少的偏误和更差的精度,不是免费的稳健性。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:空间杜宾模型系数表
- 输出结果三:空间杜宾模型系数森林图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
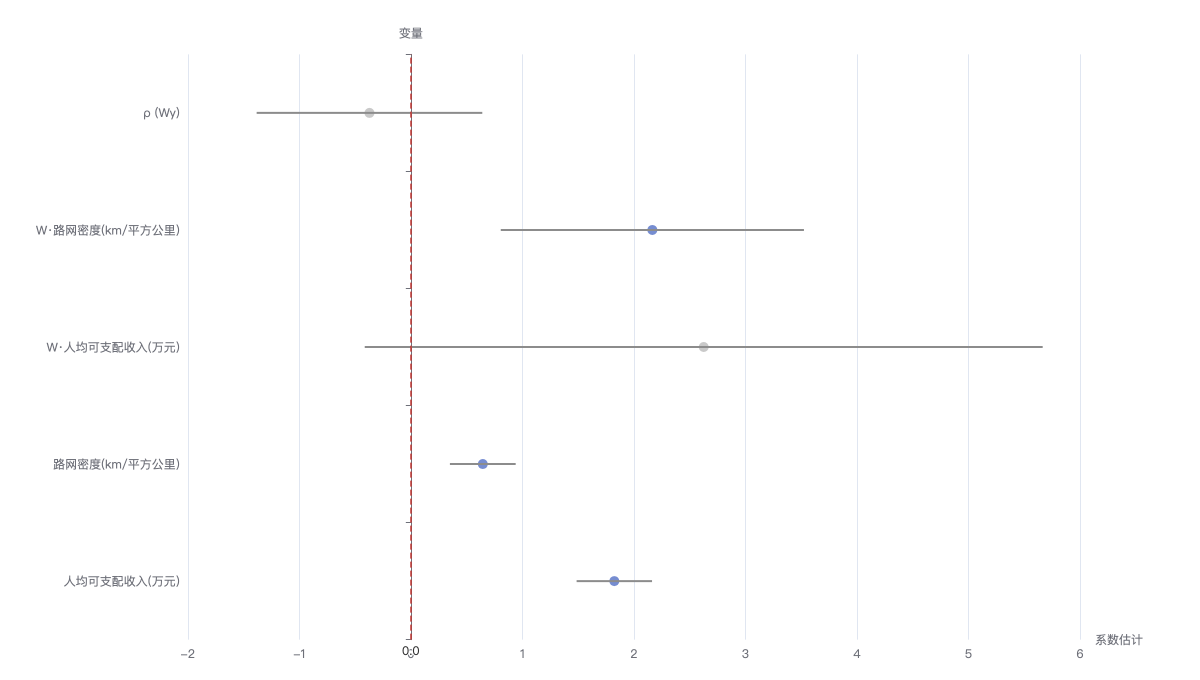
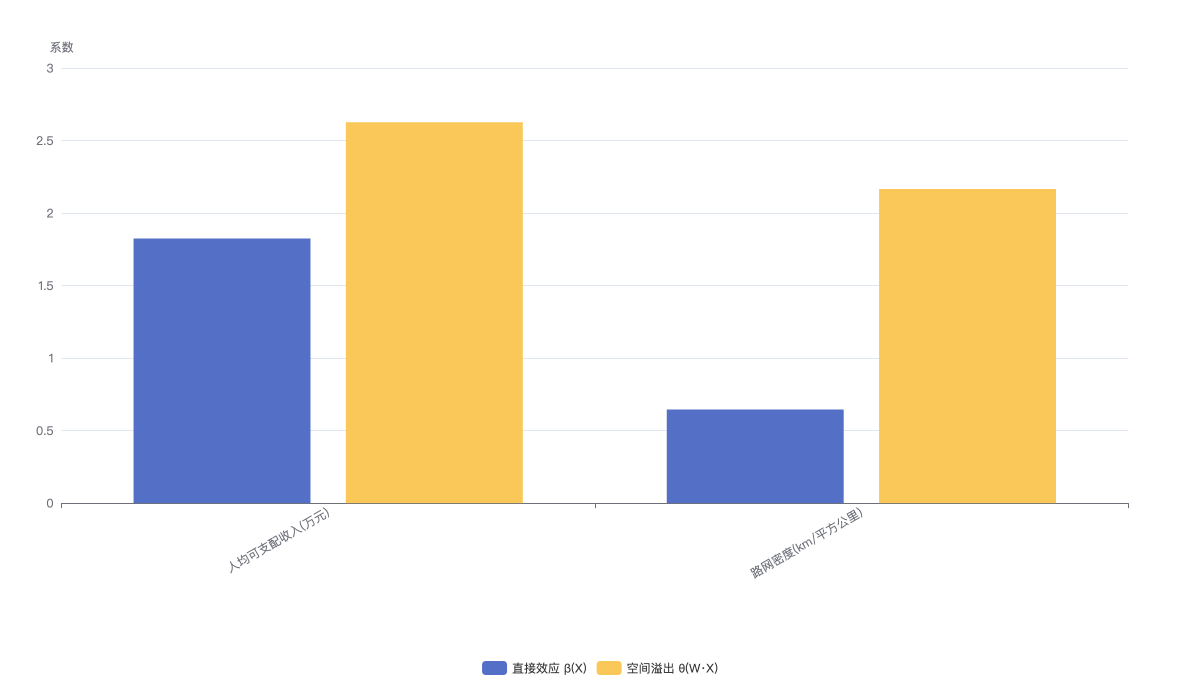
上图为全部参数的森林图(含 95% 置信区间);下图把每个自变量的直接项系数 β(X) 与空间滞后项系数 θ(W·X) 并列对照,直观展示「本地作用」与「邻近溢出」的相对大小与方向。两图均可用切换器改看表格。