
特征筛选
这个方法是做什么的
把一堆候选特征逐个拿去和目标变量比,按关联强弱排个序。筛选方法在控件里三选一:F 检验、互信息、相关;任务类型(分类还是回归)默认按目标变量自动判别——目标为非数值类别、或唯一取值不超过 10 个判为分类,否则判为回归,也可以强制指定。候选特征必须是定量列且至少 2 个,目标变量不能同时出现在特征区。
排名表的统计量、p 值来源与效应量三种方法各不相同:F 检验给 F、R²(分类任务为 η²)与非中心 F 反演的 95%CI,并附 Cohen 分级;相关法给带符号 Pearson r 与 Fisher z 区间,分级按 |r| 的 0.1/0.3/0.5;互信息给 MI(nats)与自助区间、p 来自置换检验,既没有 R² 也没有分级列,样本量×特征数超过计算预算时还会直接不做检验。第四张卡承担效应量与事后分析:同时检验 k 个特征造成的假阳性膨胀用 Holm(控制族错误率)与 BH-FDR(控制假发现率)两套校正,两套结论都给;另有一张冗余诊断表,列出 |Pearson r| ≥ 0.8 的特征对。这是单变量筛选,逐个特征评分,看不到特征之间的交互与冗余。
需要准备什么数据
- 放入[目标变量Y](定量/定类):不限
- 放入[候选特征X](定量):至少 2 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 候选变量几十上百个,先粗排一遍决定哪些值得进模型
- 想在建模前知道哪些变量和目标压根没关系
- 需要一份带效应量与置信区间的特征重要性表写进论文
- 想确认几个业务上被认为重要的变量是不是真的和目标有关联
前提是数据表至少 20 行,按整行列表删除缺失后仍要留下足够的完整记录(分类任务还要求有效样本数大于类别数),每个特征至少 10 个观测是经验下限。常数列在 F 检验与相关法下得分无定义,会被排到末位并明确标注——那是"算不了",不是"最不重要"。
什么时候不要用它
- 你要的是控制住其他变量之后的净效应:单变量筛选给的是边际关联,偏效应要靠多元模型,连续因变量用「线性回归 (最小二乘法)」,二分类结局用「逻辑回归」。
- 你要一份能自动把系数压成 0 的稀疏模型:本模块只排序、不建模,用「Lasso回归」;一组共线变量希望成组去留用「ElasticNet回归」。
- 你的目的其实是诊断共线性:看的是特征之间而不是特征与目标,用「VIF共线性诊断」。
- 候选特征是分类文本:本模块要求定量列,先看单变量关联可用「列联(交叉)分析」或「卡方检验」。
- 你想把大量相关变量压缩成少数几个综合维度,而不是从中挑几个:那是降维不是筛选,用「主成分分析(PCA)」,要可解释的潜在结构用「因子分析(探索性)」。
容易误读的地方
- 用全体数据选特征、再用同一批数据评估模型,性能会被系统性高估。 这是选择偏倚,也是本模块最容易被误用的地方:即使所有特征都与目标无关,从几十个里挑出得分最高的那几个,也必然在这批数据上"看起来有关",而这份优势换一批数据就消失。正确做法是把筛选整个塞进交叉验证的训练折里——每一折用该折的训练数据重新筛一次,再在该折的验证数据上评估。「逐步回归」踩的是同一个坑,那里的 p 值同样是失真的。
- 它给的是边际关联,不是多元模型里的贡献度。 两个后果都很实在:一是"单独看无关、组合起来有关"的特征会被漏掉(交互项、抑制变量都属于这类);二是两个几乎等价的特征会拿到几乎一样的高分,一起选进去并不带来两份信息,只制造共线性。第四张卡的冗余表就是补这一半的,但它只列 |r| ≥ 0.8 的线性冗余对,非线性的冗余它也看不见。
- 排名表本身没有做多重比较校正。 同时检验 k 个特征,在 α=0.05 下即使全都无关,平均也有 0.05k 个会"显著"——20 个特征就是 1 个。第二张卡给的是未校正的 p,校正后的结论在第四张卡:Holm 更保守适合确认性研究,BH-FDR 更宽松适合探索性筛选。以未校正的 p 划线入选,等于给自己批量制造假阳性。
- 名次的先后不等于重要性真有差别。 排第 2 和排第 3 的特征,如果 R² 的 95% 置信区间大面积重叠,换一批样本它们的顺序很可能对调。这也是报告把置信区间和点估计并排放的原因——区间很宽说明这个特征的重要性估计本身极不精确,此时讨论它比谁高一名没有意义。
- 换一种筛选方法就换一份排名,因为三种方法捕捉的关联类型不同。 F 检验与相关只对线性(分类任务下是组间均值差异)敏感,互信息才能捕捉非线性与非单调关系。一个业务上公认重要的变量得分很低时,先切到互信息复核一遍——它可能与目标呈 U 形或阈值关系,而不是真的没用。三种方法结论不一致本身就是信息,应当交叉对照后再下判断——但切过去之后表头也换了:互信息那一列没有 R²、没有分级,区间来自自助重抽,不能和 F 检验的区间并排比。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:特征重要性排名(F检验(方差分析F值)·回归)
- 输出结果三:特征重要性可视化
- 输出结果四:多重比较校正与冗余诊断
- 输出结果五:结论与学术表述
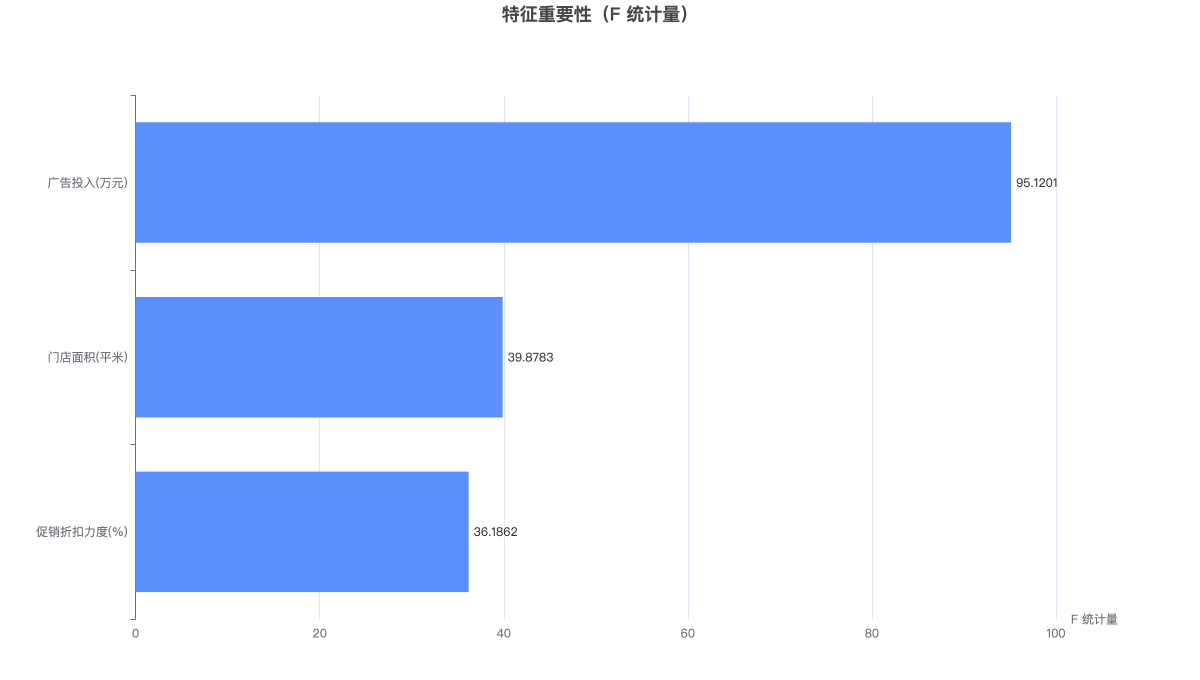
横轴为「F 统计量」,纵轴为特征名称,条形越长代表边际关联越强(自上而下重要性递减)。切换到「表格」视图可同时读取效应量及其 95% 置信区间。