
广义估计方程(GEE)
这个方法是做什么的
观测不是彼此独立而是成簇的——同一个人被反复随访、同一家医院的病人、同一个班的学生、同一个村整群随机——这时直接跑普通回归会低估标准误、把 p 值算得过小。GEE 的做法是:均值结构照常写成广义线性模型,簇内相关只当作需要校正的干扰,用稳健三明治标准误把它吃掉。它给出的是总体平均(population-averaged)效应,回答“整个人群平均而言,X 高一个单位的人结局高多少”。因变量可选泊松(非负整数计数)、二项(恰好两个取值)、Gamma(全部大于 0 的连续量)三族,工作相关结构可选独立型、交换型、AR(1)。
除了系数、稳健标准误与 exp(B)(泊松族是发生率比,二项族是优势比 OR,Gamma 族是乘性效应),卡① 报簇数、簇大小的最小/中位/最大/平均、只含 1 个观测的簇数;卡④ 给 QIC 与 QICu、工作相关参数、逐参数的稳健标准误与朴素标准误对比,以及把工作相关结构换成独立型之后的系数对照。GEE 是拟似然方法,不构造完整似然,因此没有似然比检验也没有 AIC——跨模型比较只能用 QIC(换相关结构时)与 QICu(换自变量集合时)。
需要准备什么数据
- 放入因变量 (Y):不限
- 放入自变量 (X):至少 1 个
- 放入分组变量:定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入分组变量」的类别数需在 2~500 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 多中心研究:同院患者结局彼此相关,但你要报的是全人群的平均效应
- 纵向随访:同一个人被反复测量,结论要写成“该干预在人群层面把发生率降低了多少”
- 整群随机试验:随机化单位是学校、社区、车间,个体在簇内相似
- 因变量是计数或二分类,分簇只是抽样设计的副产品,你并不打算解释它
分组(簇)变量必填且必须是定类。稳健三明治标准误依赖“簇数趋于无穷”的渐近性质,经验门槛约 30~40 个簇;簇数少于 20 时卡① 会直接打“注意”,此时标准误偏小、p 值偏激进。因变量必须与所选分布族对得上,对不上在入口就报错(泊松族要非负整数、二项族要恰好两个取值、Gamma 族要全部大于 0),不会静默转换。GEE 对缺失的要求是完全随机缺失,缺失若与结局相关则估计有偏。
什么时候不要用它
- 观测本来就独立、没有簇结构:正值连续因变量用「Gamma 回归」,计数用「计数数据回归」,二分类用「逻辑回归」。
- 研究问题是“同一个体内改变 X 会怎样”,或组间异质性本身就是要量化的东西:用「广义线性混合模型(GLMM)」;因变量是正态连续时用「混合模型」。
- 因变量是正态连续(评分、金额、浓度):本模块没有高斯族,用「混合模型」,它直接给 ICC 与 Nakagawa 边际/条件 R²。
- 簇数很少(只有五六个中心):稳健标准误在这里不可靠。把簇当成普通定类自变量放进「逻辑回归」或「计数数据回归」更老实;若暴露与结局都是二分类、簇是要控制的分层因素,用「分层卡方分析」。
- 因变量是等级(1~5 星、轻/中/重):三个分布族都装不下。可按研究问题把等级并成两类后回到本模块;或接受“按独立观测估计、标准误偏小”的局限改用「有序逻辑回归」,并在文中说明簇内相关未被校正。
- 缺失明显与结局有关:先做「多重插补」再回来;或改用似然口径、在随机缺失下仍有效的「混合模型」(正态因变量)与「广义线性混合模型(GLMM)」。
容易误读的地方
- GEE 的系数和 GLMM 的系数不是同一个东西,数值也不该相等——这是本族最容易读反的一条。 实测同一份二分类数据(40 个簇、随机截距标准差 1.54):GEE 给 B = 0.683、OR = 1.98,GLMM 给 B = 0.953、OR = 2.59,差了三成。这不是谁算错:GEE 答的是“人群里 X 高一档的人,平均而言优势高多少”,GLMM 答的是“在同一个簇内部,X 高一档优势高多少”。链接函数非线性时(logit、log),总体平均效应会被组间异质性稀释,异质性越大差得越远;只有恒等链接下两者才相等。论文里必须写明报的是哪一种,不能拿 GEE 的 OR 去解释某个具体个体。
- 卡① 那条“过离散初判”是对原始因变量直接算的边际方差均值比,不扣自变量解释掉的那部分,会误报。 实测:一份严格服从条件泊松、完全没有过离散的数据,只因为自变量效应强,边际方差均值比就到了 6.641,模块照样打出“注意:提示过离散”。真正该看的是残差层面的离散,这一卡不给。看到这条告警,正确的动作是拿「计数数据回归」的负二项跑一遍作对照,而不是直接改结论。另外泊松族下卡④ 的“Scale(离散参数)”实测恒为 1.0000(方差均值比 1.23 与 6.64 两次实测都是 1.0000),过离散不会被这个参数吸收,靠的是稳健标准误。
- 卡④ 的“稳健/朴素标准误”比值才是“这次到底该不该用 GEE”的直接读数,而且要逐行看。 示例数据里三个参数的比值分别是 1.029、0.959、1.324——注意有一个小于 1。比值明显大于 1 说明簇内正相关真实存在、忽略它会夸大显著性;接近甚至小于 1 说明这次的簇结构没吃掉多少信息。卡⑤ 的学术表述里那句话取的是比值的中位数(本例 1.029,据此说“影响有限”),可单个参数完全可能远离中位数(本例最大的那个是 1.324),判断某一个系数可不可信要看它自己那一行。
- 这里没有模型整体的显著性检验,也不要去找 AIC。 卡② 表注写明“GEE 为拟似然估计,无似然比检验;整体推断以各系数的稳健 Wald 检验为准”。跨模型比较只有 QIC 与 QICu,两者用途不能互换:QIC 用于同一均值结构下比不同工作相关结构,QICu 用于比不同的自变量集合;QIC 也不能和别的模块给的 AIC 放在一起比大小。
- 工作相关结构选错不影响点估计,但“α 是多少”不等于“簇内相关有多强”。 卡④ 专门印了一张“交换型 vs 独立型”的系数对照(示例数据里相对变化 0.18%~2.16%):差异小说明均值结构设得住,这正是 GEE 稳健性的体现;差异大反而提示均值结构可能设错了,该回头查自变量,而不是继续挑相关结构。工作相关参数 α = 0.0871 这类数字是“工作”假定下的产物,不要当成真实组内相关系数写进论文——要报组内相关,用「组内相关系数(ICC)」,或用「广义线性混合模型(GLMM)」的潜尺度 ICC。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:GEE 系数表
- 输出结果三:系数森林图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
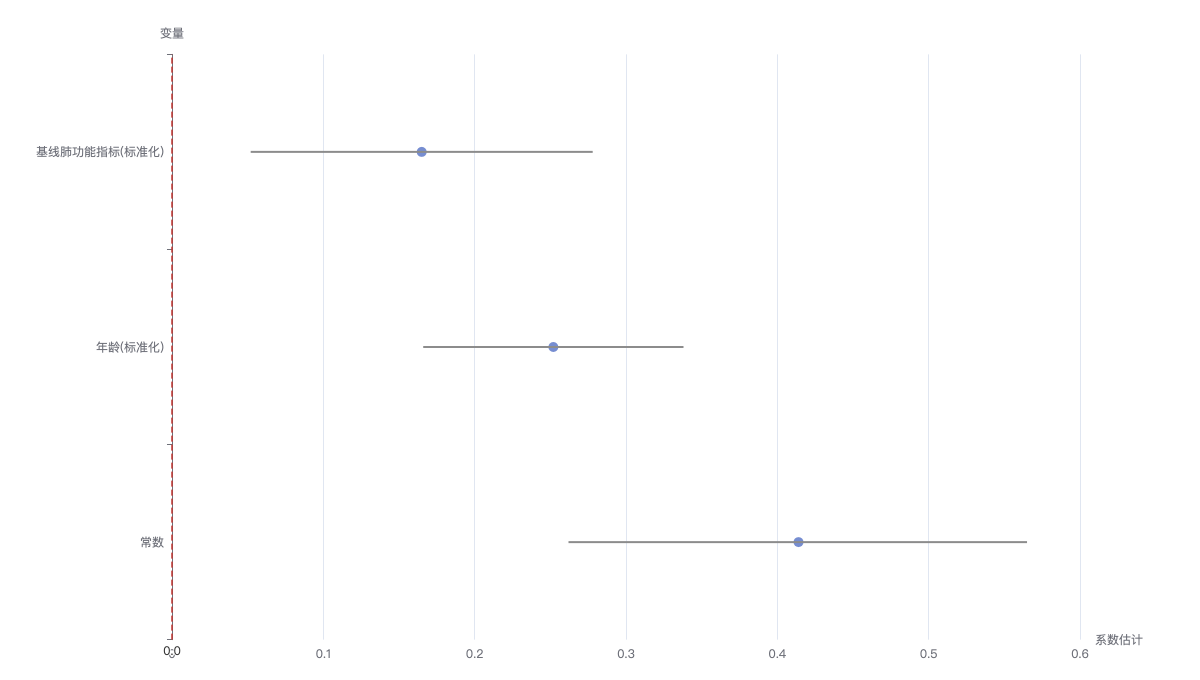
图形读法:圆点为各系数的点估计,横向须线为其 95% 置信区间;红色虚线为零参考线。置信区间跨越零线(含 0)表示该系数不显著(灰点),不跨越则显著(蓝点),须线越窄表示估计越精确。本图为表4的可视化,未改变任何数值;可用右上角切换器切到「表格」视图逐条读数。