
耦合协调度
这个方法是做什么的
耦合协调度模型评的是两个子系统之间的关系,不是一批对象的高低。拖拽区里正向指标区构成子系统 A(A = 正向指标归一化后的均值),负向指标区构成子系统 B(B = 1 − 负向指标归一化后的均值)。三个量各管一件事:耦合度 C = 2√(A·B)/(A+B) 只反映两个子系统同步不同步,协调指数 T = αA + βB(默认 α=β=0.5)反映两者的综合水平,耦合协调度 D = √(C·T) 把两者合起来,再按 D 的十等分档判成 1~10 级(“极度失调”到“优质协调”)。
读这份报告的关键是永远把 C 和 T 一起看,只看 D 会漏掉本方法最要命的一种情形:两个子系统同步地差。第三张卡的 C–T 分解图专为此设,右上角是高水平协调、右下角是“C 高 T 低”的低水平耦合陷阱;第四张卡还会逐对象打上失调类型标签(判据:C≥0.8 且 T<0.4 为低水平耦合,C≥0.8 且 T≥0.6 为高水平协调,|A−B|≥0.3 为子系统失衡),并把子系统权重 α 在 0.3~0.7 之间取 5 档重算,报告名次与等级的稳定性。
需要准备什么数据
- 放入正向指标 [定量] 变量(可选):至少 0 个,定量变量(数值)
- 放入负向指标 [定量] 变量(可选):至少 0 个,定量变量(数值)
- 放入 [定量] 变量协调系数T(可选):定量变量(数值)
- 放入索引项 [定类] 变量(可选):定类变量(分组/标签)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 经济与环境、城镇化与生态、产业与人口这类“两个系统是否协调发展”的题目
- 两个子系统的综合水平已经各自算好,并已无量纲化到 [0,1]
- 需要一个可直接引用的等级结论(十级划分是文献通用惯例)
- 想区分“两边都好”“两边都差但同步”“一边拖后腿”这三种结构
前提是两个区各放至少 1 个指标。未开启“数据区间化”时,模型直接按原始值计算,因此要求指标事先已落在 [0,1];若指标还是原始量纲,必须打开这个开关,否则耦合度会被强制截断、D 与等级判定随之失真。第一张卡会逐指标做取值域体检并给出结论。
什么时候不要用它
- 你要排的是一批对象的综合名次,不是两个子系统的关系:用「优劣解距离法(TOPSIS)」「多准则妥协解排序法(VIKOR)」或「秩和比综合评价法(RSR)」。
- 只想要一套指标权重:用「熵值法」「CRITIC权重法」或「变异系数法」,本模块不做指标赋权。
- 两个系统之间的关系是“谁影响谁”而不是“同步不同步”:用「Pearson相关性分析」看关联强度,或用「线性回归 (最小二乘法)」估计方向与幅度。
- 要评的是投入换产出的效率:用「数据包络分析(DEA)」。
- 两组变量之间的整体关联结构才是问题:用「典型相关分析」。
- 被评的只有一个对象、你要的是等级隶属度:用「模糊综合评价」。
容易误读的地方
- 两个子系统不能都拖进正向区。 分区就是分子系统:全部指标放进正向区时 B 被恒置为 1,报告虽然会在摘要和第一张卡打出“单子系统退化”的警告,却照样输出一份完整的报表——实测演示数据这样跑,15 个对象全部落在第 9 级“良好协调”,平均 D=0.836,看上去毫无异常。若第二个子系统本身也是“越大越好”,按报告给出的公式 B=1−(归一化后均值) 反推,应先把它转成 1−x 这类成本型形式再拖进负向区。
- “数据区间化”开关会改掉协调等级,不是只改小数点。 同一份演示数据实测:关闭时“华南区”D=0.625、第 7 级“初级协调”;打开后 D=0.000、第 1 级“极度失调”。原因是区间化用本批极值做 min-max,本批最差的对象被强制拉到 0。全局平均 D 也从 0.742 掉到 0.619,判为低水平耦合的对象从 1 个变成 3 个。这个开关必须按“指标是否已在 [0,1]”来选,不是按哪种结果好看来选。
- 耦合度 C 很高是常态,不是好消息。 演示数据里 15 个对象的 C 没有一个低于 0.98,均值 0.995。C 的公式对 A 与 B 的比值很不敏感,只要两者不相差一个数量级,C 就贴近 1;只有当某个子系统恰好被拉到 0(开启区间化后本批最差的那个对象就是如此,实测 C=0.000)它才会塌下来。真正区分对象的是 T,把 C 高写成“协调性极好”是这个方法上最常见的误读,第四张卡的失调类型诊断正是为拦住它而设。
- 十级分档是文献惯例,不是统计判据。 等级 k 对应 D∈((k−1)/10, k/10],纯粹是等分。D=0.699 和 D=0.701 分属两级,差别却只有 0.002;处于档位临界带的对象,其等级归属对 α 和归一化方式都敏感,报告时应连同 D 值一起给出。
- 拖进“协调系数T”区的那一列不参与任何计算。 第一张卡写得很清楚:它只作为参照列原样输出,模型用的 T 始终是内部算的 αA+βB。看到表里这一列和“协调指数T值”列对不上,不是算错了。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:耦合协调度主结果表
- 输出结果三:可视化(耦合协调度排序图与 C–T 分解图)
- 输出结果四:子系统权重敏感性与失调类型诊断
- 输出结果五:结论与学术表述
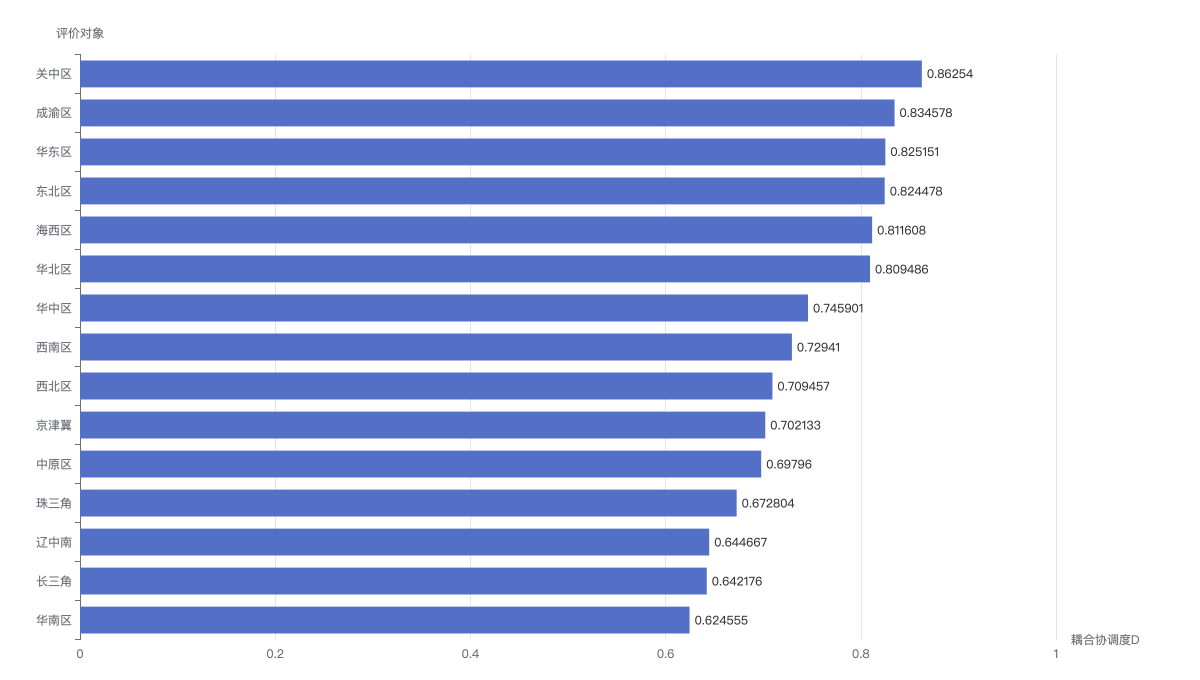
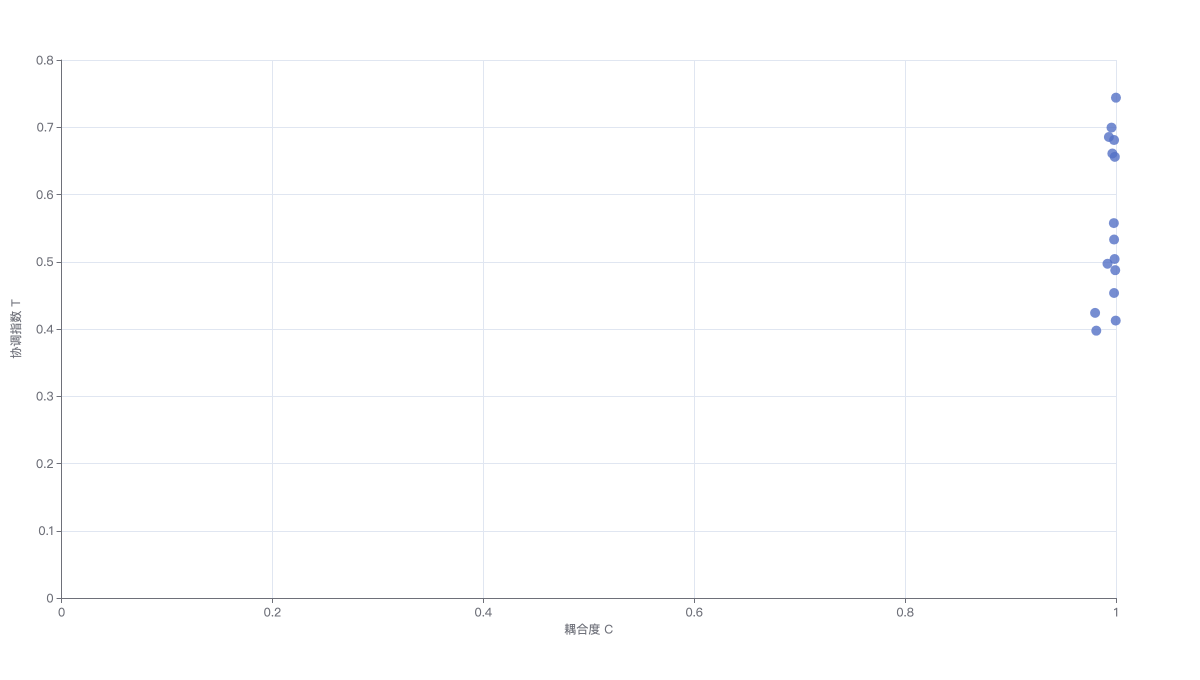
上图按耦合协调度 D 排序(最优在最顶端,可切换柱形图/折线图/表格视图);下图把 D 分解为「耦合度 C(横轴,同步程度)」与「协调指数 T(纵轴,发展水平)」两个维度。