
极差分析
这个方法是做什么的
把一次已经做完的多因素试验按“因素—水平”拆开:对每个因素算出各水平下指标的和 K_i 与均值 k̄_i,极差 R = max(k̄) − min(k̄)。R 越大,说明该因素的水平变动把指标拉开得越多,按 R 降序排列即得因素主次顺序。再按你在“指标特性”控件里选的望大或望小,取每个因素各自的最佳水平拼成推荐组合。因素列既可以是定类的(催化剂种类)也可以是定量的(温度),本方法一律按水平离散处理。
除了极差表,在试验有重复时报告还附一整套推断:主效应方差分析(Type II 平方和)、η² 与偏 η² 与 ω²、各水平的最小二乘均值及 95% 置信区间、Tukey HSD 事后两两比较。第一张卡逐条列出前提:水平是否均衡、因素间是否正交、按因素分组的 Levene 方差齐性、残差 Shapiro-Wilk 正态性。演示数据实测 27 次试验、残差自由度 20,三个因素都给出了 F 与 p。
需要准备什么数据
- 因变量 Y (实验结果):定量变量(数值)
- 自变量 X (检验因素):至少 1 个,定量变量(数值)或定类变量(分组/标签)
数据要求
- 数据表至少 4 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「自变量 X (检验因素)」的类别数需在 2~20 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 用「正交设计」或「全因子设计」排的方案已经做完,想快速排出因素主次并给出推荐工艺
- 因素是定类的,或水平不等间距,谈不上回归斜率
- 想在一份报告里同时拿到“哪个因素最重要”和“每个因素该取哪一档”
- 需要一段可以直接誊进论文结果小节的表述,卡⑤ 已经写好
前提是因变量必须定量且有变异,每个因素至少 2 个水平。要拿到 p 值还需要试验有重复:总样本量必须大于 1 + Σ(各因素水平数−1),否则残差自由度为 0。
什么时候不要用它
- 因素是定量的,真正想要的是最优工艺点而不是最佳档位:极差只能在你做过的水平里挑,用「响应面分析(RSM)」拟合曲面找区域内的最优点。
- 需要估计交互作用:本模块拟合的模型只含主效应、不含交互项,表注对此有明确说明。先用「全因子设计」把组合做全,再用「多因素方差分析」。
- 只有一个因素:用「单因素方差分析」;数据明显非正态或本身是等级的,用「多独立样本Kruskal-Wallis检验」。
- 同一批对象被反复测量(同一台设备在各条件下重复取值):观测不独立,用「重复测量方差分析」。
- 试验完全没有重复却一定要显著性:本模块会明确拒绝给。补做重复后重跑;若因素是定量的且做过 3 个以上水平,可把它们当连续变量交给「线性回归 (最小二乘法)」,线性项只占 1 个自由度,能腾出残差自由度。
容易误读的地方
- “指标特性”选错,报告不会有任何异常,但推荐组合会整个反过来。 同一份演示数据实测:望大时推荐“反应温度=高温,反应时间=90min,催化剂用量=0.5%”,切成望小后推荐“反应温度=低温,反应时间=30min,催化剂用量=1.5%”,而极差 R(9.1978 / 4.3956 / 2.5889)与因素主次顺序一个字都没变。也就是说这个控件只影响“取最高点还是最低点”,报告里没有任何一处会因为你选反而露出破绽。
- 推荐组合通常是拼出来的,不是做出来的。 演示数据实测:推荐的那一组并不在实际做过的 27 次试验里,报告写明它“属于按主效应可加性外推的结果,必须安排验证试验实测确认”。这个拼装动作默认因素效应可加、交互可忽略;真有交互时,把各因素单独的最佳水平拼起来未必最优。
- 没有重复就没有 p 值,报告会直接告诉你,别去别处找。 用一张 L9(3⁴) 饱和正交表(9 次试验、4 个 3 水平因素)实测:摘要写“本试验无重复(残差自由度 0),未进行方差分析,报告中不含任何 p 值与统计效应量”,第四张卡里那张效应量表的标题也换成了“各因素的描述性效应度量(无重复试验,无法计算 η²/ω²)”,残差正态性那一行标“未做”。此时极差与主次顺序照常给出,但它们纯属描述:R 没有抽样分布,因而既没有 p 值也没有置信区间。
- 极差能不能跨因素比,靠“各水平重复数相同”撑着。 卡① 有专门一行检验它,判定原文是“满足——k̄ 直接可比,极差 R 是无偏的水平效应度量”,表注补充说不均衡时不同因素的 k̄ 受其它因素影响的程度不同、R 的排序会失真。所以中途报废几次试验、让某因素某水平少做一次,R 的排序就不再可靠,这时应以效应量与方差分析为准——表注也是这么写的。
- R 只回答“能拉开多少”,不回答“值不值得改”。 演示数据里催化剂用量的 R 只有 2.5889、排第 3,可方差分析给出 F(2,20)=16.75、p<0.001,偏 η²=0.6262 被判为“大”。R 小完全可以显著;反过来 R 大也可能只是组内波动大而不显著。卡④ 的图注把分工写得很清楚:效应量回答影响有多大,p 回答是否可归因于随机波动,R 回答在本次水平范围内指标能被拉开多少。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:极差分析表与主效应方差分析
- 输出结果三:主效应图与极差图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
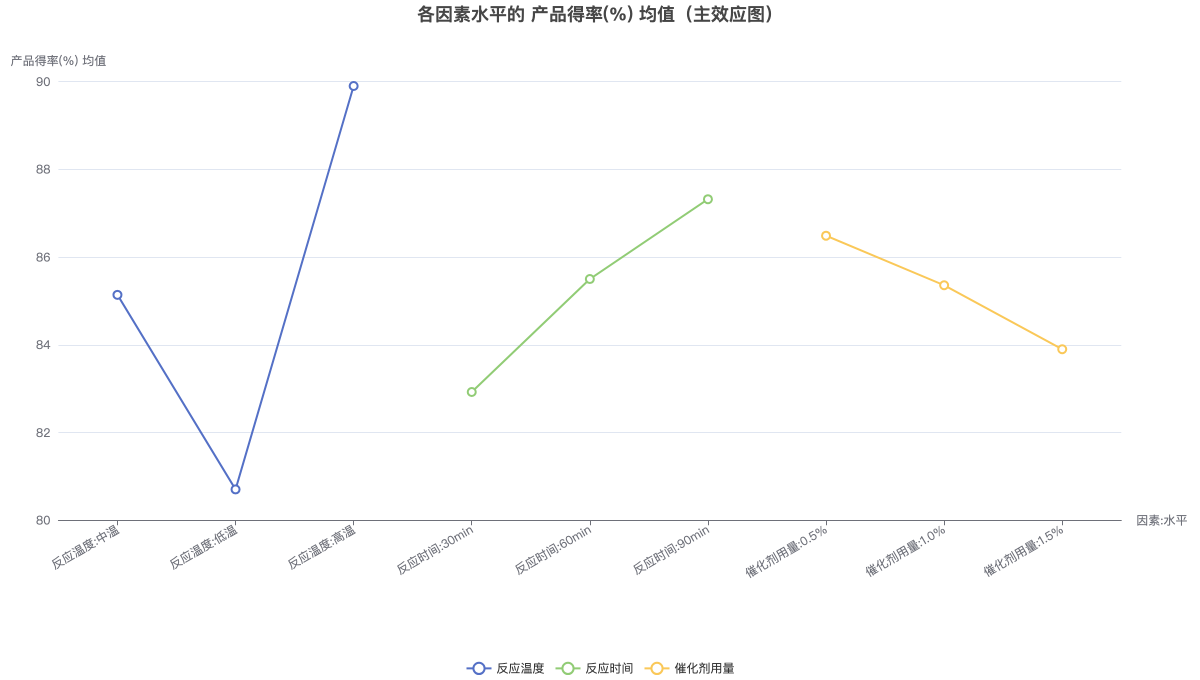
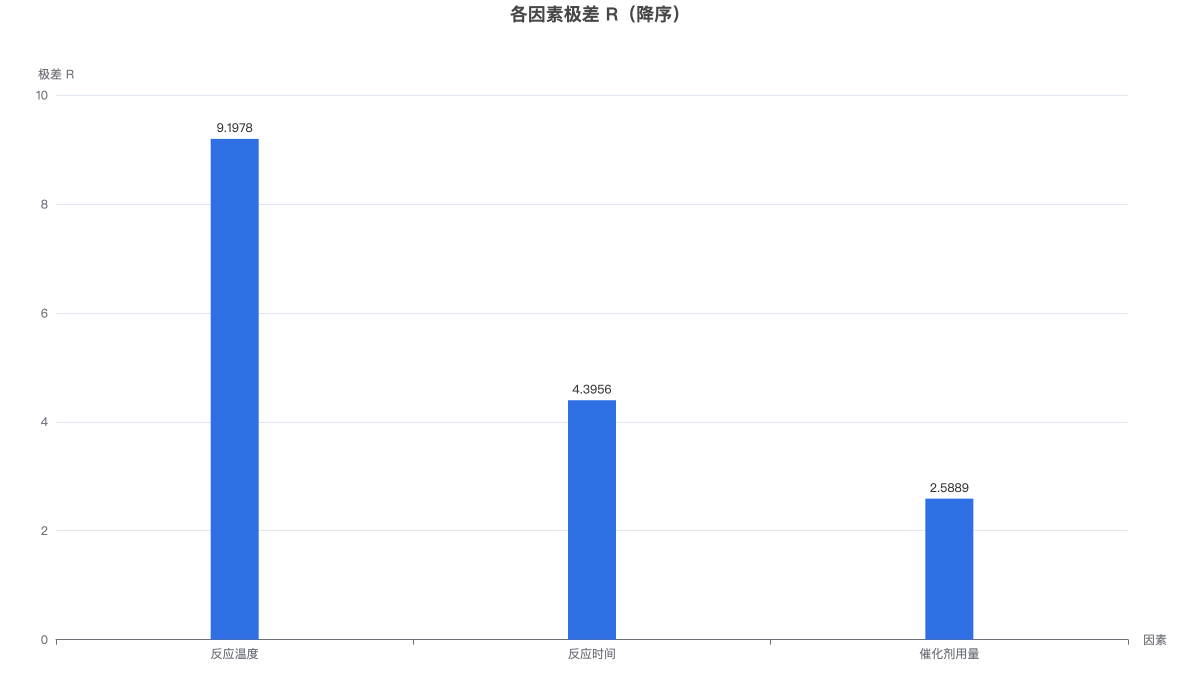
上图把所有因素的水平并排展示,每条折线是一个因素在其自身水平区间内的 产品得率(%) 均值走势;折线起伏越大,说明该因素的水平变动对指标影响越强,与下图的极差 R 完全对应(R 就是该折线的最高点减最低点)。