
Weibull可靠性(寿命分布)
这个方法是做什么的
给一批寿命数据拟合双参数 Weibull 分布 R(t)=exp(−(t/η)^β),用极大似然估计(含右删失处理)求出两个参数:形状参数 β 决定失效率随时间怎么走,尺度参数 η(特征寿命)决定寿命的量级。β<1 是失效率递减的早期失效期(浴盆曲线左段,早夭/工艺缺陷主导),β≈1 是失效率恒定的偶然失效期(此时 Weibull 退化为指数分布),β>1 是失效率递增的耗损失效期(老化、磨损、疲劳)。η 有一个与 β 无关的固定性质:运行到 η 时恒有约 63.2% 的单元已失效。
报告把“β 到底是不是 1”做成了正式检验而不是只看点估计:卡②用似然比检验对比 Weibull 与指数分布(演示 LR=42.762、df=1、p<0.001,β=1.823 的 95%CI [1.563, 2.127] 也不含 1)。分布族选得对不对同样有检验:卡①以 Kaplan-Meier 经验分布为参照给 KS 距离与概率图相关系数 PPCC,因为参数由同一批数据估计、渐近临界值不再适用,p 值由条件参数自助法(B=299 次重抽)重标定。卡④给 B1/B5/B10/B50/B90 各分位寿命、MTTF 与 η 及其 95% 置信区间(Delta 法在对数尺度上算完再反变换,故区间恒为正且不对称),并逐时间点给 R(t)、F(t)、h(t),超出观测寿命范围的行会被明确标注为“外推”。
需要准备什么数据
- 放入[定量]失效时间/寿命:1 个,定量变量(数值)
- 放入[删失标志](可选)(可选):不限
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 产品寿命试验、现场失效记录,要估算 B10 寿命作为保修期或预防性更换周期
- 试验到期还有一批样品没坏(右删失),需要把这部分“活过某时刻”的信息一并用上
- 需要判断失效属于早期、偶然还是耗损,据此决定该做老化筛选还是定期更换
- 要给出任意时刻的可靠度 R(t) 与瞬时失效率 h(t) 及其置信带
前提:寿命必须严格大于 0(双参数 Weibull 的位置参数固定为 0,零值负值会被剔除);删失标志列只能取 0 或 1(1=失效,0=右删失),且至少要有 2 个失效观测才能识别 β。数据要求把行数下限定在 20,少于 20 条会被前置校验拦下;失效点建议不少于 15~20 个,否则 β 的区间会很宽、B10 与 MTTF 的外推不可靠。还有一条报告明确标为“未做该检验”的前提:删失必须独立于寿命(无信息删失),它在数学上不可由观测数据识别,只能由试验方案保证。
什么时候不要用它
- 要比较两组或多组的生存曲线(新旧工艺、不同供应商):本模块只拟合一条曲线,用「Kaplan-Meier生存分析」做非参数比较。
- 要看若干协变量各自对失效风险的贡献:用「Cox比例风险回归」,它不需要指定寿命分布族。
- 数据是按时间区间汇总的(区间删失/分组寿命表),不是逐个体的失效时刻:用「寿命表」。
- 存在多种互相排斥的失效原因,单一失效模式假定不成立:用「竞争风险模型」。
- 寿命是在加严应力下测出来的、要外推到正常使用条件:本模块不做应力外推,用「加速寿命试验」。
- 质量特性不是寿命而是尺寸等测量值且有工程规格限:用「过程能力分析」;只想看寿命的分布形态与集中趋势、不做参数拟合与外推,用「描述性统计」。
容易误读的地方
- MTTF 不是“平均无故障间隔”,把它当 1/失效率用是最常见的错。 报告给的 MTTF=η·Γ(1+1/β) 是分布的期望值,只有在 β≈1(失效率恒定)时才等于 1/失效率;卡④的表注逐字点名了这个误用。演示数据 β=1.823 已被似然比检验证实显著大于 1,此时失效率随时间递增,用一个常数失效率去做备件测算会在后期严重低估失效量。
- β<1 时预防性更换不但无益,反而有害。 失效率递减意味着用得越久越可靠,换上一个新件等于把设备退回失效率最高的阶段。演示数据是 β=1.823 的耗损型,卡⑤据此给出“按 B10 或 B5 设定更换周期”的建议;若你的数据算出 β 显著小于 1,正确动作是加强老化筛选与来料把关,而不是照搬定期更换。所以 β 的方向必须先看似然比检验和 β 的置信区间是否跨过 1,不能只看点估计。
- 单一 β 假定只有一种失效模式;两种机理混在一起会把 B10 系统性抬高。 卡⑤的局限一栏写明:产品若同时存在早期缺陷与耗损两种机制,概率图会出现折点,此时拟合出的单一 β 是两种机制的加权折中,B10 会被高估——也就是保修期被定得过长。判断依据是卡③的 Weibull 概率图:点列应当沿一条直线,出现明显弯曲或折点就要怀疑混合模式,不能只看 KS 检验的 p 值。
- “未拒绝 Weibull”不等于“数据服从 Weibull”。 演示数据 KS 的 D=0.0587、p=0.993,PPCC 的 r=0.9956、p=0.973,看着漂亮,但拟合优度检验的逻辑与所有分布检验一样:只能拒绝,不能证明。样本量不大时几乎什么分布都不会被拒绝。真正有说服力的旁证是报告给的两条:概率图的线性度,以及非参数 KM 中位寿命(演示 738.100)与参数法 B50(704.705)是否接近。
- 标了“外推”的行,数值完全由分布假设决定。 卡④的 R(t)/h(t) 表把超出观测寿命范围 39.800~2195.000 的行明确标注了出来(演示是 t=2341.333 与 2634.000 两行)。同样的道理适用于极端下尾:B1=69.108 远在最小观测值 39.800 之上,看似安全,但它靠的是 Weibull 左尾的形状假设,而这个区域几乎没有数据支撑。卡④的结论文案写明各指标的置信区间只反映参数的抽样误差,不包含“分布族是否选对”这一层不确定性。
- 删失记录的信息量低于失效记录,删失率高时 β 会很不稳。 右删失只告诉你“活过了这个时刻”,不提供失效时刻。演示数据删失率 22.50%(93 失效 / 27 删失),卡①的样本构成表在“删失率”这一行的说明列里把这层关系写了出来。删失率越高,同样的样本量对应的有效信息越少、β 的置信区间越宽,而 B10 与 MTTF 都是 β 的非线性函数,区间会被进一步放大。看到 β 的区间跨度很大时,先看的应该是失效点数而不是急着解释点估计。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据与删失结构、分布拟合优度
- 输出结果二:Weibull 参数估计与形状检验(主结果)
- 输出结果三:概率图、可靠度曲线与失效率曲线
- 输出结果四:可靠性指标、R(t)/h(t) 与拟合逐点对照
- 输出结果五:结论与解读
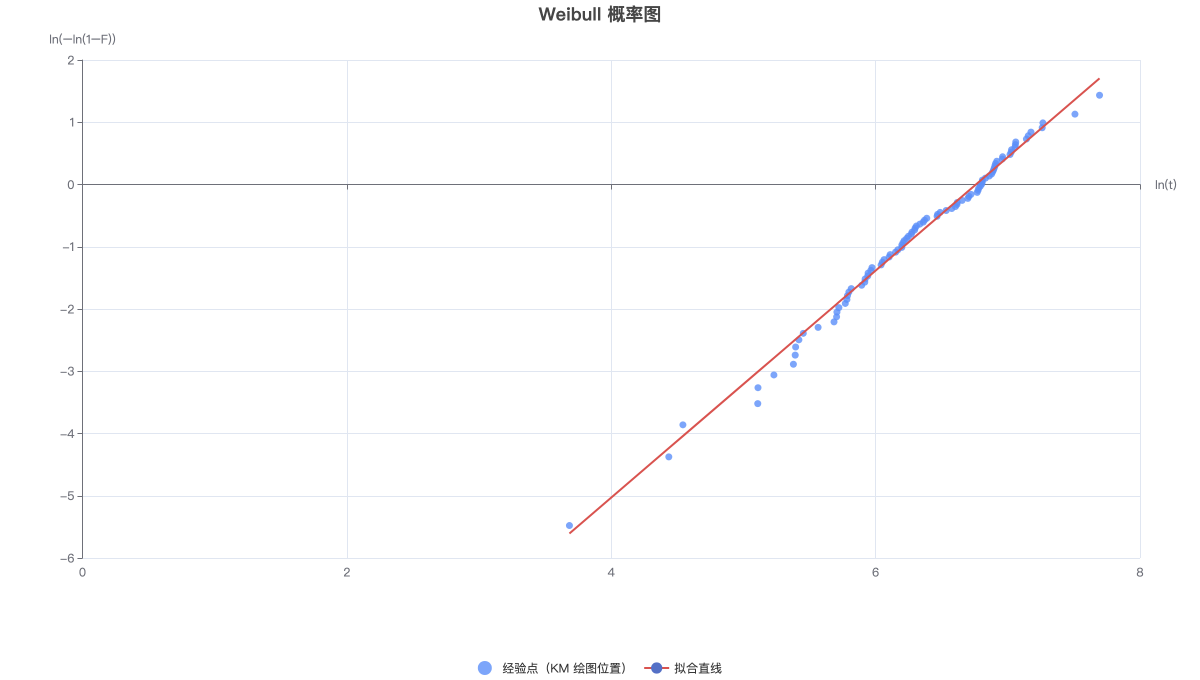
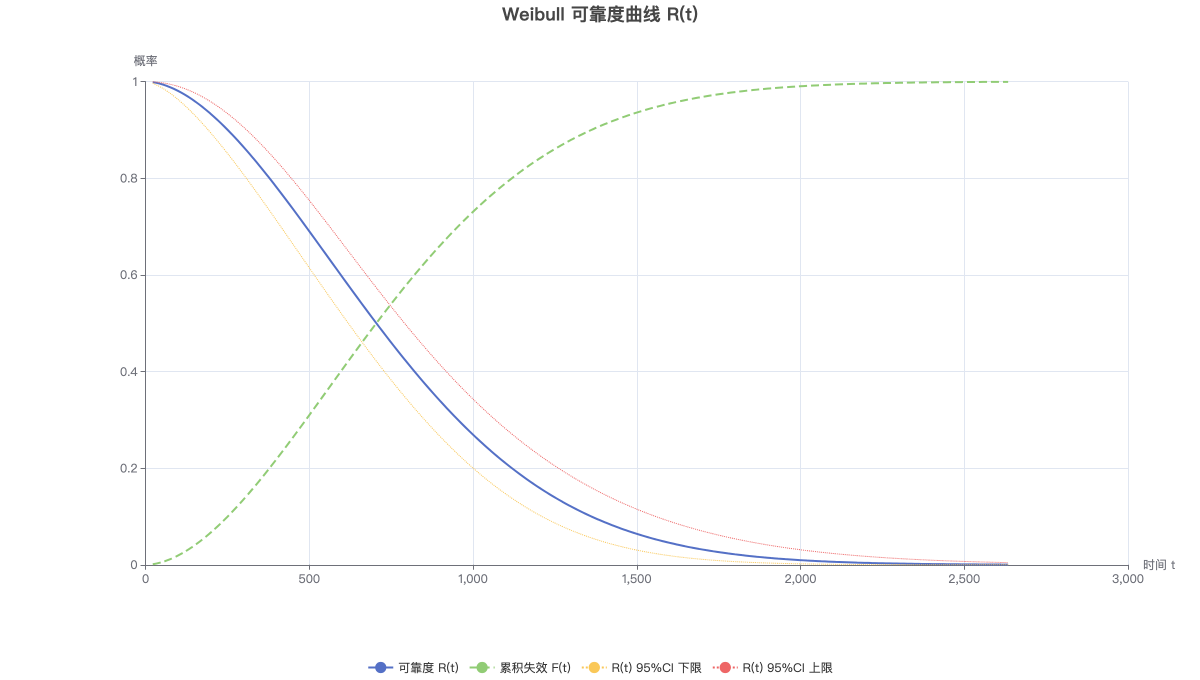
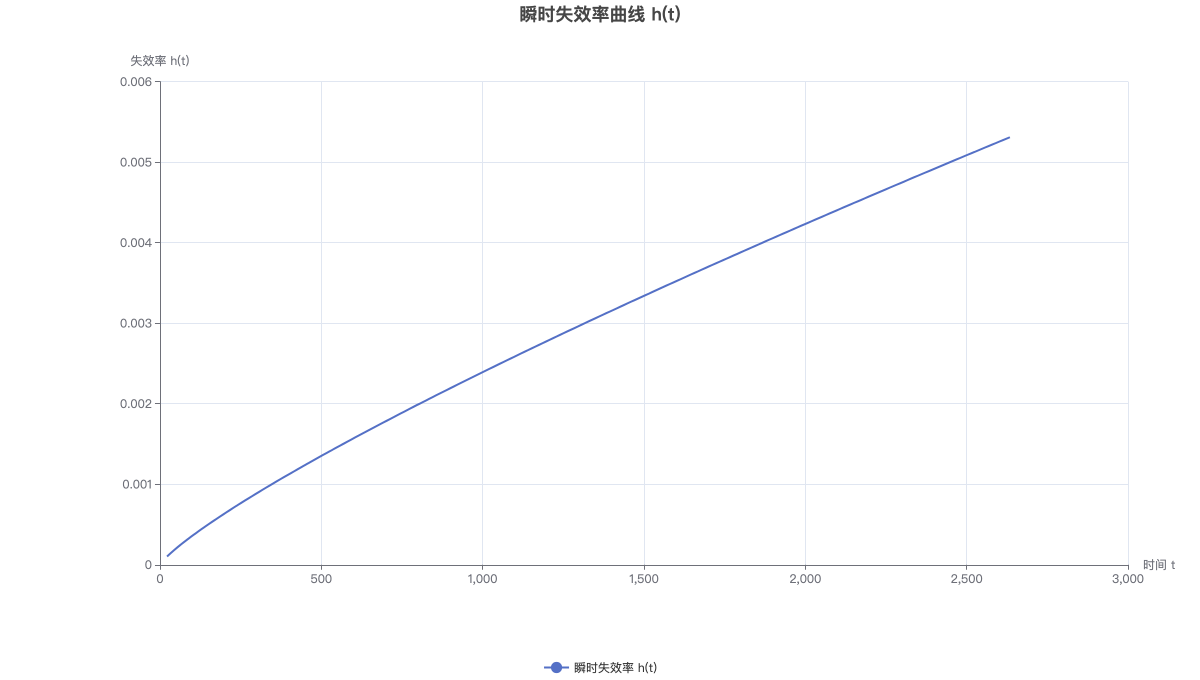
第一张为 Weibull 概率图:横轴 ln(t)、纵轴 ln(−ln(1−F)),Weibull 分布在该坐标下应呈直线,直线斜率即 β;点列偏离直线的形态(弯曲/折点)是判断分布族是否选对、是否存在混合失效模式的主要依据。第二张为可靠度 R(t) 与累积失效 F(t)(含 R(t) 的 95% 置信带),第三张为瞬时失效率 h(t)。三图均可用切换器在图/表间切换。