
泊松分布检验
这个方法是做什么的
手里有一列非负整数计数——每天的事故起数、每小时的到达人次、每台设备的故障次数——想知道它是不是服从泊松分布,也就是“事件彼此独立发生、平均发生率恒定”这套假定站不站得住。做法是用样本均值估出 λ̂,按泊松分布算出每个计数值的理论期望频数,再和实际频数比。它是分布拟合检验,不是回归:这里没有自变量,回答的只是“这一列数长得像不像泊松”。可选的“加权项”是真正的频数列(该计数值出现了多少次),必须是非负整数。
报告给两条彼此独立的判据,卡⑤ 把它们合成一个“综合判定”,两者不一致时明确拒绝下单方面结论。第一条是拟合优度:Pearson 卡方与似然比 G²(自由度 = 组数 − 1 − 1,减掉的是总频数约束与从数据估出的 λ),外加逐个计数值的观测频数、期望频数与 Pearson 残差。第二条是离散指数 D = s²/x̄ 的条件方差检验,原假设是 D = 1。效应量是 Cohen's w(等于 χ²/N 的平方根),配非中心卡方反演出的 95% 区间;λ̂ 的区间用 Garwood 精确法,下限不会越出 0。
需要准备什么数据
- 计数变量 (必选):定量变量(数值)
- 加权项 (频数列, 可选)(可选):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 判断质检不合格数、事故起数、呼叫中心来电数这类计数能不能用泊松模型描述
- 建计数回归之前先确认泊松族够不够用,还是一开始就得上负二项
- 手上是“计数值 → 出现次数”的汇总频数表(计数值放计数变量、频数放加权项)
- 想回答“事件是不是随机发生、有没有聚集”这类实质问题
计数变量必须是非负整数,含小数或负值直接报错,不会静默取整;加权项同样必须是非负整数——小数频数会让表格展示的实际频数与卡方的计算口径分裂成两套。卡方近似要求各组期望频数不宜过小,卡① 会报“期望频数 < 5 的组数”,经典建议是这类格不超过 20% 且无一格小于 1。有效观测建议在 20 以上。
什么时候不要用它
- 想知道自变量怎样影响计数(年龄、剂量对发病次数的影响):这里根本没有自变量,用「计数数据回归」。
- 离散指数显著大于 1(过离散):泊松的“均值 = 方差”不成立,改用「计数数据回归」并在模型下拉里选负二项回归。
- 0 特别多、明显超出泊松预期:用「零膨胀计数回归(ZIP/ZINB)」。
- 各观测的暴露量不同(随访人年、机时长短不一):“同一个 λ”的前提本身就不成立,而本模块没有暴露量入口。出路是先按暴露量分层、在暴露量相同的子集内分别检验,或改用「计数数据回归」把暴露量的对数当作一个自变量放进模型,并在文中说明这是近似做法。
- 数据其实是分类变量的列联频数(性别 × 是否患病),不是“某个数值出现了多少次”:用「卡方检验」,三个分类变量时用「对数线性模型」。
- 要检验的是一个分类变量的分布是否符合给定的理论比例:用「卡方拟合优度检验」。
容易误读的地方
- 分组不是固定的:组数与边界随 λ̂ 和样本量走,所以 χ² 和自由度没有跨数据集的可比性。 模块从计数 0 起累加期望频数,累计够 5 才切一组(Cochran 对卡方近似的经验要求),尾组期望不足则并入前一组。本文示例 λ̂ = 3.220、200 个观测切成 8 组(0…6 与“≥7”),df = 6,卡① 报“期望频数 < 5 的组数 0 / 8”;换一份 λ̂ ≈ 25 的数据会切成十几到二十组、df 也跟着变。要对比两次分析,比 p 与结论,不要比 χ² 的大小。
- “不显著”不是“服从泊松”。 这个检验的原假设就是“服从泊松”,不拒绝只说明现有数据没能否定它——样本小、分组粗、期望频数不足时检验功效很低,什么都拒绝不了。模块自己在解释边界里写明了这一点,也正因如此才要求拟合优度与离散指数两条判据同时通过,才肯给出“支持泊松”的综合判定。反过来,大样本下极小的偏离也会显著,这时看 Cohen's w:w 小于 0.1 时泊松在实用上仍然可接受。
- 两条判据查的不是同一件事,冲突时别只挑合意的那条。 卡方拟合优度看的是分箱之后的整体形状,离散指数只查“均值 = 方差”这一条,直接用 s² 与 x̄ 算、不受分组影响。二者可以给出相反结论:一份 200 个观测、均值 12.070 的数据,卡方切成 14 组、χ²(12) = 9.391、p = 0.669 完全不拒绝,而离散指数 D = 0.776、χ²(199) = 154.351、p = 0.017 判出欠离散,综合判定随即拒绝下结论、建议扩大样本或做稳健性对照。D 显著大于 1 是过离散,显著小于 1 是欠离散(数据比泊松更规整)。
- 逐格残差的两条阈值不能混用,也不宜单独当作结论。 表里的“偏离”标记是未校正的 |r| > 1.96,“显著偏离”标记是按实际组数做 Bonferroni 校正后的临界值——本文示例 8 组对应 |r| > 2.734,组数一变这个阈值就跟着变。只有校正后仍达标的格才宜写进结论(示例这 8 格残差都在 ±0.71 以内,一格都没标)。另外这里用的是 Pearson 残差(观测减期望再除以期望的平方根),在期望频数很小的格上正态近似很差,尾组尤其如此。
- λ̂ 就是样本均值,它的置信区间说的是“均值估得准不准”,与“分布是不是泊松”无关。 卡② 把 λ̂ 的 Garwood 区间和两个拟合优度检验并排放在同一张表里,容易读成三条互相印证的证据,其实不是:区间再窄也只是说 λ 估得精确,那是在已经假定泊松成立的前提下算出来的。判断分布形态成不成立,看的是同一张表上面两行的 p 值,以及卡④ 的离散指数。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:泊松分布拟合优度检验
- 输出结果三:实际频数与期望频数分布图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
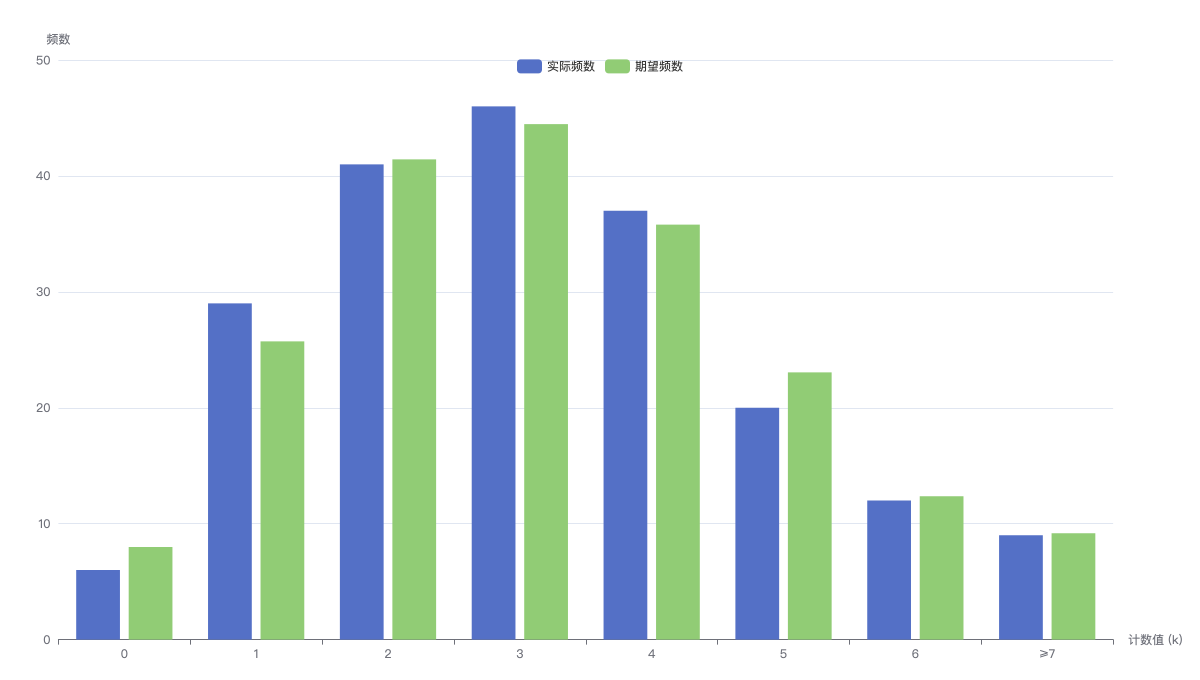
此图以图形化方式展示实际观测数据与泊松理论模型的拟合情况;可用右上角切换器在柱形图/条形图/折线图/表格之间切换。