
分层聚类
这个方法是做什么的
这里的分层聚类做的是 R 型层次聚类:聚类对象是变量,不是数据行。它先对每个变量做 Z-score 标准化,再把数据矩阵转置,以“1 − Pearson 相关系数”为距离度量、用组间平均链接(UPGMA)自底向上逐级合并,最后按你指定的聚类个数在树上横切一刀,给出每个变量归属哪一类。它回答的是“这批指标里哪几个其实在测同一件事”,不是“这批客户能分成几群”。
除了归属表,报告还给这些:各类别的规模与成员清单、簇内平均相关 r̄ 以及该簇与其它簇的平均相关(前者明显高于后者,才说明这一簇确实抓住了一组同质变量);第三张卡的谱系图(横轴刻度就是合并距离)与按聚类顺序重排的相关热力图;第四张卡的同表相关系数(cophenetic correlation,衡量树状结构对原始距离矩阵的保真度)、平均轮廓系数、Calinski-Harabasz 与 Davies-Bouldin 指数,以及簇数敏感性表——从 k = 2 扫到“变量数 − 1”与 10 里的较小者,每一行都真的把同一棵树重切一次(示例 8 个变量故扫到 k = 7;变量再多也止于 k = 10)。
需要准备什么数据
- 放入 [定量] 聚类变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 问卷或指标体系有几十个变量,想先看它们实际扎成了几堆
- 做回归或综合评价之前,想把重复测量同一件事的指标并成一个综合指标
- 想给一张大相关矩阵一个可读的组织方式:谱系图加按簇重排的热力图
- 只想知道某个指标到底和哪一组指标更近
拖拽区只收定量变量,至少放 2 个,且变量个数必须大于聚类个数。不得含常数列——零方差列与任何变量的相关系数都无定义,会让距离矩阵出现非有限值。相关系数的稳定性取决于观测行数,要求有效观测不少于 10;行数太少时整棵树都不可信。距离度量与聚合方法在本模块是写死的,界面上只有“聚类个数”一个控件。
什么时候不要用它
- 你想分的其实是样本,不是变量(把客户分成几群):这是最常见的走错门。样本分群用「聚类分析(K-Means)」;需要把离群样本单独识别出来用「密度聚类(DBSCAN)」;数据里同时有定量与定类变量用「二阶聚类」。
- 你要的是连续载荷而不是硬划分:R 型聚类把每个变量只分给一个类别,横跨两个维度的变量会被迫二选一,且看不出它跟第二个维度的关系有多强。允许一个变量同时在多个因子上有载荷的是「因子分析(探索性)」;只做纯数学降维用「主成分分析(PCA)」。
- 变量之间可能是非线性关系:1 − Pearson r 只捕捉线性关联,U 形或阈值型的依赖会被当成“不相关、距离远”。只关心单调关系时先用「Spearman相关分析」核对;想在二维图上看变量间的整体接近关系用「多维尺度分析(MDS)」。
- 真正要回答的是“这些题能不能合并成一个维度分”:聚在一起只说明相关高,答不出内部一致性。合并前用「信度分析」看 Cronbach's α 与校正题总相关,用「效度分析」核对题项是否按理论归位。
- 变量全是定类的:本模块只收定量变量,Pearson 相关对无序类别没有意义。看两个定类变量的关联结构用「对应分析」,多个定类变量用「多重对应分析」。
- 观测行数只有几十行:相关系数本身抖得厉害,树形换一批数据就变。此时退回「Pearson相关性分析」看相关矩阵与各自的显著性,不要把聚类划分写成结论。
容易误读的地方
- 把它读成“样本分群”,会得到彻头彻尾错误的结论。 第一张卡第一行明写“聚类对象:变量(R 型聚类)”,第二张卡给的表是“变量名称 → 所属类别”。示例中 180 个观测自始至终是 180 个观测,被分成 3 类的是那 8 个指标。如果你需要的是给每一行贴一个类别标签,本模块从头到尾不产出这样一列。
- 距离是 1 − r,所以强负相关会被判成“最远”。 r = −1 时距离取到最大值 2。“满意度”与“抱怨率”测的是同一件事的两端,本该归为一组,在这个度量下却被推到最远。指标体系里若有正反向计分的题,必须先在数据处理中把反向题反转再拖进来——这一条模块不会替你检查,也不会报警。
- 同表相关系数高,不代表簇数切对了。 示例的 cophenetic r = 0.9880,模块判读为“树状图很好地保留了原始距离结构”,但表注同时写明它与簇数无关:它衡量的是“用一棵树概括这批距离失真多大”,不是“切成 3 类对不对”。簇数合不合适只能看第四张卡的敏感性表——示例里轮廓系数在 k = 3 处最大(0.6934),而 DB 指数一路降到扫描末端 k = 7 才最小(0.2540),两个指标指向不同的 k 是常态。
- 簇内平均相关必须和跨簇相关比着读。 示例三个簇的簇内 r̄ 为 0.7763 / 0.7174 / 0.7107,而它们与其它簇的平均相关只有 0.0684 / 0.1029 / 0.1037,差距悬殊才说明簇抓住了同质变量。若某簇的簇内 r̄ 并不明显高于它的跨簇相关,那一簇就是横切出来的,不是数据里本来有的。另外只含 2 个变量的簇,它的“簇内平均相关”就是那一对的相关系数本身,不构成额外证据。
- 距离度量与聚合方法换不了,所以这份划分不是唯一解。 界面上只有聚类个数可调,1 − Pearson r 与组间平均链接是固定的。层次聚类的结果对这两个选择相当敏感,换 ward 或 complete 链接常会得到不同的树。论文里要把它写成方法限制如实交代,而不是当作稳健性已经验证过——本模块没有做过这项验证。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:变量类别归属与簇结构
- 输出结果三:聚类树状图与相关热力图
- 输出结果四:聚类质量指标与簇数敏感性
- 输出结果五:结论与学术表述
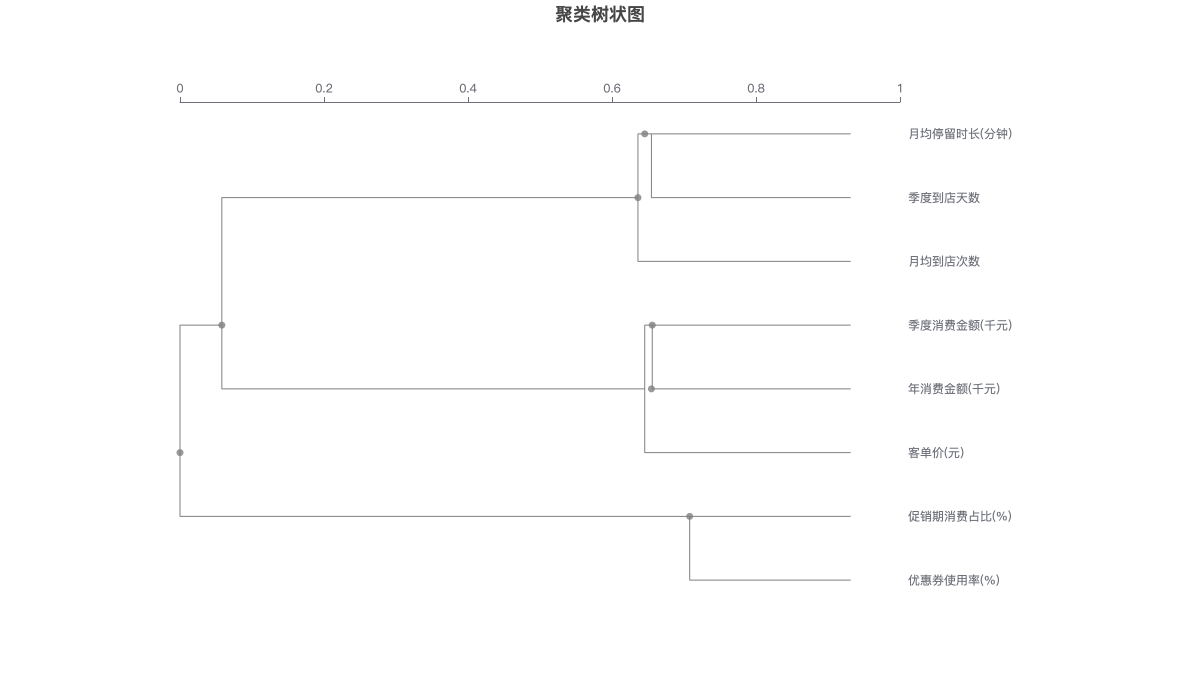
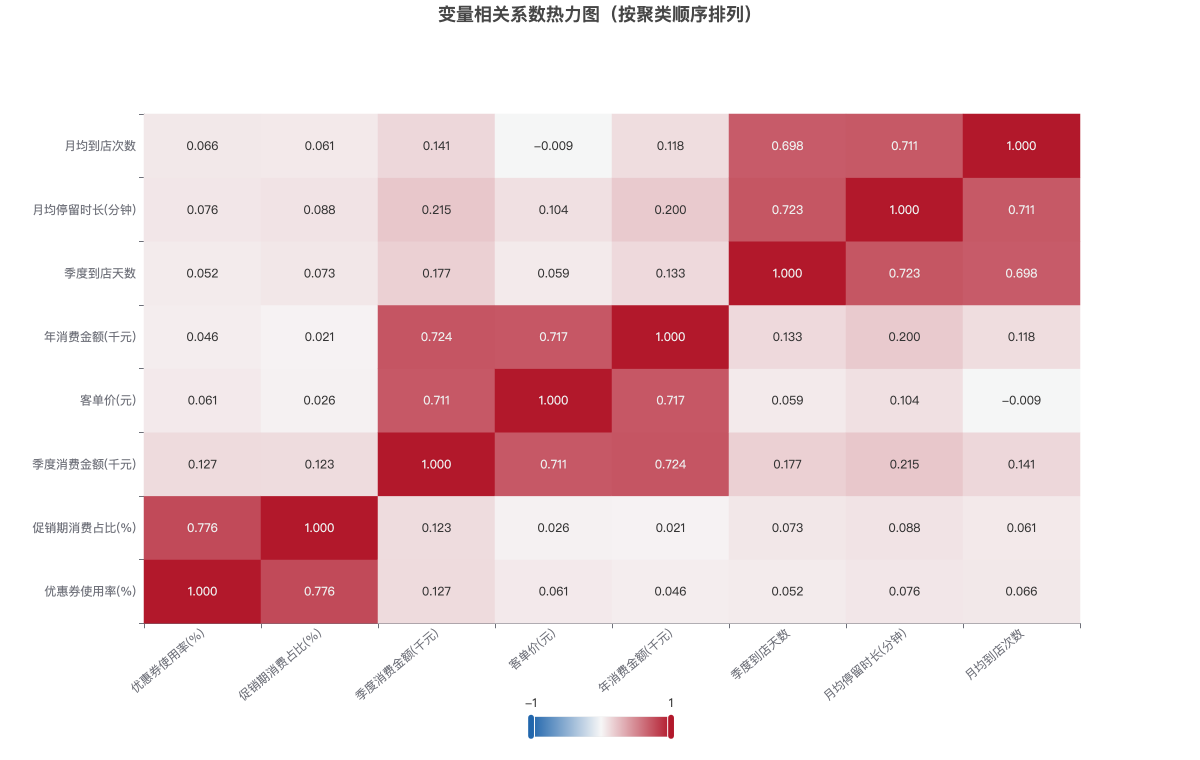
上图为变量的聚类谱系图:横轴刻度为聚类合并的「距离」(1 − 相关),距离越小表示变量关系越近;下图为按聚类顺序重排的相关系数热力图,同簇变量相邻,因此同质簇会呈现为对角线上的红色方块。