
二阶聚类
这个方法是做什么的
二阶聚类是四个聚类模块里唯一为混合类型数据设计的:定量变量走 Z-score 标准化,定类变量走独热编码——不给类别强加顺序,这正是它相对 K-Means 与 DBSCAN 的关键差别——再一起进入欧氏距离,用 Birch 算法自底向上聚合。两个拖拽区是分开的:定量区至少放 1 个,定类区可以放 0 个,同一个变量不能同时出现在两边。簇数既可以自己填(2~15),也可以打开“自动选择聚类个数”,让它按施瓦茨贝叶斯准则(BIC)在 k = 2~15 里取最小者——k = 1 只作对照,永不参选。
报告的重点在两处。第二张卡列出 k = 1~15 的 BIC、BIC 变化量、BIC 变化比率与平均轮廓系数:k ≥ 2 的每一行都真拟合一次 Birch,k = 1 行则是把全体当成单簇直接算出的基线;随后给最终划分的各簇规模、Wilson 95% 置信区间与簇内平均到质心距离。第四张卡给轮廓系数、Calinski-Harabasz 与 Davies-Bouldin 指数及逐簇轮廓系数,给定量变量的簇间均值差异(F、p、η²)与每个定类变量在各簇的分布(χ²、Cramér's V),再做 5 次 Bootstrap 重抽样重新拟合、报告与主结果的调整兰德指数(ARI)。
需要准备什么数据
- 放入 [定量] 变量 (变量数≥1)(可选):至少 1 个,定量变量(数值)
- 放入 [定类] 变量 (变量数≥0)(可选):至少 0 个,定类变量(分组/标签)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入 [定类] 变量 (变量数≥0)」的类别数需在 2~20 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 数据里同时有金额、频次这类定量变量,和会员等级、渠道来源这类定类变量
- 不确定该分几类,想先让 BIC 给一个自动建议,再人工核对是否可解释
- 需要一个对样本扰动做过检验的划分(四个聚类模块里只有它用 Bootstrap 重抽样查稳定性)
- 想一次看全 k = 2~15 的簇数评估,而不是只比较一两个候选值
数据要求:定量区至少 1 个变量;定类变量的水平数需在 2~20 之间,超过 10 个水平时独热编码会产生大量稀疏维度,建议先归并低频类别;有效行数不少于 20、缺失比例不超过 20%、不得含常数列;两个拖拽区不得放入同一个变量。
什么时候不要用它
- 参与聚类的全是定量变量,而簇的形状可能不规则或存在离群点:二阶聚类同样按欧氏距离聚合,对细长簇与离群样本没有特殊处理。要把离群点单独识别成一类用「密度聚类(DBSCAN)」;簇大致球形、还想要初始化种子稳定性检验的用「聚类分析(K-Means)」。
- 变量全是定类的:定量区至少需要 1 个变量,全定类跑不起来。但这不等于分不了群:把其中一个本来就有序的定类变量(学历层次、会员等级、满意度)用“数据编码”转成数值列放进定量区,其余原样放定类区即可——实测 240 行三个定类变量照此跑通、给出 3 个簇,且只有那一个真有序的变量被 Z-score 处理。若只是想看定类变量之间的关联结构而不要分群标签,用「多重对应分析」,两个定类变量用「对应分析」,只看交叉构成比用「列联(交叉)分析」。
- 定类变量的水平特别多(几十上百个城市、SKU):数据校验把水平数卡死在 2~20,且独热维度会稀释定量变量的贡献。先在数据处理里把低频类别归并;如果目的本来就是看这个高基数变量与其它变量的对应关系,用「对应分析」更合适。
- 你要分组的是变量而不是样本(“这些指标聚成几个维度”):本模块聚的是数据行。变量分组用「分层聚类」,需要连续载荷用「因子分析(探索性)」。
- 样本已经有现成的分组标签:那是有监督问题。描述各组特征用「分类汇总」,检验组间差异用「单因素方差分析」,用特征去预测已知类别用「随机森林分类」。
容易误读的地方
- BIC 与轮廓系数常常指向不同的 k,而你填的那个可能两个都不是。 示例数据里 BIC 最优 k = 7、轮廓系数最优 k = 3、最终采用 k = 2——三个数字互不相同。第一张卡会打出两条“[注意]”指出这个分歧,然后按你的设定出全套结果。还要留意第二张卡未必列列都填得满:示例里 k = 8~15 共 8 行的 BIC 三列全是“不可估计”,两个指标能对照着读的其实只有 k = 2~7 六行。两者不同源:BIC 权衡的是拟合优度与模型复杂度,轮廓系数看的是几何分离度。还要注意本模块的 BIC 是“按簇拟合高斯、取 −2LL + m·ln(n)”的近似实现,模块自己声明它并不完全等同于 SPSS 的二阶聚类 BIC,只能在同一数据集的不同 k 之间横向比较,绝对值不可跨数据集比。
- Birch 可能形成比你请求更少的簇,而稳定性检验用的是实际形成的那个数。 第四张卡 Bootstrap 表的表注写明:重抽样重跑时簇数取“最终实际形成的簇数”,不是控件里请求的簇数;因此 ARI = 1.0000 回答的是“你实际拿到的这份划分在样本扰动下能否复现”,而“按请求的簇数重跑是否稳定”是另一个问题,模块明确声明不作评价。读结果前先核对第四张卡首行的“最终簇数 k”是不是你填的那个。
- 独热编码解决了“强加顺序”,但没解决“权重”。 一个 8 水平的定类变量会展开成 8 个 0/1 维度,在总共十来维的特征空间里可能压倒全部定量变量——第五张卡的解释边界原话是“独热编码后的定类变量在欧氏距离下的贡献与其水平数相关,高基数变量会被放大”。示例中只有一个 3 水平的会员等级,划分就几乎与它一一对应:定类分布表里 Cramér's V = 1.0000,第二簇是清一色的金卡会员。
- 画像表的 p 值是事后的,Cramér's V = 1.0 更不是“发现”。 第四张卡两张画像表(定量的 F/η²、定类的 χ²/Cramér's V)都在表注里写明:簇本身就是为最大化组间差异而构造的,p 值必然偏小,不能当作簇真实存在的证据。上一条那个 V = 1.0000 读起来像“会员等级与分群完美关联”,实际含义只是“这份划分基本上就是按会员等级切的”——是输入主导了输出,不是从数据里发现了什么。它们唯一的正当用途是排序各变量的区分贡献。
- BIC 假定簇内近似高斯,右偏数据会让自动选簇失真。 数据要求里明写这一条。消费金额、停留时长这类天然右偏的变量占多数时,自动选出的 k 不可轻信,应当交叉看同一张表的轮廓系数列;也可以先用「数据变换(Box-Cox/Yeo-Johnson)」把偏态压下来再重跑,并在论文里写明做过这一步。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:簇数评估与簇规模
- 输出结果三:簇数选择曲线与簇规模分布
- 输出结果四:聚类质量、变量画像与稳定性检验
- 输出结果五:结论、学术表述与聚类标注
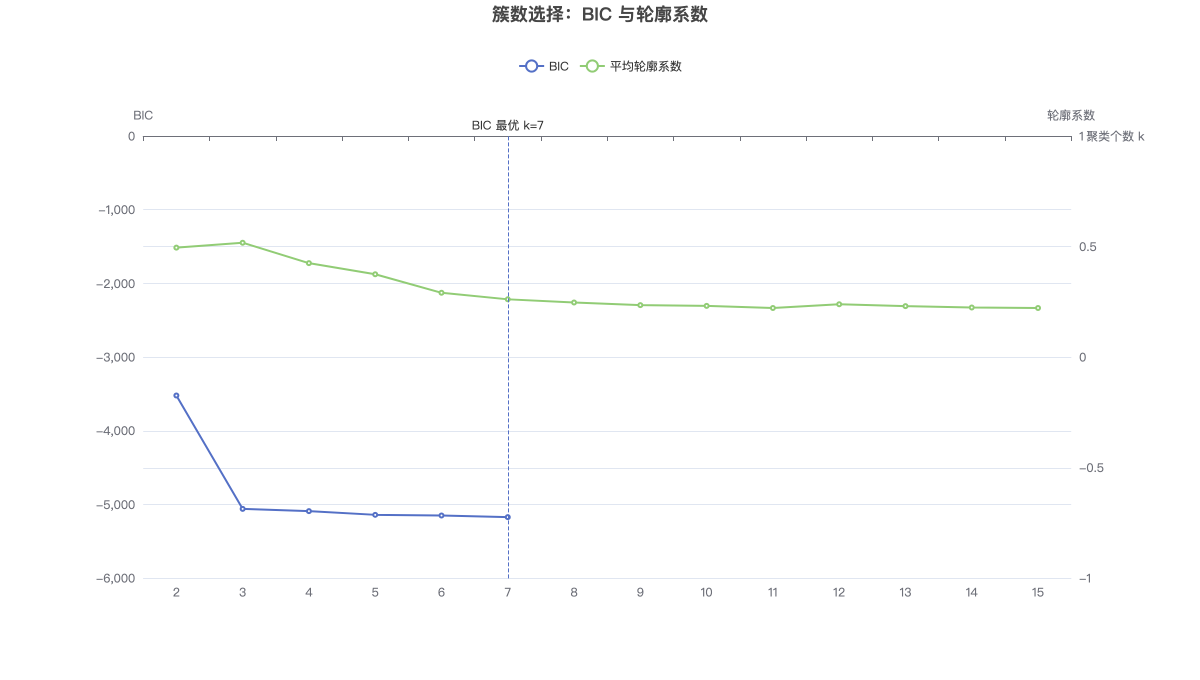
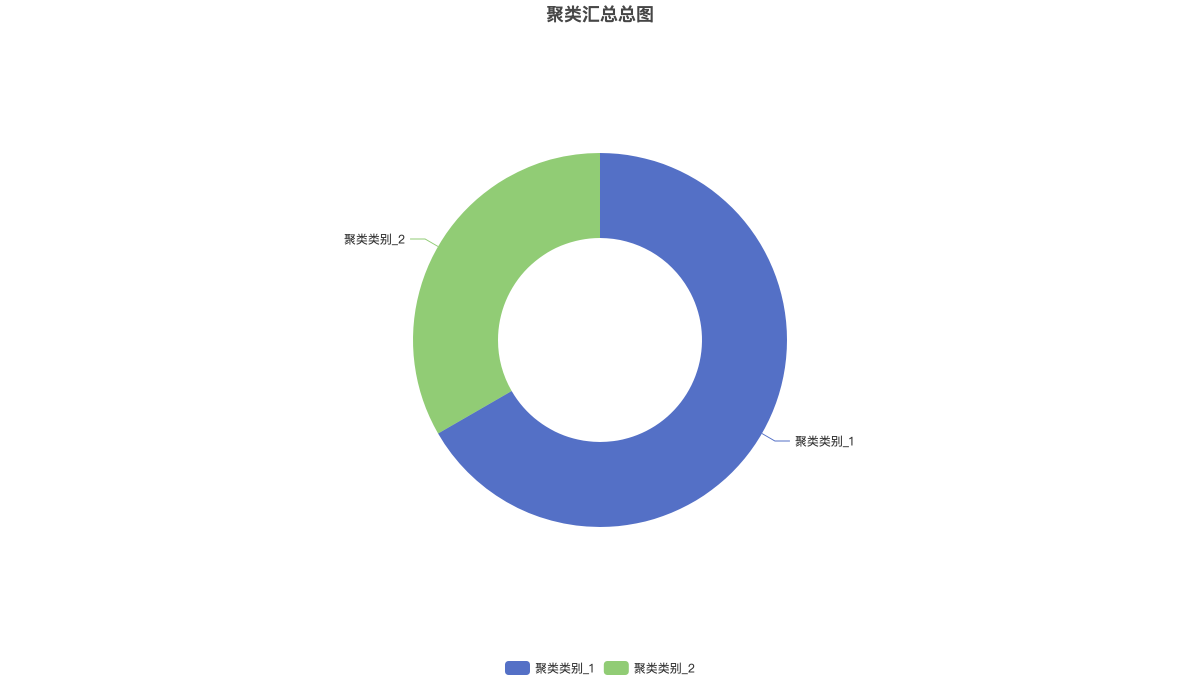
上图把 BIC 与轮廓系数画在同一 k 轴上:BIC 取最小值处、轮廓系数取最大值处各自给出一个候选簇数,二者重合时簇数选择最可信。 下图为最终划分的各簇规模分布。