
面板模型
这个方法是做什么的
数据是 N 个个体 × T 个时期的二维结构(多家公司多年、多个地区多期)时,同一个体的多期观测显然不独立,直接把它们混在一起做回归会低估标准误。本模块一次估出三套设定:混合回归 POOL(当作没有面板结构)、随机效应 RE(个体效应是随机的、与解释变量不相关)、固定效应 FE(把个体固有且不随时间变的差异全部吸收掉),并用三个检验帮你选。所有系数表都采用按个体聚类的稳健标准误。
除了三张系数表,第一张卡把每个变量的总体标准差拆成组间(between)与组内(within)两部分,并逐个标注“组内变异充足,可由固定效应识别”——因为固定效应只用得上组内变异。第四张卡给四种 R²(R²、within、between、overall)的横向对比,以及个体效应方差 σ_u²、特异误差方差 σ_e²、组内相关系数 ρ = σ_u²/(σ_u²+σ_e²) 和按组内标准差换算的 FE 标准化系数 β*。本模块特有的着眼点是:先看那张组间/组内分解表——一个几乎不随时间变的变量,在 FE 下的系数会既不稳定又难解释,这在系数表上是看不出来的。
需要准备什么数据
- 放入 [定量] 变量Y (变量数=1):定量变量(数值)
- 放入 [定量] 变量X (变量数≥1):至少 1 个,定量变量(数值)
- 放入 [定类] 分组项变量 (变量数=1):定类变量(分组/标签)
- 放入 [定类] 时间项变量 (变量数=1):定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入 [定类] 分组项变量 (变量数=1)」的类别数需在 3~5000 之间。
- 「放入 [定类] 时间项变量 (变量数=1)」的类别数需在 2~500 之间。
- 「放入 [定类] 分组项变量 (变量数=1)」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 面板数据,想扣掉“个体固有的、不随时间改变”的差异
- 需要一份能直接写进论文的 FE / RE 选择过程(F 检验、BP-LM、Hausman)
- 想知道总变异里有多大比例来自个体之间(组内相关系数 ρ)
- 想比较同一组变量在混合回归与面板设定下的差别
前提是个体 ID 与时间 ID 各拖入 1 个定类变量。个体数必须大于自变量个数 + 1,否则随机效应的方差分解会除零;每个个体至少要有 2 期观测,只有 1 期时组内变换后没有任何变异、固定效应不可识别。内置的 Breusch-Pagan LM 检验为手工实现,仅支持平衡面板,非平衡面板时会如实标注为未执行。
什么时候不要用它
- 被解释变量的滞后项要进模型:滞后项与个体效应相关,FE 会有偏,用「系统GMM动态面板」。
- 因变量是“是 / 否”或计数:本模块只做线性方程;要组内效应用「广义线性混合模型(GLMM)」,要总体平均效应用「广义估计方程(GEE)」。
- 只有一期截面数据:没有面板结构可言,用「线性回归 (最小二乘法)」。
- 嵌套结构不是“个体 × 时间”而是“学生在班级里、病人在医院里”:用「混合模型」,它的随机效应区可以放多个变量。
- 有明确的政策时点与处理组 / 对照组,要做的是政策评估:用「双重差分(DID)」。
- 关键解释变量本身内生,而你有外部工具变量:用「GMM 估计」。
容易误读的地方
- 三个检验会给出互相矛盾的三个答案,而“推荐模型”那一行只听 Hausman。 实测同一份数据:F 检验(H0:无个体效应)p < 0.001,结论列写“FE模型”;Breusch-Pagan LM 检验(H0:无随机效应)p < 0.001,写“RE模型”;Hausman 检验 p > 0.999,写“RE模型”;综合判定行给的是 RE,理由栏写“Hausman 检验 p>0.999≥0.05,未拒绝原假设,随机效应更有效率”。看到前两行打架不必困惑:它们回答的是“要不要用面板设定”,只有 Hausman 回答“FE 还是 RE”。另外表注注明“Hausman 检验内部使用非稳健标准误(该检验的有效性以此为前提)”,而系数表用的是聚类稳健标准误,两者口径不同。
- 勾上时间固定效应只是多出一张表,它不参与模型选择。 实测勾选后,第二张卡多出一张“时间固定模型”系数表、第四张卡的对比表多出一行,而第一张卡的三个检验与综合判定一字未变,仍推荐 RE。要不要控制时间效应得你自己论证。顺带一提,实测这份数据里同一个自变量的 p 值在 POOL 下是 0.047、在时间固定模型下是 0.058——换一套设定就跨过了 0.05,这类结论必须写明是在哪个模型下得到的。
- 四个 R² 不能跨模型排大小。 表注写死了“不同模型的 R² 定义不同,不能跨模型直接排序优劣”。实测 POOL 模型的 R² 只有 0.0321,可它的 R²(within) 是 0.5999;FE 模型的 R² 与 R²(within) 都是 0.6383。拿 POOL 的 0.0321 去说“混合回归拟合极差”是看错了列。固定效应该看的是 R²(within),因为它只利用组内变异。
- 不随时间变化的变量在 FE 下会被组内变换消掉,报告里根本不会出现它。 第五张卡的模型局限逐条列了这一点。性别、所在省份、成立年份这类变量放进固定效应会直接消失,这不是出错。想估这类变量的系数只能用 RE,而 RE 成立的前提正是“个体效应与解释变量不相关”——也就是 Hausman 在检的那件事。所以“我需要 RE 才能估这个变量”不构成使用 RE 的理由。
- ρ 很大只说明该用面板设定,不说明这个模型是对的。 实测 σ_u² = 1.0822、σ_e² = 0.0129、ρ = 0.9882,意思是总变异的 98.8% 来自个体之间的固有差异。但第五张卡的模型局限同时写着:所有模型均未做序列相关与横截面相关检验,若 T 较大应另行检验并考虑 Driscoll-Kraay 标准误。按个体聚类的稳健标准误能吃掉同一个体内部的序列相关,吃不掉不同个体在同一时期共同受冲击造成的横截面相关。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:各面板模型回归系数表
- 输出结果三:FE 模型系数森林图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
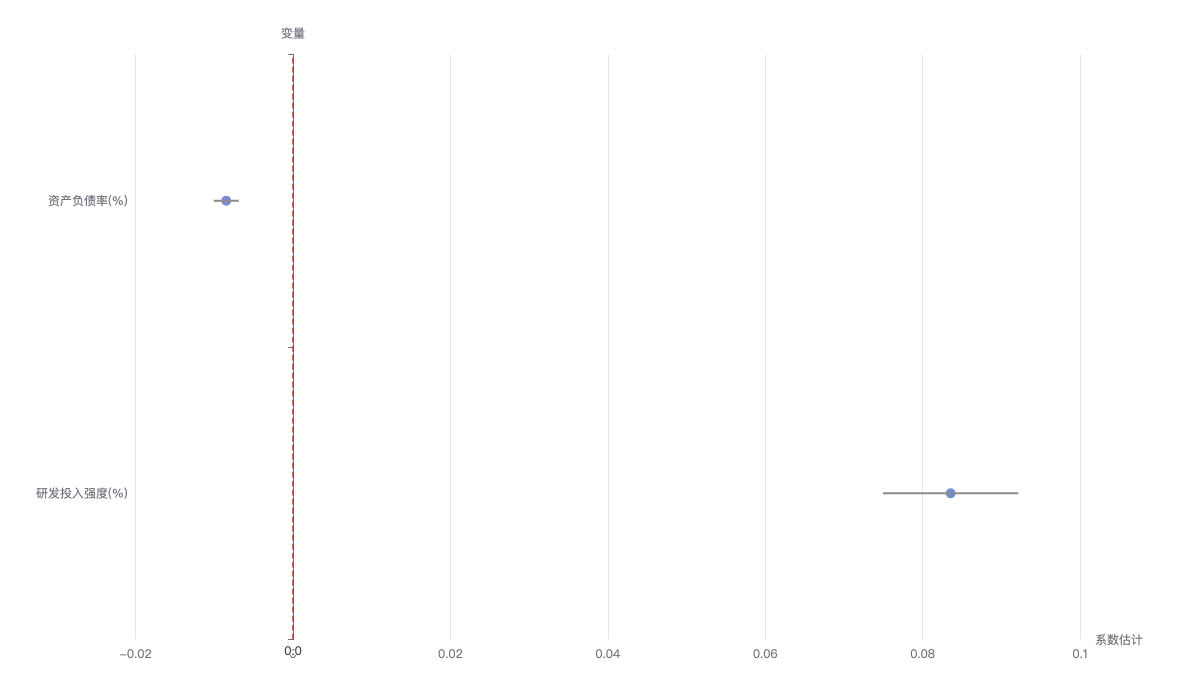
上图为 FE 模型 各解释变量回归系数的森林图(点=系数估计,横须=95%置信区间,口径与上方系数表一致:系数 ± 1.96 × 聚类稳健标准误)。为避免截距(const)量级过大压扁其余系数的置信须,本图已略去截距,仅展示各斜率系数。