
二项式检验
这个方法是做什么的
检验一个二分类变量里某一类的实际占比,与你事先给定的理论比例 p₀ 之间有没有差别。它只涉及一个变量、一个比例、一个外部参照值——既不是两组之间比比例,也不是多个类别的分布对照。p 值由二项分布逐项枚举求和得到,不做大样本近似,所以样本量再小也算得出来。
除了显著与否,报告还给出观察比例的 Clopper-Pearson 精确置信区间,以及四个尺度的效应量:率差、率比、比值比和标准化的 Cohen's h,每个都带 95% 区间。主结果表另外并列一个带连续性校正的正态近似 z 检验作对照,卡①会算出 np₀ 与 n(1−p₀),告诉你近似法在这份数据上是否也成立。检验比例 p₀、成功类别、备择假设(双侧 / 大于 / 小于)与置信水平都在控件里改。
需要准备什么数据
- 分析变量 (二分类):定类变量(分组/标签)
- 频数权重 (可选)(可选):定量变量(数值)
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「分析变量 (二分类)」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 二选一题目的选择比例是不是 50%
- 产品合格率有没有达到承诺的 95%
- 新药有效率是否高于文献报告的 30%(单侧)
- 出生性别比是否偏离 1:1
- 随机分组的实际分配比例是否偏离了预设的 1:1,用来检查随机化有没有失效
前提是 n 次观测互相独立、每次的成功概率相同(同一批个体被重复观测就不满足)。更关键的是 p₀ 必须是外来的:理论值、行业标准、历史文献、法规指标都行,唯独不能是从这批数据自己算出来的。还有一点别误会:控件里那个可选的“频数权重”区,并不意味着可以直接放一张“k 次成功 / n 次试验”的两行汇总表。本模块按整表行数要求至少 5 行,而成功、失败各一行的汇总表只有 2 行,必然被“当前数据表共 2 行,少于二项式检验所需的至少 5 行”挡在门外。要跑本模块就得给逐例明细数据,频数权重只在整表行数本身够的时候才用得上。
什么时候不要用它
- 变量有三个及以上类别:用「卡方拟合优度检验」,它检验的是整套类别比例是否符合理论分布。
- 要比的是两组各自的比例(男性合格率 vs 女性合格率):那是两个变量的关联,用「卡方检验」;期望频数偏小时用「Fisher精确检验」。
- 同一批人前后两次的达标比例:配对数据,独立性前提不成立,用「配对卡方检验」。
- 同一批人在三个及以上条件下的二分结局:用「Cochran's Q 检验」。
- 比的是均值而不是比例(平均分是否等于 60):用「单样本T检验」。
- 观测之间不独立(同一位患者多次给药、同一个班里的学生):精确检验一样救不了,需要「广义估计方程(GEE)」这类能给相关结构建模的方法。
容易误读的地方
- 哪一类算“成功”不是随便定的。 不填“成功类别值”时,系统取该列数据中首次出现的那个取值当成功类,并在摘要里补一句“未指定成功类别,系统默认将 X 视为成功”——这句提示很容易被跳过。p₀=0.5 且双侧时,换一类只是把率差与 Cohen's h 整体变号,p 值不变;但 p₀ 不等于 0.5 时,换成功类别等于换了一个完全不同的原假设(此时该拿来比的是 1−p₀),结论会直接错。单侧检验同理,方向反了会把显著变成毫无迹象。凡是 p₀≠0.5 或用单侧,成功类别必须手工填。
- p₀ 不能从同一批数据里来。 极端情形显而易见:拿样本比例当 p₀,p 值必然接近 1。常见的变体隐蔽得多——先看了数据、发现比例在 35% 上下,于是把 p₀ 定成 0.30 去“验证它高于 30%”。这时假设和证据出自同一份数据,p 值不再有原来的含义,也不能写成“显著高于 30%”。
- 卡①“正态近似适用性”那一行不满足,不影响精确检验。 前提核查表里 np₀≥5、n(1−p₀)≥5 被判成“不满足”时,很多人以为整个检验作废——恰恰相反:那一行是给并列的 z 检验用的,精确二项检验本来就是为这种场合准备的,表注也写明了这一点。反过来也要注意,“精确”指的是不做正态近似,不是结论更强:精确检验偏保守,实际的第一类错误率通常低于名义的 0.05,Clopper-Pearson 区间也比同置信水平的其他区间宽一些。区间比预期宽是方法本身的性质,不是算错了。
- 四个效应量讲的是同一件事,观感却差很远。 卡④同时给率差、率比、比值比和 Cohen's h。一个从 1% 升到 2% 的变化,率差只有 1 个百分点,率比却是 2 倍,比值比更大。选哪个尺度写进结论,取决于你的场景关心绝对量还是相对量——四个都摆出来,正是为了不让你只挑数字最好看的那个。
- 单侧检验必须在看数据之前定下来。 看到观察比例低于 p₀ 之后再把备择假设改成“成功比例小于 p0”,等于把双侧的显著性水平全部搬到一侧,实际的第一类错误率是名义值的两倍。研究问题若本来就允许两个方向偏离,就老实用双侧;单侧只有在“另一个方向的偏离在专业上无意义或不可能发生”时才站得住。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:二项式检验主结果表
- 输出结果三:可视化(频数对比与比例置信区间)
- 输出结果四:效应量与置信区间
- 输出结果五:结论与学术表述
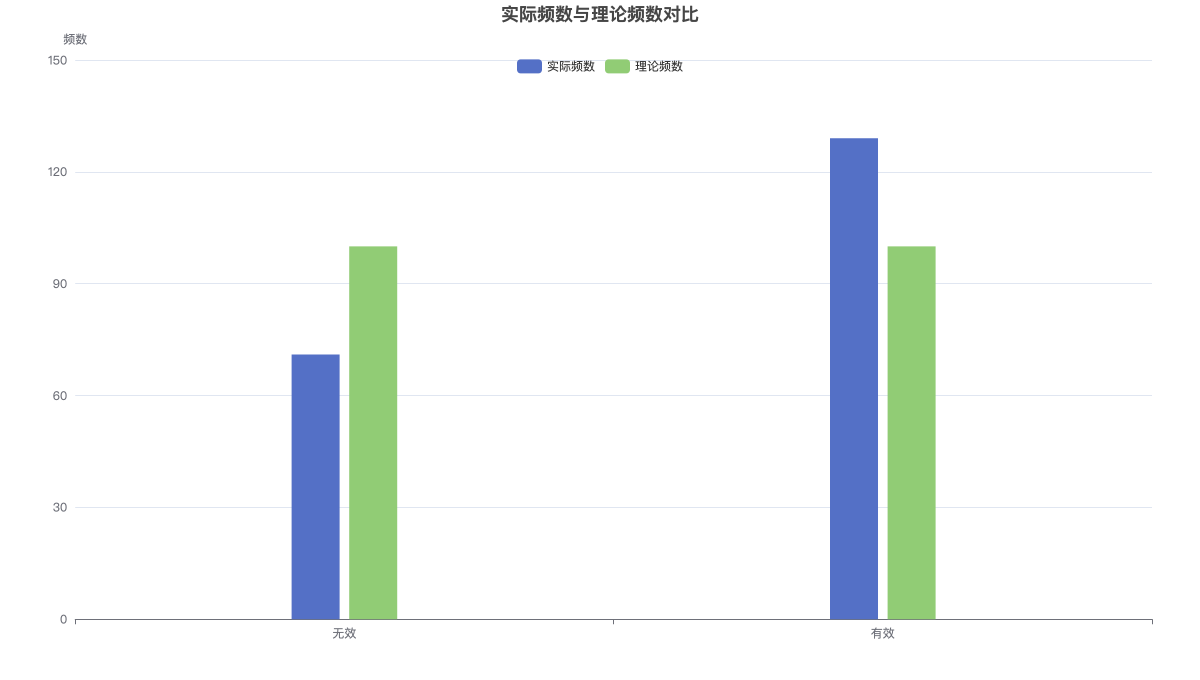
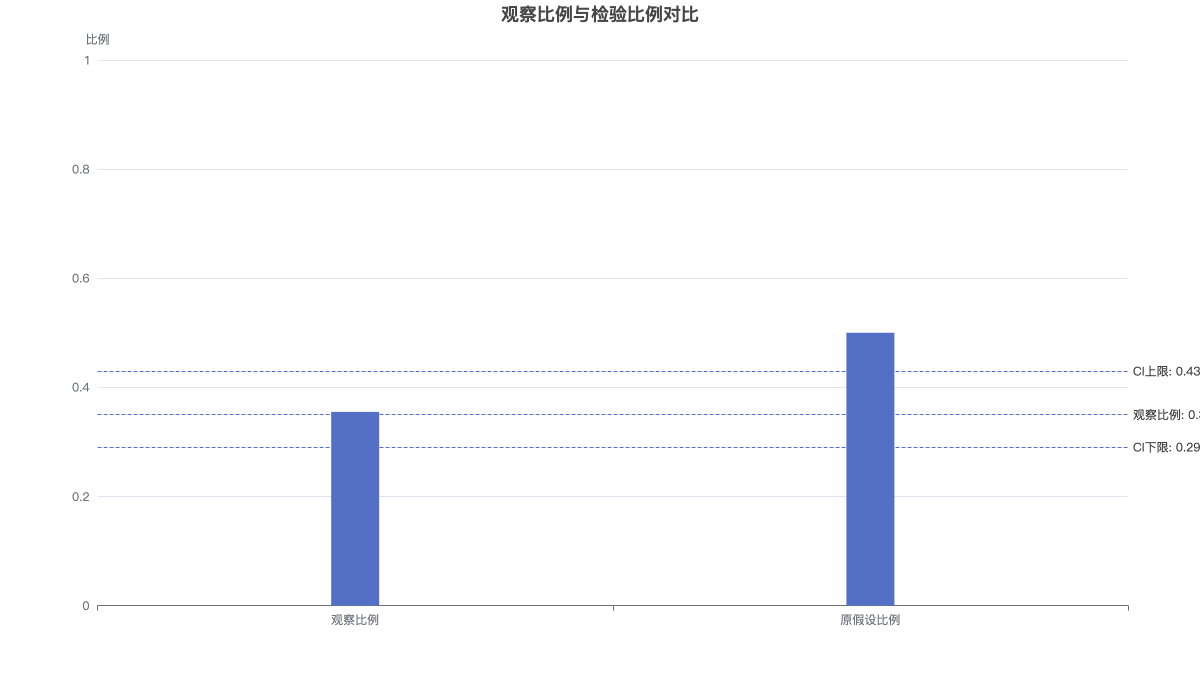
柱状图展示了成功/失败两类的实际频数与在原假设比例下的理论频数,有助于直观识别偏离方向与偏离幅度。 第二张图把观察比例、其置信区间与原假设比例放在同一坐标系中比较。