
配对样本Wilcoxon检验
这个方法是做什么的
「配对样本T检验」的非参数替代:同一批对象在两种条件下的测量,逐行相减得到差值,按差值的绝对值排名次,再按符号求秩和。和配对 t 检验一样,它真正分析的对象只有一列——差值;不同的是它只用差值的次序,所以一个离群的差值只贡献最大的那个名次,不会按其数值大小放大影响。
主结果表并排给出两次测量的中位数(Q1,Q3)、差值中位数、Hodges-Lehmann 中位数差及其分布无关 95%CI、W、Z 与 p。效应量卡给秩双列相关 r_rb = (T⁺−T⁻)/(T⁺+T⁻)、r = Z/√N 与正负符号秩和 T⁺/T⁻。第一张卡把四件事分行列出:差值的对称性(D'Agostino 偏度检验)、零差值与并列的数量、差值的正态性、有效非零差值对数。第三张卡画差值的直方图并叠一条正态参照曲线。两个拖拽区可以一次放多对变量,超过一对时第四张卡会多出一张 Holm-Bonferroni 校正表。
需要准备什么数据
- 变量1(定量):定量变量(数值)
- 变量2(定量):定量变量(数值)
数据要求
- 数据表至少 6 行。
- 单列缺失率不超过 20%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 同一批患者治疗前 / 治疗后的评分,且差值明显偏态或含极端值
- 同一批被试在两种界面下的任务完成时间(时长数据通常右偏)
- 一比一匹配的病例组与对照组在某个指标上的比较
- 结果是等级评分,相减只能当次序看
- 样本量小到差值的正态性无从判断
判断该不该配对的标准和「配对样本T检验」完全一样:你能说清楚第 i 行的两个数为什么属于同一个对象。两个拖拽区的变量个数必须相等,同一个变量不能同时出现在两边——它们按位置一一成对。差值分布要关于其中位数对称,且至少 6 对非零差值。缺失按成对删除:两列中任一为空,整对剔除。
什么时候不要用它
- 差值近似正态:用「配对样本T检验」,效能更高,而且给出的是带单位的均值差。第一张卡的差值 Shapiro-Wilk 不显著时,“判定”列会写“差值近似正态”、“影响”列会建议“可考虑改用 t 检验”——这条自动建议只能当提示:不显著只说明这批数据没检出偏离,小样本本来就检不出,它不构成“可以用 t 检验”的证据。用参数还是非参数,取决于数据类型与研究设计。示例里 S-W 的 p=0.106 被判成“近似正态”,同一张卡的对称性检验却 p=0.034 判为不满足——两条建议方向相反,照着 p 走会自相矛盾。
- 两列其实来自不同的人(一列是 80 位男性的得分、另一列是 75 位女性的得分):用「独立样本 Mann-Whitney U 检验」。按行号硬配两批无关的人,差值就没有意义了;两列长度不等时本模块也根本配不成对。
- 同一批对象测了三次及以上:用「多配对样本Friedman检验」。反复做两两配对检验会让假阳性膨胀,本模块的 Holm 校正管的是“多对不同变量”,不替代重复测量的整体检验。
- 两次测量都是二分类(前后是否达标):用「配对卡方检验」;三个及以上条件的二分类用「Cochran's Q 检验」。
- 你手上本来就只有一列差值、想跟 0 比:用「单样本Wilcoxon符号秩检验」,检验值填 0,数学上是同一个检验。
- 想在比较前后变化时扣掉某个协变量(比较改善幅度时控制基线值):秩检验没有对应版本,得转到回归框架,如「协方差分析」。
容易误读的地方
- 配对是按行号配的,配错了不会报错。 两个拖拽区里同一行的两个数被当作同一个对象的两次测量。如果数据导出时按某一列排过序,或者两列本来就来自不同的名单,算出来的差值就是一堆随机组合——W、Z、p、H-L 照样算得出来,报告上看不出任何异常。跑之前先确认两列行对齐,没有任何统计量能替你把关。
- 前提检验表里的星号表示前提被违反,不是通过。 那张表的表注专门用 ⚠ 强调过:星号的统计含义和全报告一致(该行 p 达到显著),但这张表检的是前提——对称性那行带星,意思是差值显著偏斜、前提没满足;正态性那行带星,意思是差值显著偏离正态,那反而是选本方法的理由。两行的星号指向相反的结论。各项成不成立,一律以“判定”列的文字为准,别数星星。对称性不满足时,最后一张卡的论文表述段会自动补一句提醒,说明关于“中位数 / 位置移动量”的推断存在偏倚——那句是给你看的,别顺手删掉再誊进论文。
- 主结果表里的 Z 恒为正,方向不在 Z 上。 本模块的 Z 是由 p 值反解出来的(取了绝对值),所以它只有大小、没有方向;示例里 Z=6.280 而 H-L 中位数差 = −6.360,两者并不矛盾。要判断谁高谁低,看 H-L 中位数差或 r_rb 的符号,并记住差值方向是“变量1 − 变量2”,取决于你把哪一列拖进了哪个区——负号只说明变量2那一列更大,不等于“下降”。顺带一提,「单样本Wilcoxon符号秩检验」的 Z 是带符号的,两个模块这一点口径不同;两处的零差值则都按 Pratt 口径处理(零差值参与排秩、其秩不计入 T⁺/T⁻),所以同一批差值在两处跑出的 p 只差一点连续性校正——本模块施加了,那边没有。而「多配对样本Friedman检验」的事后两两比较用的是剔零口径,与本模块的出入恰恰在零差值上。
- “差值中位数”和“H-L 中位数差”是两个量,只有差值分布对称时才一致。 主结果表把两者并排放着(示例里 −7.085 与 −6.360),容易被当成同一个数的两种算法。差值中位数是把差值排序取中间那个;H-L 取的是全部 Walsh 平均 (dᵢ+dⱼ)/2 的中位数,它才是与符号秩检验口径一致的位置移动量,也只有它配了不依赖分布假设的置信区间。论文里报 H-L 及其区间,差值中位数当描述统计看。
- 非零差值不到 6 对时,双侧检验在 α=0.05 下不可能显著。 这不是“没检出差异”,是这个检验在这么小的样本上根本没有能力做出显著结论——哪怕 5 对全部朝同一方向变化,双侧 p 的下限也过不了 0.05。第一张卡会把有效非零差值对数单独列出来,并注明 ≥20 时正态近似才足够精确。零差值和并列多时还有另一重代价:它们会让正态近似的方差被高估、检验偏保守,更容易漏掉真实存在的差异。样本这么小时,不显著绝不能写成“无差异”。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
左边是同一批对象测两次,分析的是每个人自己的差值,个体差异被抵消掉;右边是两拨不同对象各测一次,分析的是两组的整体水平,个体差异留在组内。数据是哪一种,决定了该用哪一族方法——摆错了不会报错,只会悄悄换掉你在检验的东西。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:配对样本 Wilcoxon 检验主结果表
- 输出结果三:配对差值分布可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
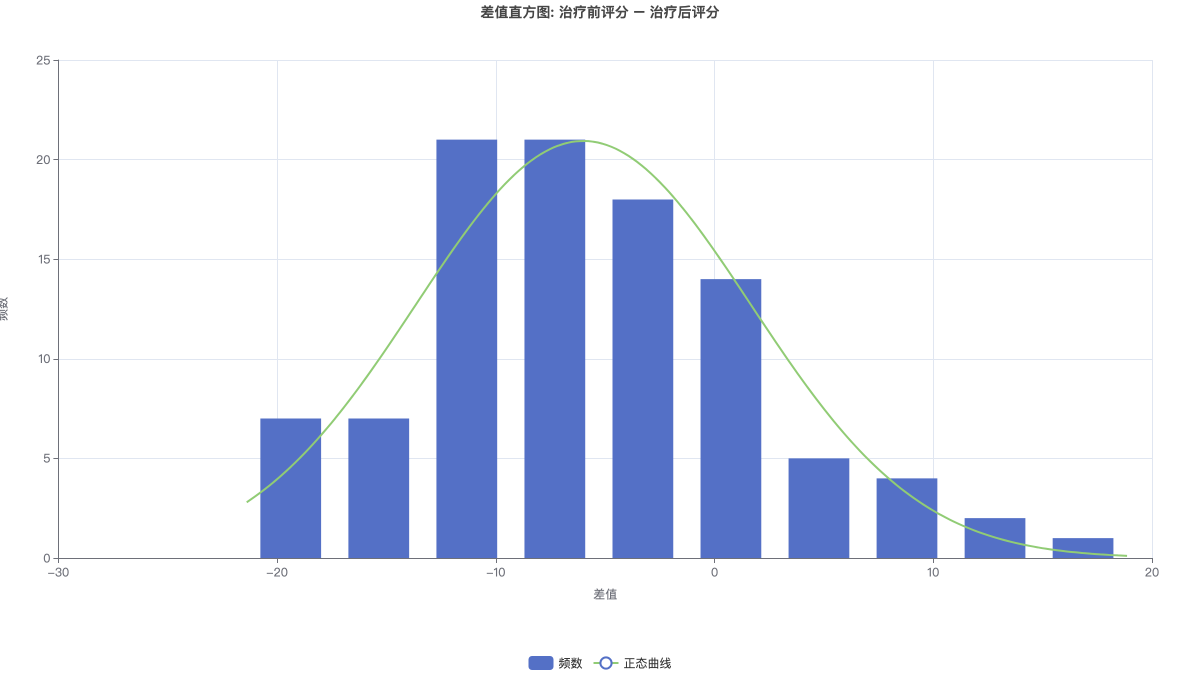
该图展示配对差值(治疗前评分 − 治疗后评分)的频数分布(蓝色柱),并叠加同均值同标准差的理论正态曲线(绿线)作为形状参照。本对差值的对称性诊断:偏度 g1 = 0.520,D'Agostino 偏度检验 p = 0.034。