
TF-IDF关键词提取
这个方法是做什么的
从一批文档里挑出"既在某些文档中反复出现、又不是人人都在说"的词。权重 = 词频 TF × 逆文档频率 IDF:一个词在某篇里出现得越多,权重越高;但它出现在越多篇文档里,IDF 越小,权重被压得越低。模块用 jieba 精确模式分词、剔除中英文停用词与单字词纯数字后,交给 TfidfVectorizer(平滑 IDF、L2 归一化)计算,最后按各词在全部文档上的平均权重排序取前 N 名。
除了权重排名,第二张卡还给出四列用来判读的量:单篇最大 TF-IDF(该词在最能代表它的那篇里的权重)、IDF、文档频率 DF 与文档覆盖率。第四张卡换掉效应量位,给的是权重集中度(Top10/Top20 占比、权重基尼系数)、IDF 的取值范围与均值、区分度比值 max/mean 的中位数,以及只出现在一篇文档里的候选词占比。它不做假设检验,因此全篇没有标准误、置信区间与 p 值;也不输出任何文档级向量,检索、去重、相似文档匹配需要的那种逐篇权重表,报告里没有。
需要准备什么数据
- 放入[文本]文档列:不限
数据要求
- 数据表至少 2 行。
- 单列缺失率不超过 90%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想从大量开放题或评论里提炼出几个能贴标签的关键词
- 高频词榜被"效果、体验、感觉"这类通用词占满,需要一份更有分辨力的榜单
- 想知道某个词是集中在少数几篇里、还是全语料普遍在说(看第二张卡的单篇最大 TF-IDF 与文档频率两列)
- 判断语料里有没有真正突出的主题词(看权重集中度与基尼系数)
前提是每行必须是一篇独立文档且至少两篇。IDF 靠的是文档之间的差异,如果整列文本其实是同一篇长文被换行拆开,IDF 就失去了意义,榜单也不可读。文档数越多、彼此主题差异越大,IDF 的区分力越强。
什么时候不要用它
- 你只关心某个词到底被说了多少次:TF-IDF 给的是加权稀有度,不是次数,用「词频统计」。
- 你想把文档聚合成若干主题、并看每篇文档属于哪个主题:TF-IDF 只排词、不分组,用「LDA主题模型」。
- 你要判断文本的褒贬倾向:权重高低与情感方向无关,用「情感分析」。
- 每行不是一篇独立文档(整列是一篇长文的换行、或每行只是一个短标签):IDF 无意义,此时退回不依赖跨文档比较的「词频统计」。
- 这一列是分类选项、编码或多选题标签:用「频数分析」;多选题用「多选分析」。
容易误读的地方
- IDF 是相对这批文档算出来的,换一批语料,同一个词的权重就变。 权重的绝对值没有跨语料可比性——0.0734 在这份语料里排第一,换一份语料可能连榜都上不了。同理,第四张卡的基尼系数、Top10 占比也只能在同一批文档内部横向比较,不能拿去和别人论文里的数字对照。
- IDF 给稀有词的加分,被"按全语料平均"这一步几乎抵消干净了。 在单篇之内,出现在所有文档里的词 IDF 最小、权重确实被压到最低;但主榜的排序键是该词在全部文档上的平均权重,不出现的篇按 0 计入分母。于是一个词出现的篇数越多,平均值反而越高。这份示例语料实测:平均权重与文档频率的 Spearman 相关是 +0.98,与 IDF 是 −0.98——主榜的次序几乎就是文档频率的次序。第三张卡的散点图(文档频率 × 平均权重)画出来是一条上升带,不是可以分四象限读的图。
- 只出现在一两篇文档里的词不会霸榜,它们结构性地垫底。 L2 归一化让任一词在任一篇里的分量不超过 1,所以只出现 1 篇的词平均权重上限就是 1/文档数——这份 120 篇的语料里是 0.0083,而榜首是 0.0949,差一个数量级。第四张卡的"仅出现 1 篇的候选词占比"是用来看语料够不够散的(本次为 0),不是用来防霸榜的。想找只在个别文档里突出的局部特色词,主榜上找不到,要回到第二张卡的"单篇最大 TF-IDF"与 IDF 两列去看;第四张卡的区分度比值 max/mean 只有一个覆盖全部候选词的中位数,不逐词给。
- 它和「词频统计」用的不是同一张停用词表,两边榜单对不上是口径差异,不是算错了。 本模块的表由一份中文停用词集与 sklearn 的英文停用词表合并而成,「词频统计」用的是另一份更短的中文表。同一份示例语料,「词频统计」数出 96 个不同词,这里的候选词表规模是 94。两个模块都不支持自定义词表,所以想让某个领域词留下来,只能在数据预处理阶段先改文本。
- 权重没有显著性,排名第 1 和第 5 之间不存在"统计上的差别"。 报告里没有 p 值也没有置信区间,因为 TF-IDF 是加权计数指标、不存在抽样分布。换一批文档,前十名的顺序很可能重排。要给关键词之间的差异做统计判断,得先把"某词是否出现"编成变量,再用「卡方检验」这类真正带推断的方法。
报告里有什么
- 输出结果一:语料概览与预处理充分性检验
- 输出结果二:TF-IDF 关键词权重表
- 输出结果三:关键词权重可视化
- 输出结果四:权重分布与区分度指标
- 输出结果五:结论与学术表述
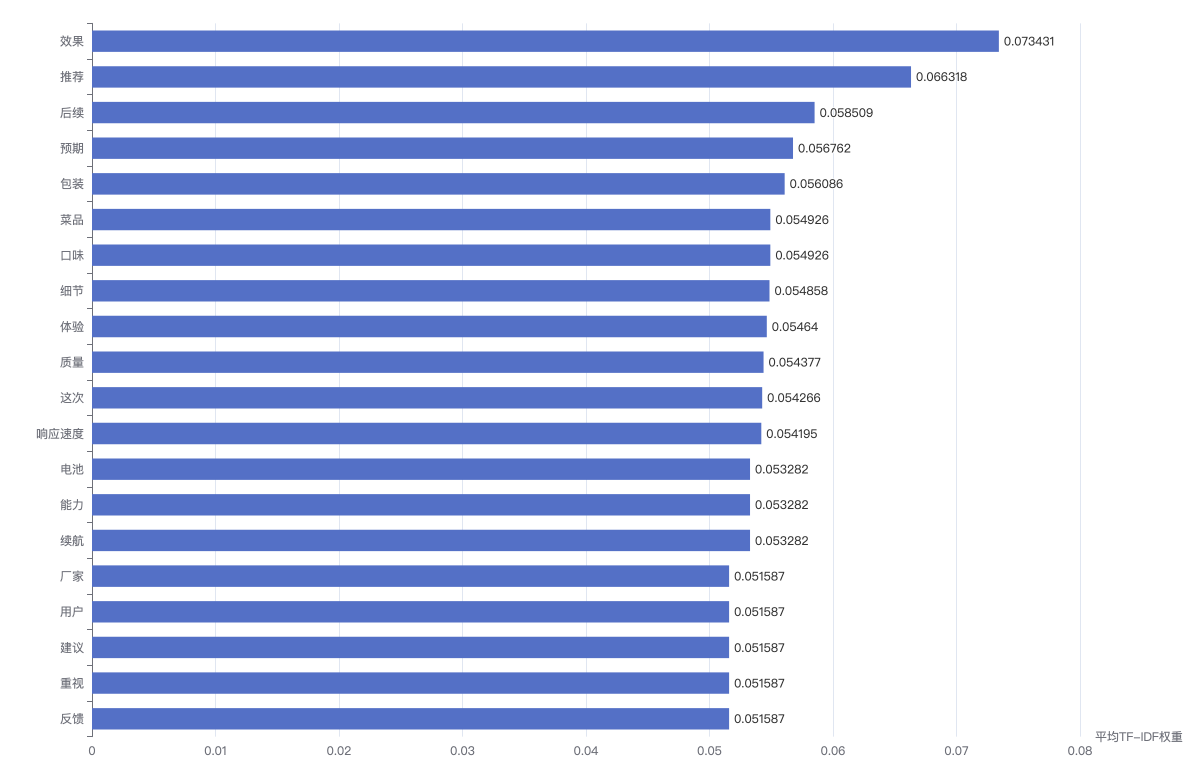
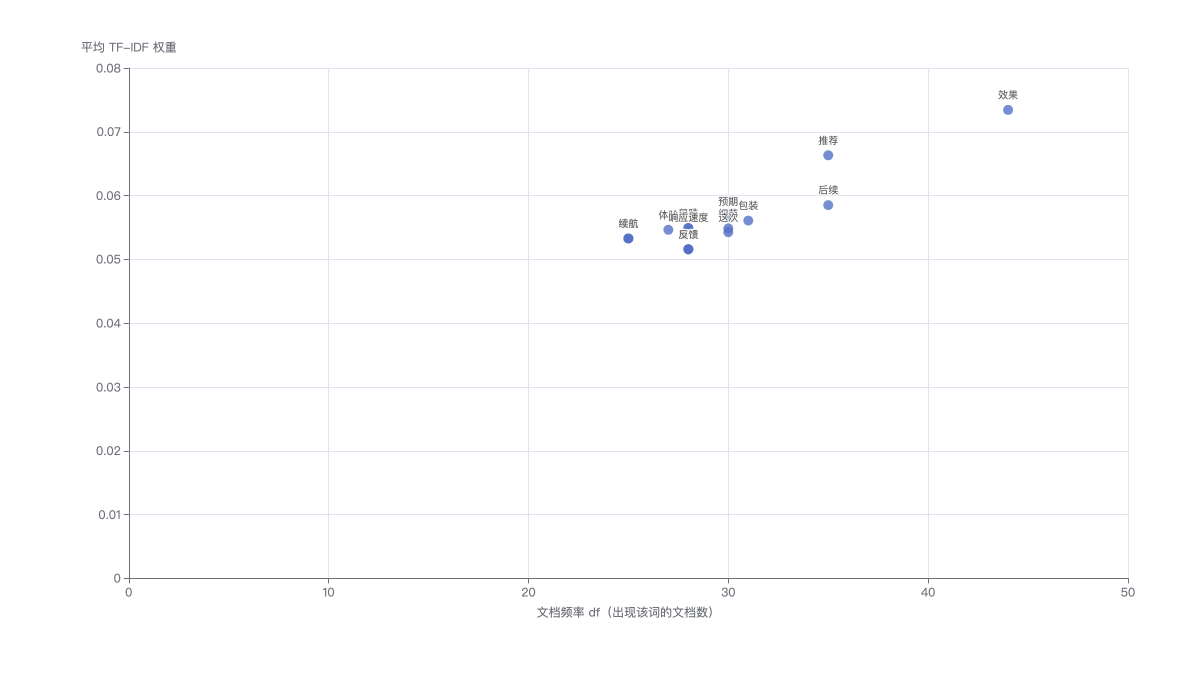
上图为关键词的平均 TF-IDF 权重条形图(可用右上角切换器切到表格视图逐条读数);下图为「文档频率 × 平均权重」散点图。