
LDA主题模型
这个方法是做什么的
把一批文档拆成若干组共同出现的词,每一组就是一个"主题"。LDA 内部估两组分布:每个主题下各个词的条件概率 p(词|主题),以及每篇文档在各主题上的占比 θ。分词与停用词过滤之后交给 LDA 训练,随机种子固定为 42,具体用的是哪个引擎(gensim 的 LdaModel 或降级的 sklearn 实现)写在第一张卡与图注里。主题数 K 与每主题展示的关键词数由你在控件里指定,默认 K=3、每主题 10 词。
主题-词分布报告里给全,θ 则只以汇总形式露面:第二张卡给各主题的主导文档数与平均主题占比 θ̄,第五张卡逐篇给主导主题、主导主题占比与混合度——完整的 θ 向量哪张表里都没有,而且这张文档表最多只列前 100 篇(示例 120 篇文档,卡5 标题与表注都写明"本表展示前 100 篇",剩下 20 篇不在表里)。第四张卡给三组质量指标:逐主题的 C_UMass 一致性与"独占关键词数"(该主题 Top 词中不出现在任何其他主题 Top 词里的个数);整体的平均一致性、语料内困惑度、主题间平均 Jensen-Shannon 距离与最相似的那一对主题;以及文档主题归属的平均归一化熵。LDA 不检验任何原假设,全篇没有 p 值。
需要准备什么数据
- 放入[文本]文档列:不限
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 90%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 几百上千条开放题或评论,想知道大致在讨论哪几件事
- 给人工编码框架找起点:先让模型分出几组词,再由人来命名与合并
- 判断一批文档的主题是集中还是分散(看主导文档分布与主题间 JS 距离)
- 找出主题最混杂的文档(混合度接近 1 的):第五张卡按文档原序给出混合度,排序要你自己做,且只到第 100 篇
前提是每行一篇独立文档,分词去停用词后至少保留 5 篇;有效文档数与词汇量都必须不少于主题数,否则主题不可辨识。文档越长、语料越大,主题-词分布越稳。
什么时候不要用它
- 你只要一张关键词榜:LDA 的产出是词的概率分布,读起来比词表费劲得多,用「词频统计」或「TF-IDF关键词提取」。
- 文档已经有人工分好的类别,你只想比较各类的文本量:不需要无监督分解,用「频数分析」;两个分类变量的交叉构成用「列联(交叉)分析」。
- 你要分群的是数值特征而不是文本:用「聚类分析(K-Means)」,类别与数值混合时用「二阶聚类」。
- 你想知道的是褒贬倾向:主题里的词不带情感方向,用「情感分析」。
- 每行不是一篇独立文档(整列文本是一篇长文按行拆开):文档-主题分解没有意义,退回「词频统计」看整体用词。
容易误读的地方
- 主题数 K 是你自己定的,模型不会告诉你该定几。 控件默认 3、可选范围 2 到 50,改成 5 就得到 5 个主题,改成 8 就得到 8 个——每一次它都会给出看上去像模像样的结果。K 太大时模型会把同一个主题拆成几个副本,第四张卡的"最相似的一对主题"与它们的 JS 距离就是查这个的:JS 距离偏低而一致性偏高,通常意味着重复而不是发现。
- 主题的"含义"是你事后赋予的,模型本身不保证可解释。 报告里的"主题1、主题2"和括号里的概括词只是把权重最高的几个词摆出来,没有任何语义理解。同一组词换个人读,命名可能完全不同。写进论文时应当交代命名是由谁、按什么规则做的,而不是把"主题1[后续、包装、值得]"直接当成一个已被验证的构念。
- 困惑度低不等于主题好。 报告给的是语料内(held-in)困惑度,它会随 K 增大单调改善——只盯这个数就一定会选出过大的 K。它也只能在同一批文档的不同参数之间比较,跨语料的困惑度绝对值没有可比性。选 K 的做法是扫多个 K,取一致性较高、同时主题间 JS 距离没有明显塌下去的那个。
- C_UMass 一致性是负数且只能内部比较,"−1.2793"不是"不及格"。 它按同一语料内的词共现算出来,取值恒不大于 0,越接近 0 表示同一主题的关键词越常一起出现。所以有意义的读法只有一种:同一批文档换个 K 再跑一次,看两次的一致性哪个更接近 0(示例 K=3 时是 −1.2793)。拿这个数去对照任何外部标准,或者和别的语料比,都不成立。
- 固定随机种子保证的是可复现,不是稳健。 模块把随机种子定死在 42,同一份数据同一组参数每次跑出来一样;但换一个种子、或把 K 从 3 改成 4,主题划分就可能整体重排。要论证主题结构本身站得住,必须在多个 K 与多个种子下重复并比较一致性,报告里也要写明用了哪组参数。
- "主导主题"只是占比最大的那个,不代表这篇文档真属于它。 第五张卡同时给了主导主题占比与混合度:示例里有的文档主导占比只有 0.385、归一化熵 0.993,意思是三个主题几乎各占三分之一,这篇文档实际上没有主题归属。把这类文档按主导主题计入某一类去做后续统计,会得到一个看起来很干净、实则大部分是硬分派的结果。
报告里有什么
- 输出结果一:语料概览与建模前提检验
- 输出结果二:主题-词分布(各主题 Top 关键词及权重)
- 输出结果三:主题分布可视化
- 输出结果四:主题质量指标(一致性 / 困惑度 / 主题间距离)
- 输出结果五:各文档主导主题与结论(文档表仅展示前 100 篇)
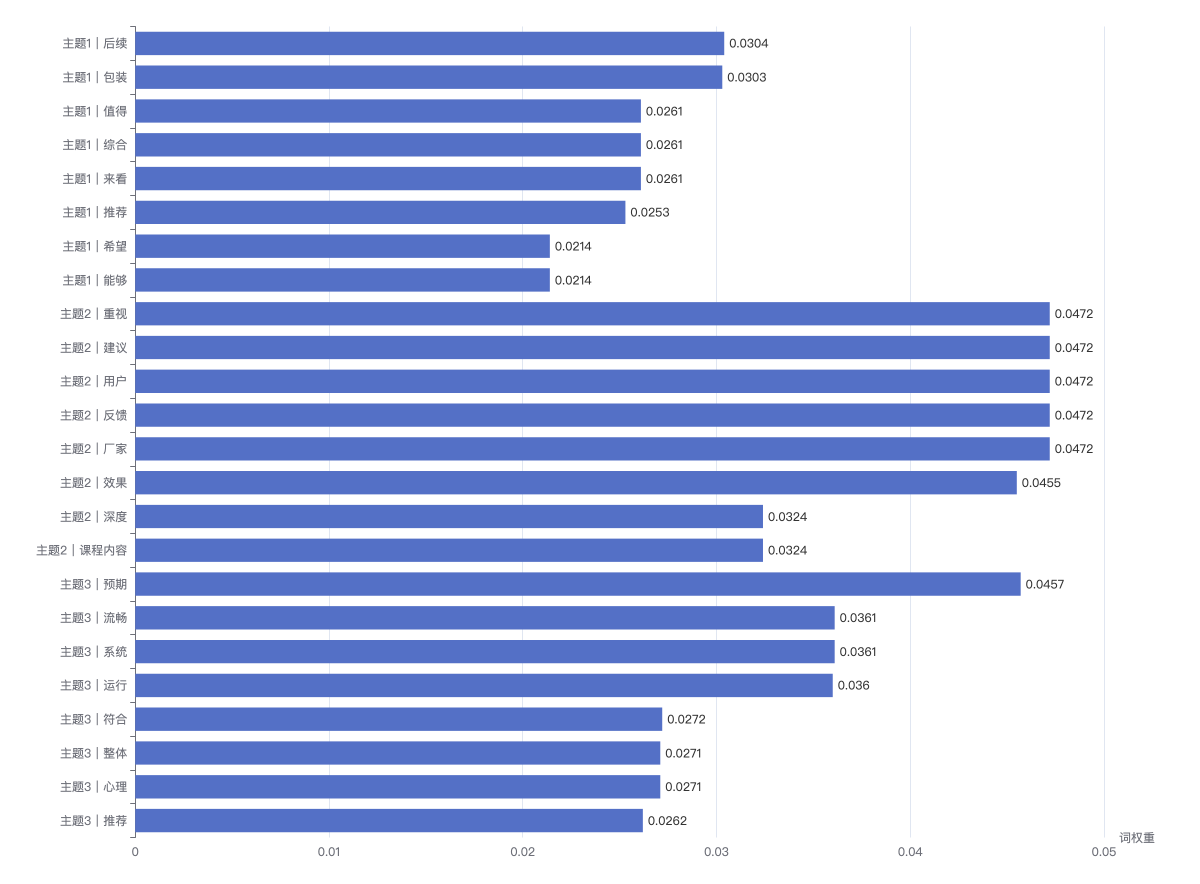
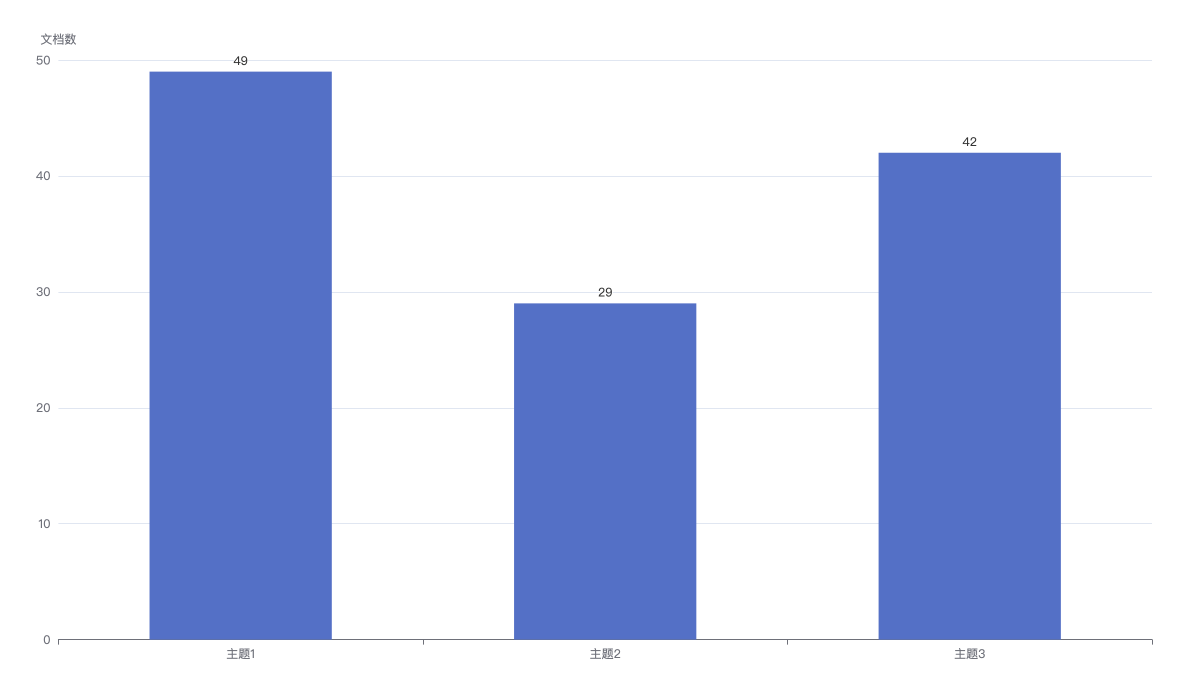
上图为各主题最具代表性关键词的权重(每主题至多展示 8 词),下图为以各主题为主导主题的文档数分布;两图均可用右上角切换器切到表格视图。