
价格断裂点(Gabor-Granger)
这个方法是做什么的
在若干预设价位上逐一问“这个价格你会不会买”,把每个价位的购买率算出来,再乘以价格得到预期收益,收益最高的那一档就是这次测试给出的最优价格。它同时画出两条曲线:需求曲线(购买率随价格下降)和收益曲线(先升后降),后者的峰值就是结论的落点。购买意愿可以是 0/1 买或不买、[0,1] 的概率,也可以是 1–5 的意愿量表——模块会先归一化到 [0,1] 再当作购买率处理。
报告给逐价位的购买率、95%CI、预期收益、相对收益指数与★最优价标记——区间按意愿的类型分两条路走:0/1 二值用 Wilson score 区间,连续或量表意愿用 t 区间。接着回答“这个最优价有多靠得住”:对受访者(不是价位)做 600 次有放回重抽样,给出最优价格的 bootstrap 95% 区间,以及“稳定性”——多少比例的重抽样仍然选出同一档。效应量一侧给价格弹性 ε(ln 购买率对 ln 价格回归的斜率),它无量纲、可跨品类比较,附标准误、t、p、95%CI 与 log-log 拟合的 R²。事后比较只做相邻价位(配 Bonferroni 校正),因为价格断裂点关心的是需求在哪两档之间跳水;这里同样分支——二值走两比例 z 检验、连续走 Welch t。卡① 先查价位数量、每价位样本量与需求规律,并单列一行告诉你本次判成了哪一种意愿、因而走了哪套区间与检验;Cochran-Armitage 趋势检验只在二值意愿下才做,连续意愿时那一行会写明不适用。
需要准备什么数据
- 放入[定量]价格点:不限
- 放入[定量]该价格下购买意愿:不限
数据要求
- 数据表至少 80 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 已有明确候选价位(如 99/129/159/199),想知道定哪一档收益最高
- 想量化“往上跳一档掉多少购买率”,找出需求真正断裂的价位区间
- 订阅制、会员卡、增值包的档位设计
- 需要一个能跨品类比较的价格敏感度指标(价格弹性 ε)
前提:价格列为定量,需覆盖至少 2 个、建议 ≥4 个不同价位,否则构不出收益峰值的形态;每个价位建议至少 20 个观测,否则相邻价位的置信区间会宽到彼此无法区分;数据不少于 80 行。还有一条隐含前提是需求规律本身——卡① 用价格与购买率的 Spearman ρ 检验“购买率是否随价格下降”,这一项不成立时后面的收益峰值不宜解读。
什么时候不要用它
- 你要的是消费者心里“多少算贵、多少算便宜”的价格带,而不是几个候选档位的收益:那是四问价格法,用「价格敏感度PSM(Van Westendorp)」。
- 价格只是产品诸多属性之一,你真正想知道的是它相对品牌、功能有多重要:用「联合分析(Conjoint)」。
- 数据是逐个客户的实际购买记录,还想控制客户特征:本模块只按价位聚合,不带协变量。要在个体层面对购买概率建模并纳入其它变量,用「逻辑回归」;结果是有序的意愿等级则用「有序逻辑回归」。
- 想从历史成交数据估价格弹性:本模块的弹性来自问卷设定的价位,不是市场实际成交。有真实的价格与销量记录时,用「线性回归 (最小二乘法)」做双对数回归;带趋势与季节性的销量序列用「时间序列分析(ARIMA)」。
- 只想描述各价位上买与不买的分布、不做收益最优化:用「频数分析」看分布,用「列联(交叉)分析」看价格档与是否购买的交叉表。
容易误读的地方
- “最优价”只能落在你测过的价位上。 收益峰值是从 8 个离散档里挑出来的,不是连续优化的结果。示例中峰值 199 的预期收益 112.77,与 129 档的 111.80、159 档的 111.30 相差不到 1.5%——这三档在收益上几乎没有区别。更要紧的是端点情形:卡③ 明确写着,如果收益曲线在测试区间内单调上升、峰值落在最高价位,说明真正的最优价可能在测试范围之外,此时应向上扩展价位重测,而不是把端点当成答案。
- bootstrap 稳定性比峰值本身重要得多。 示例里最优价 199 的 bootstrap 95% 区间是 [129, 199],只有 37.7% 的重抽样仍选出 199。换一批同样规模的受访者,峰值很可能落到别的档上。卡② 的结论文案给了正确读法:把区间内的价位都当作“同等优”的候选,最终定哪一档交给业务因素——它点名的是价格锚点与渠道价盘,毛利不在这张卡上,要到卡⑤ 的研究局限里才出现。只报 199 而不报这个区间,是把一个摇摆的结果写成了一个精确的建议。
- 陈述性的“会买”系统性高于真实购买。 卡① 的结论文案直接写明:报告中的绝对购买率宜作相对比较用,不宜当作市场渗透率。示例里 59 元档购买率 100%、199 元档 56.67%,真实转化不可能是这个量级。用它算“定 199 能卖多少台”会严重高估;用它比较“199 相对 249 掉了多少”则相对可靠,因为高估在各价位上大致同向、会在做差时抵消掉一部分。
- 预期收益 = 价格 × 购买率,这里面没有成本。 它是每位受访者的期望收入,不是利润。若单位成本 80 元,59 元档根本是亏的,而这个模块完全看不见——它也不含竞品定价、市场容量与品牌定位,卡⑤ 的研究局限逐条列了这些。把收益峰值直接当成定价决策,是这个方法最常见的误用;正确用法是先用它把候选档缩到两三个,再拿毛利和竞争格局做最后一刀。
- 相邻价位比较全不显著,不等于“哪档都一样”。 示例 7 组相邻比较里,Bonferroni 校正后只有 199→249 一组显著;校正把每个 p 乘以 7,本来 p=0.0195 的 59→79 被抬到 0.1366。这既可能是这些价位之间真的没有断裂,也可能是每档只有 30 人、功效不足。分辨的办法是看差值的置信区间宽度:窄且贴近 0 才是真的没差异;宽如 [−0.3708, 0.0375] 只说明数据不足以下结论。此外,样本代表性比样本量更要命——用便利样本测出来的购买率,换一群人就会整体平移,而峰值恰恰对这种平移很敏感。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:各价格购买率、置信区间与预期收益
- 输出结果三:可视化(需求曲线、收益曲线与相对收益)
- 输出结果四:效应量(价格弹性)与相邻价位事后比较
- 输出结果五:结论与学术表述
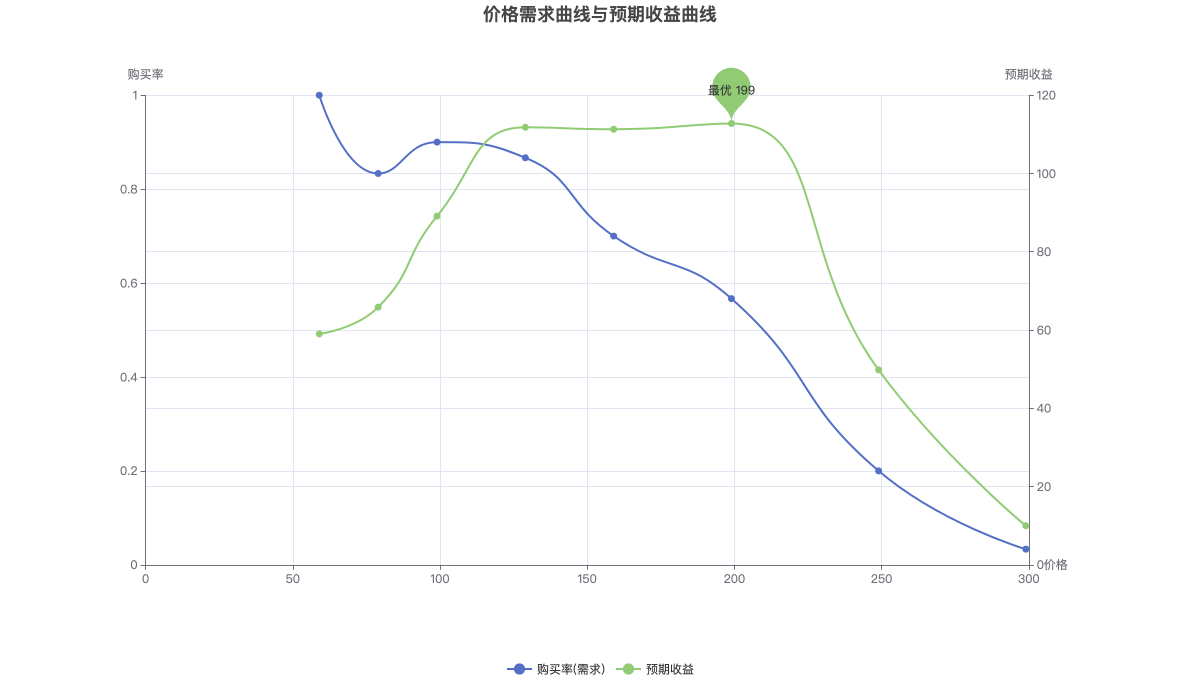
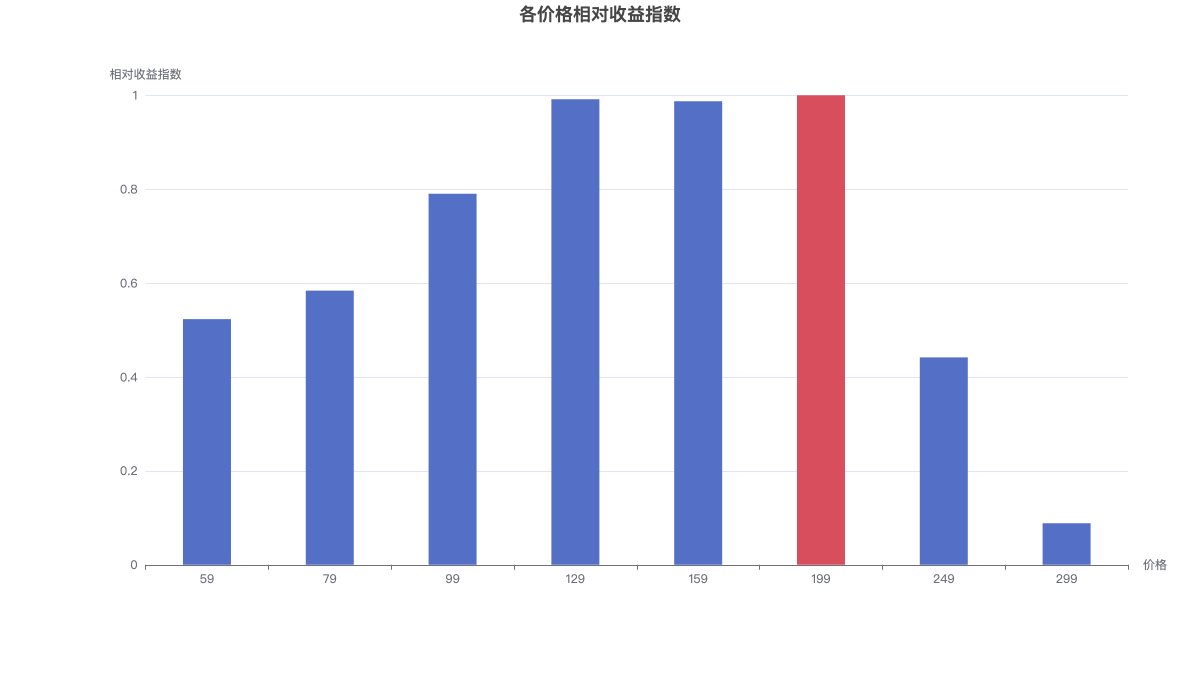
上图左轴为购买率(需求)、右轴为预期收益,标注点为收益峰值;切到「表格」视图可读取每个价位购买率的 95% 置信区间上下限。下图为相对收益指数。