
区分度分析
这个方法是做什么的
逐题回答一件事:这道题能不能把量表总分高的人和总分低的人区分开。做法是高低分组法——按量表总分的分位数切出高分组与低分组(比例在控件里选 27%、25% 或 30%,默认 27%),再对每道题做高低两组的独立样本 t 检验,这个 t 值就是决断值 CR。经典判据是 |CR|≥3.0 且达到统计学显著。注意它做的是题目分析(item analysis),与用一组定量变量去预测已知分组的「线性判别分析」名字相近但完全不是一回事。
除了 CR,报告把“差距有多大”“与量表整体是否同向”“删掉它量表会更好还是更差”分开回答:Hedges' g 及其 95%CI、修正后题总相关 CITC(扣除该题自身后再算,另附未修正版本作对照)及其 Fisher z 置信区间、删除该题后的 Cronbach's α。卡④ 最后把三条规则合成逐题判定:同时满足 |CR|≥3、Holm 校正后显著、CITC≥0.40 才判“保留”;CITC<0.30 直接判“建议删除”。
需要准备什么数据
- 放入[定量]量表题项:至少 3 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 自编问卷预调研后筛题:找出区分不了高低水平被试的题目
- 论文的量表编制部分需要报告决断值 CR 与题总相关
- 想知道删掉某道题之后,整份量表的内部一致性会变好还是变差
- 需要连同效应量(Hedges' g)与多重比较校正一起报告的题目分析结果
前提:拖入的题项必须属于同一个维度且同向计分——反向题要先在“数据处理 → 公式”里反向,否则总分不成立、CITC 会出现负值;至少 3 个题项,少于 3 题时“总分减该题”这个效标几乎失去意义;题项须为数值型(李克特等距计分);不得有常数列;含缺失的个案整行删除。数据表行数下限实测为 30 行——29 行会被直接拦下。卡① 会实算 Cronbach's α 作为“总分能否当效标”的前提(示例 α=0.8039)。
什么时候不要用它
- 你想做的是“用一组定量变量把人分到已知的几个类别里”:那是分类预测,不是题目分析,名字相近但完全不同,用「线性判别分析」。
- 你关心的是整份量表的内部一致性(α 的置信区间、McDonald's ω、测量标准误 SEM、逐题删除后的 α):用「信度分析」,它把这些指标连同 α 的七条前提一起给全。
- 你想知道这些题背后有几个维度、每道题归属哪个因子:区分度只用总分做效标,看不出结构,用「效度分析」(KMO/Bartlett + 载荷 + CR/AVE)或「因子分析(探索性)」。
- 分组变量是外部的(实验组与对照组、通过与未通过),不是按本量表总分切出来的:那是普通的两组均值比较,用「独立样本T检验」。
- 你有外部效标(考试成绩、专家评级、后续行为),想看每道题与它的关联:本模块只用内部效标,外部效标的关联用「Pearson相关性分析」,定序或非线性用「Spearman相关分析」。
容易误读的地方
- “总分在高低两组间差异极显著”是分组方式的必然结果,不能当成量表有区分度的证据。 卡② 的第二张表专门为这件事而设:高低分组本来就是按总分切的,所以总分必然差异巨大(示例 Welch t=24.635,Hedges' g=4.367);表注写明该行只用于确认分组已正确执行。把它当成结论,模块直接称之为“区分度报告中最常见的循环论证”。真正的证据是上一张表里逐题的 CR。
- 区分度用的是内部效标,CR 再高也说明不了题目测得对。 卡⑤ 的解释边界写明:它衡量的是题项与量表整体的一致程度,而非题项与外部真实水平的关联,高区分度不等于高效度。八道措辞不同但都在问同一件事的题,CR 会非常漂亮,同时完全测不到你想测的构念。
- 高低两组的人数不会正好各占 27%,论文里要报实际人数。 示例低分组 65 人、高分组 57 人,而名义比例对应的是各 54 人;概览表注明“并列分数会被同时纳入边界组”。题目越少、计分档位越少,并列分数越多、偏离越大,两端组人数也越不对称。直接写“各取前后 27%”与报告里的 n 对不上。
- CR 与 CITC 用的不是同一批被试,两者不一致时不能只挑好看的报。 模块的结论句写明:CR 只用了两端各约 27% 的人,CITC 用了全部被试;一道题若在中间水平的人身上区分不佳,两者会给出不同信号。综合判定因此要求三条同时成立才判“保留”,而不是看 CR 一个数。另外表注提醒 CITC 必须扣除该题自身——报告里那列“未修正题总相关”系统性偏高(示例 0.589~0.696,而 CITC 是 0.447~0.573),别抄错列。
- 天花板与地板效应会让一道题“CR 还行但其实已经区分不动了”,而它不在判定规则里。 描述表专列这两列,表注写明任一方向超过约 20% 时,该题的区分能力已被计分上下限截断,即使 CR 显著也无法再区分更高或更低水平的被试。示例八道题的天花板效应最高只有 15.00%(顾客满意度Q6),尚未越线。这一条不参与卡④ 的三条判定规则,必须自己回到卡① 去看。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:逐题决断值 CR(主结果表)
- 输出结果三:区分度可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
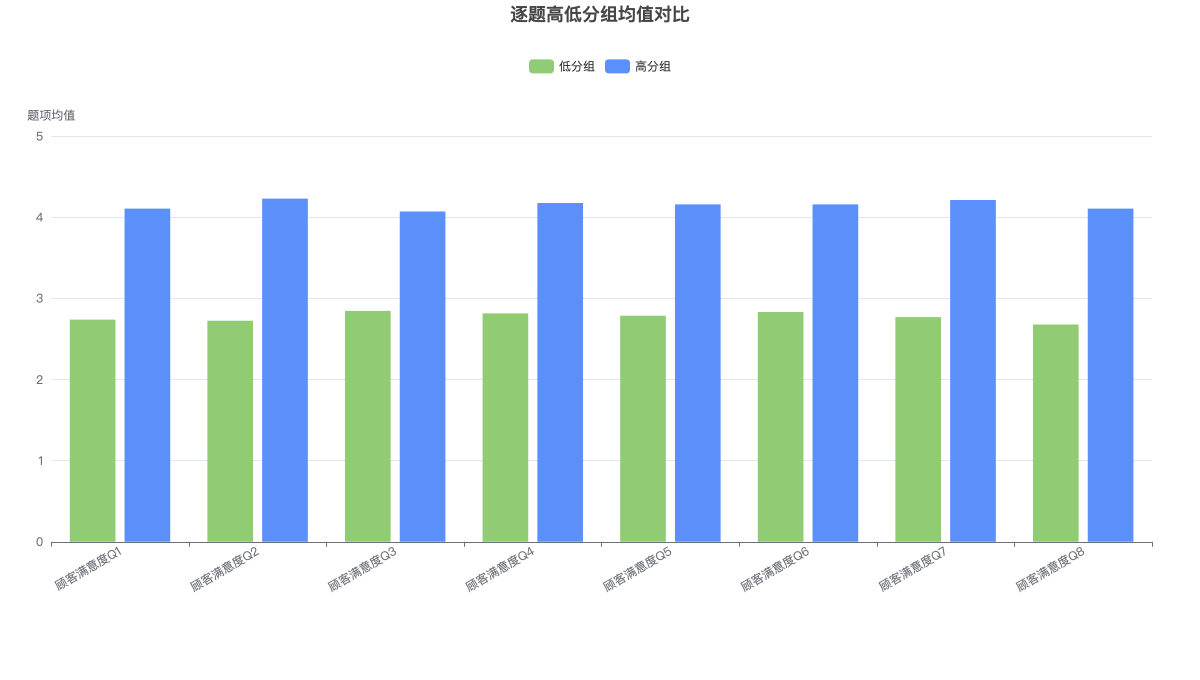
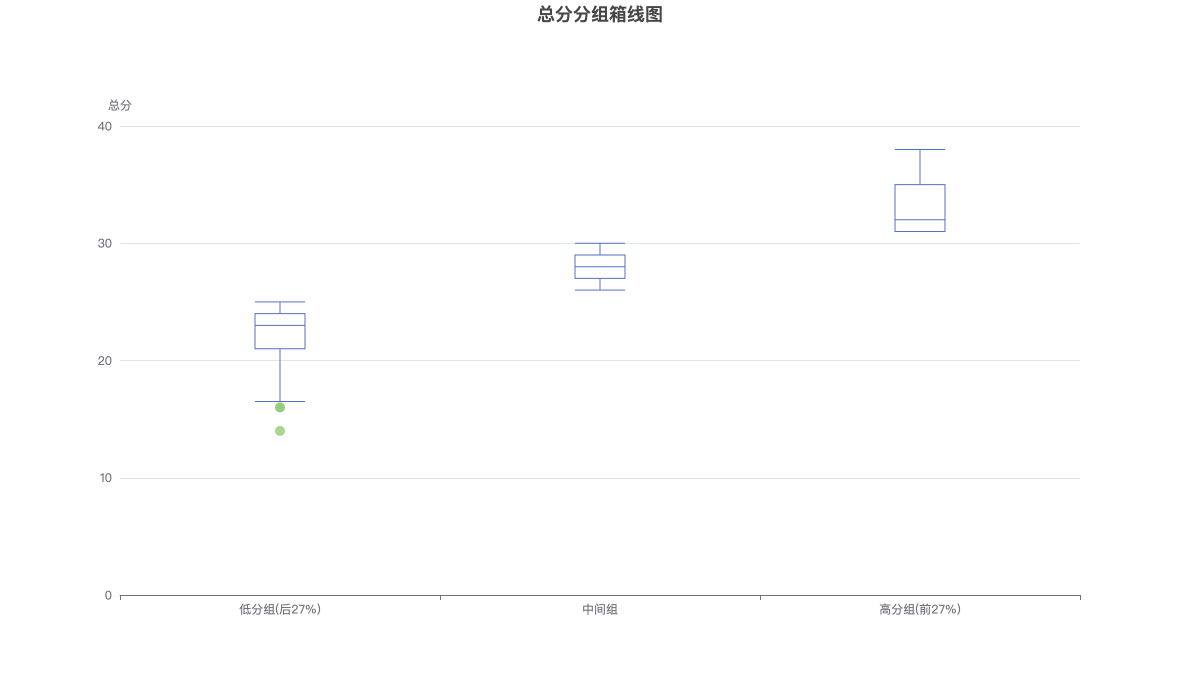
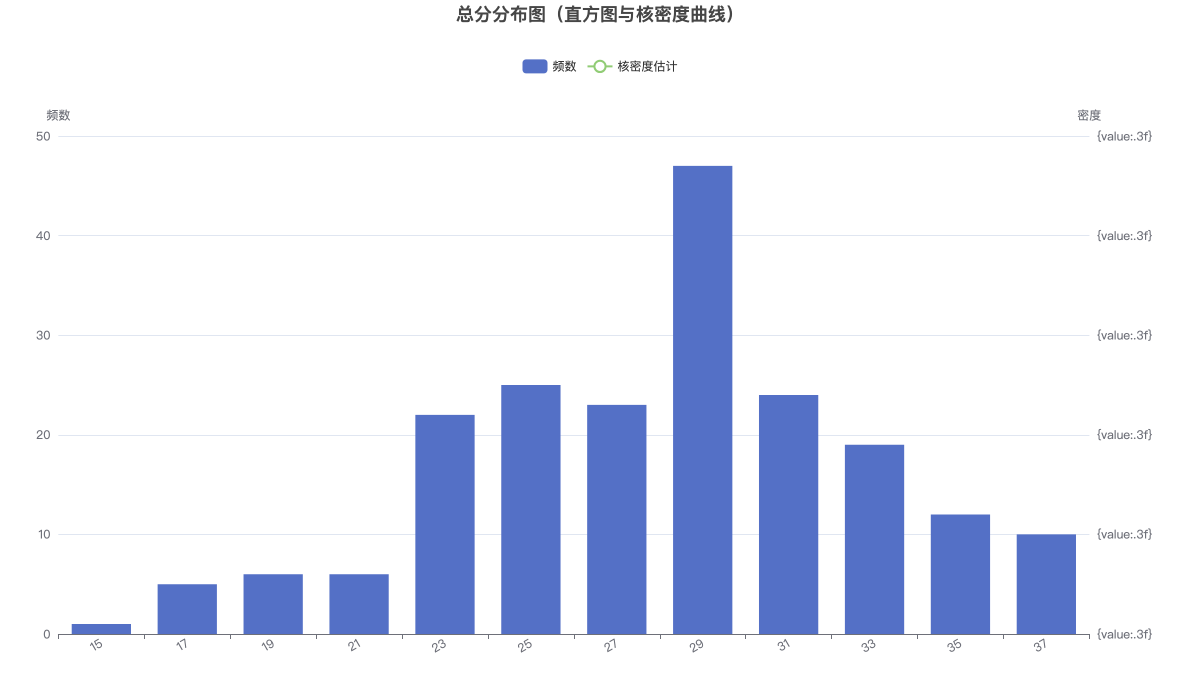
第一张图逐题对比高低分组的均值——两根柱子的高度差就是该题的原始区分幅度,差距越大区分度越好。第二张为三组总分的箱线图,用于观察分组的分离程度与组内离散。第三张为总分的分布形态(直方图 + 核密度),用于判断分组切点是否落在分布的合理位置。三图均可用右上角切换器在图/表之间切换。