
GMM 估计
这个方法是做什么的
解释变量与误差项相关(内生性)时,普通最小二乘的系数是有偏的,而且样本再大也偏。工具变量法的思路是找一个变量 Z:它与内生的 X 强相关,却只能通过 X 影响 Y。本模块用广义矩估计实现这条路径,四个拖拽区各司其职——被解释变量 Y、内生变量 X₁、工具变量 Z、外生变量 X₂(外生变量直接进方程并同时充当自身的工具)。标准误是异方差稳健形式。
工具变量法的可信度由两个条件决定,报告把它们分开处理。“够不够强”是可检验的:第一张卡逐个内生变量给出第一阶段回归中排除性工具的联合 F 检验、自由度、p 与 partial R²,并按 Staiger-Stock 的经验门槛 F > 10 判定。“外不外生”不可检验:识别条件表里“排除性约束”那一行给的是“未做该检验”,并注明排除性约束是识别假设、任何统计检验都无法证实它。第四张卡把 OLS 与 GMM 的系数逐个对照(差值、相对变化、标准化 GMM 系数),再给内生性 C 统计量与 Sargan-Hansen J 过度识别检验。本模块特有的着眼点就在这张对照表:它量的是“不用工具会偏多少”,而不是让你在两套系数里挑一个更顺眼的。
需要准备什么数据
- 放入 [定量] 因变量 (Y):1 个,定量变量(数值)
- 放入 [定量] 内生变量 (X1):至少 1 个,定量变量(数值)
- 放入 [定量] 工具变量 (Z):至少 1 个,定量变量(数值)
- 放入 [定量] 外生变量 (X2)(可选):定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 关键解释变量与误差项相关:联立决定、遗漏了共同原因、或存在测量误差
- 手上有理论与制度背景站得住的工具变量
- 想量化内生性偏误的实际量级,而不只是断言“存在内生性”
- 需要一份带第一阶段 F、C 检验与 J 检验的完整工具变量报告
前提有三条。阶条件:工具变量个数必须 ≥ 内生变量个数,否则不可识别。秩条件:工具必须与内生变量强相关,弱工具会让工具变量法比 OLS 偏得更厉害。排除性约束:工具只能通过内生变量影响 Y,这一条只能靠论证。四个区的变量互不重复,各列须为定量非常数列。
什么时候不要用它
- 没有内生性顾虑:用「线性回归 (最小二乘法)」。C 检验不显著、且 GMM 与 OLS 系数差距很小时,OLS 一致且更有效率(标准误更小)。
- 因变量是“是 / 否”:本模块只估线性方程,用「逻辑回归」。
- 内生性来自面板里被解释变量自己的滞后项:用「系统GMM动态面板」,它用更早期的滞后项自动构造工具。
- 内生性来自样本自选择(只观测到一部分人的结果):用「Heckman两步法」。
- 处理是按某个门槛值分配的:用「断点回归(RD)」;有明确处理组与前后两期的用「双重差分(DID)」。
- 只需要经典的两阶段最小二乘输出:用「两阶段回归」。
容易误读的地方
- 这个模块的星号是计量经济学口径,一颗星只有 p<0.1,不是 p<0.05。 系数表与检验表的表注逐字写着“* p<0.1, p<0.05, * p<0.01(计量经济学惯例)”。这跟你在同族大多数模块里看到的 APA 口径(一颗星即 p<0.05)不同,而同一份报告的结论速览里又并存着按 α = 0.05 判定的“显著的解释变量”一行。看到只带一颗星的系数,它在 5% 水平上并不显著,照抄星号进论文会把结论说强一档。
- 恰好识别时 J 检验根本构造不出来,报告写“未做”——那不等于工具通过了检验。 实测把工具减到与内生变量同样多:识别条件那一行变成“恰好识别(工具数 = 内生数),无法做过度识别检验”,第四张卡的 J 检验行原文写“J 检验在数学上无法构造——这不代表工具有效,只说明数据无法对其外生性提供任何信息”。这时工具的外生性 100% 靠理论论证撑着,报告里一个字的证据也没有。
- J 检验通过同样证明不了工具外生。 实测过度识别时 J = 1.889、p = 0.169,结论是“没有证据表明工具变量无效(必要条件通过)”。结论文案把它的盲区点破了:当所有工具以相同方向违反外生性时,J 检验没有功效。J 的原假设是“全部工具都有效”,一组共同偏掉的工具会让它安然通过。表注还提示 J 检验通常以 p > 0.1 为通过标准,比 0.05 更保守。
- R² 在工具变量估计里没有常规含义,可能为负,不能拿来挑模型。 实测 R² = 0.9074,看着很高,但系数表的表注写着“R² 在工具变量估计中不度量预测能力,仅供参考,不应作为模型优劣的依据”,第四张卡的释义列又写“工具变量估计的 R² 不度量预测能力,可能为负,仅作参考”——因为拟合值用的是投影后的内生变量,不是原始的 X。拿它和 OLS 的 R² 比大小是口径错配。
- 第一阶段 F 很小时,C 检验显著反而是个陷阱。 结论文案专门提醒:若 C 检验显著但第一阶段 F 很小(弱工具),GMM 的偏误可能反而比 OLS 更大。实测这份数据第一阶段 F = 1010.168、partial R² = 0.8722,工具强度充分,C 检验 χ²(1) = 85.019、p < 0.001,OLS 与 GMM 的内生变量系数相差 −9.20%——三条证据互相吻合,才谈得上采信 GMM 那一列。此外,工具变量识别的是受工具影响那部分个体上的局部平均处理效应,效应异质时它并不等于总体平均效应。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:GMM 模型系数表
- 输出结果三:GMM 系数森林图
- 输出结果四:效应量与事后检验
- 输出结果五:结论与学术表述
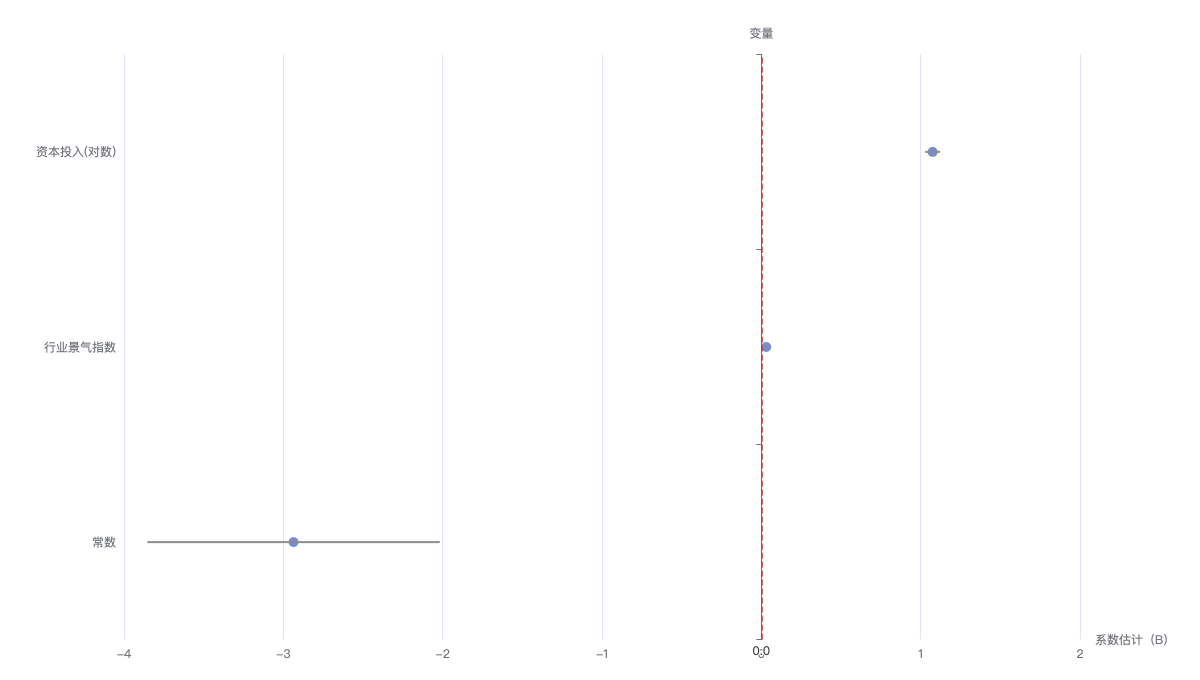
系数森林图把表6 的点估计与 95% 置信区间画在同一横轴上,便于一眼比较各变量的效应方向、幅度与精度。