
Kendall’s tau-b相关分析
这个方法是做什么的
同样衡量两个变量之间单调关系的强弱与方向,但它的定义是数“对”:任取两个观测,两个变量的排序方向一致就记一个一致对,相反就记一个不一致对,τ-b 等于一致对减不一致对,再除以一个对两侧的结(重复值)做过修正的分母。因此它有一个 Spearman ρ 没有的直观读法——实测最强的一对 τ-b = 0.534,等价于说“随机抽两个观测,两变量同向排序的概率是 76.7%”。拖拽区收[定量/定序]列,至少 2 列,一次拖入多个会把所有两两组合都算一遍;无序定类必须先做有序数值编码,模块不会按字母序静默转秩。缺失采列表删除,至少 20 行。
除了 τ-b 与 p 值,主结果表还给 S = C − D、z 统计量与 95% 置信区间。卡① 给稳健描述统计(中位数与四分位数)、逐变量的结组个数与结比例,以及逐对的分段单调性诊断(低值段与高值段分别算段内 τ-b,并与 Spearman ρ 交叉核查)和留一法 max|Δτ|。卡④ 给一致概率 (τ+1)/2、换算到 Pearson r 量纲的 r̂ = sin(π·τ/2)、Cohen 口径的效应量等级与 Holm-Bonferroni 校正后的判定;卡③ 的热力图色阶固定在 [−1, 1],便于跨报告比较。本模块同样不做正态性检验。
需要准备什么数据
- 放入[定量/定序]分析变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 5 点或 7 点李克特量表各题项之间的关联——并列极多,正好对上 τ-b 的结修正
- 样本量只有几十条,想要一个比 ρ 更不容易被单点带跑的等级相关
- 两位评审对同一批作品的打分排序是否一致
- 需要一个能直接讲成概率的关联指标(一致概率),而不只是一个抽象系数
前提与其他等级相关一致:变量至少是定序尺度(能排出高低),观测相互独立,关系需要是单调的。要额外记住的是量纲问题——τ-b 与 Pearson r、Spearman ρ 不在同一把尺子上,同一份数据里 |τ-b| 通常明显小于 |ρ|,所以卡① 和卡④ 才专门给了两套换算值。另外结比例过高时,τ-b 能达到的最大绝对值会明显小于 1,卡① 会逐变量把结比例报出来。
什么时候不要用它
- 两个变量都近似正态、关系又是直线:用「Pearson相关性分析」,检验效能更高,r² 也能按原始数值解释。
- 变量接近连续、结很少,而且你要和文献里的 ρ 对照:用「Spearman相关分析」更省事,两者在这种数据上结论通常一致。
- 关系不是全程单调(U 形、倒 U 形):τ-b 会被压到接近 0,先看秩散点图,再用「拟合工具箱」或「限制性立方样条(RCS)」描述曲线形状。
- 你想问的是“控制住某个变量之后还剩多少关联”:用「偏相关分析」。等级相关同样不等于因果,也排除不掉第三变量造成的伪相关。
- 要评的是三位及以上评分者排序的整体一致性:用「Kendall一致性检验」;如果评的是分类判断(阴性 / 阳性)而不是排序,用「Kappa一致性检验」。
- 两列都是无序分类(渠道、品牌):秩相关不适用,用「列联(交叉)分析」。
容易误读的地方
- 不能拿 Pearson r 的经验阈值直接判读 τ-b。 同一份数据里 |τ-b| 系统性地小于 |ρ|:实测最强的一对,Spearman 给 ρ = 0.633,这里给 τ-b = 0.460。而卡④ 的“效应量等级”列用的正是 Cohen 给 r 设的阈值,于是同一对变量在「Spearman相关分析」里被判“大”、在这里被判“中等”——两处并不矛盾,只是尺子不同,表注自己也写明这套阈值对 τ 偏严格。要横向比较,请用同表的 r̂ = sin(π·τ/2)(换到 Pearson r 量纲)或卡① 表3 的 ρ̂ = (6/π)·arcsin(r̂/2)(换到 Spearman ρ 量纲)。这两个公式不一样,别混用:直接拿 sin(π·τ/2) 去和 ρ 比,会带来约 0.01~0.02 的系统性偏差。
- |τ-b| 比 |ρ| 小,不代表它更不显著。 系数的量纲和检验是两回事。实测同一份数据的一对变量,τ-b = −0.161、p = 0.009,而 Spearman 的 ρ = −0.231、p = 0.011——绝对值更小的那个反而更显著。判断显著性看 p 与置信区间,判断强度看系数与一致概率,不要用其中一个去推另一个。
- 置信区间和 p 值可能给出相反的判定,因为它们不是同一条路算出来的。 表注写明:p 由含结修正的 Kendall 渐近方差给出(样本小且无结时改用精确分布),而 95%CI 走的是 Fieller 等(1957) 的 arctanh 变换,标准误 √(0.437/(N−4)) 只依赖样本量,不含任何结修正。实测一份 5 点李克特数据就出现过 τ-b = 0.141、p = 0.059(不显著),95%CI 却是 [0.022, 0.256](不含 0)。并列多的时候以 p 为准,只有它把结算进了方差;无论如何,这种边缘结果不要当成确定结论。
- τ-b 接近 0 只能排除单调关系,而且靠“τ 和 ρ 对得上”查不出非单调。 实测一份倒 U 形数据:整体 τ-b = −0.108(p = 0.080),由它换算的 ρ̂ = −0.161 与实算的 ρ = −0.104 只差 0.058,看着完全自洽;真正暴露问题的是同一行的分段 τ-b——低值段 0.817、高值段 −0.872。表注说得很明白,U 形下整体 τ-b 与 ρ 会同时趋近 0 且方向一致,只比较这两个数察觉不到。判定阈值是两段方向相反且强度均达 0.30,每段至少 10 条数据;该列显示为“—”表示诊断未执行,不代表通过。
- 结太多时 τ-b 根本到不了 1,而多重比较照样要做。 卡① 给结组个数与结比例,达到 50% 就判为“结较多,τ-b 的可达上界被压缩”(实测 5 点李克特数据的结比例是 95.8%)。分母的结修正让它比 ρ 更适合这类数据,但压缩依然存在,不要看到 0.4 就断定“只有中等关联”。另外拖 5 个变量就是 10 次两两检验,卡④ 给 Holm-Bonferroni 校正:本例校正前后都是 6 对显著,说明这些关联足够强,但这不是常态——换一份数据校正后掉下来几对是很常见的,结论请以校正后那一列为准。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
4 组要做 6 次两两检验,每次 5% 的假阳性概率累积到 26.5%。方差分析先用一次整体检验把这个概率压回 5%,显著之后再做自带校正的事后比较——绕开整体检验直接两两比,等于把这笔账藏了起来。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Kendall's tau-b 主结果表
- 输出结果三:可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
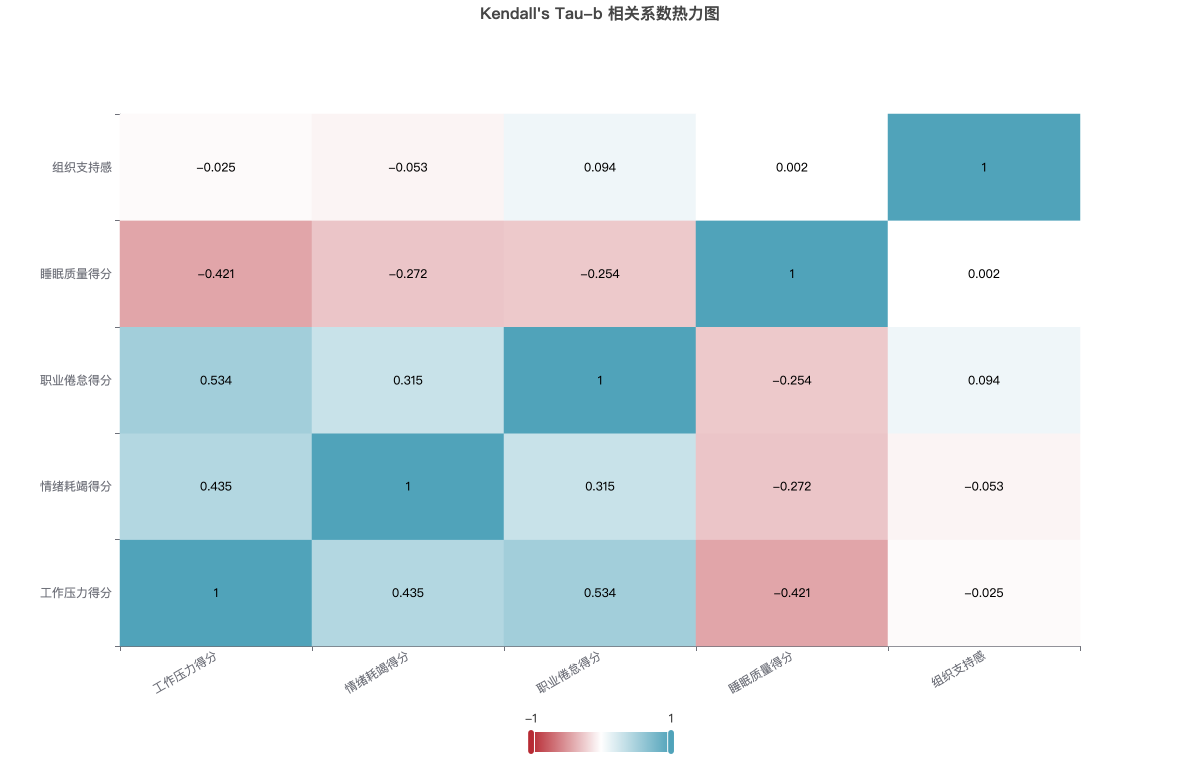
热力图颜色按 τ-b 取值映射(红=负相关,青绿=正相关),色阶固定在 [−1, 1] 上,便于跨报告比较;右上角切换器可改看柱状图/条形图或明细表(契约 §3)。
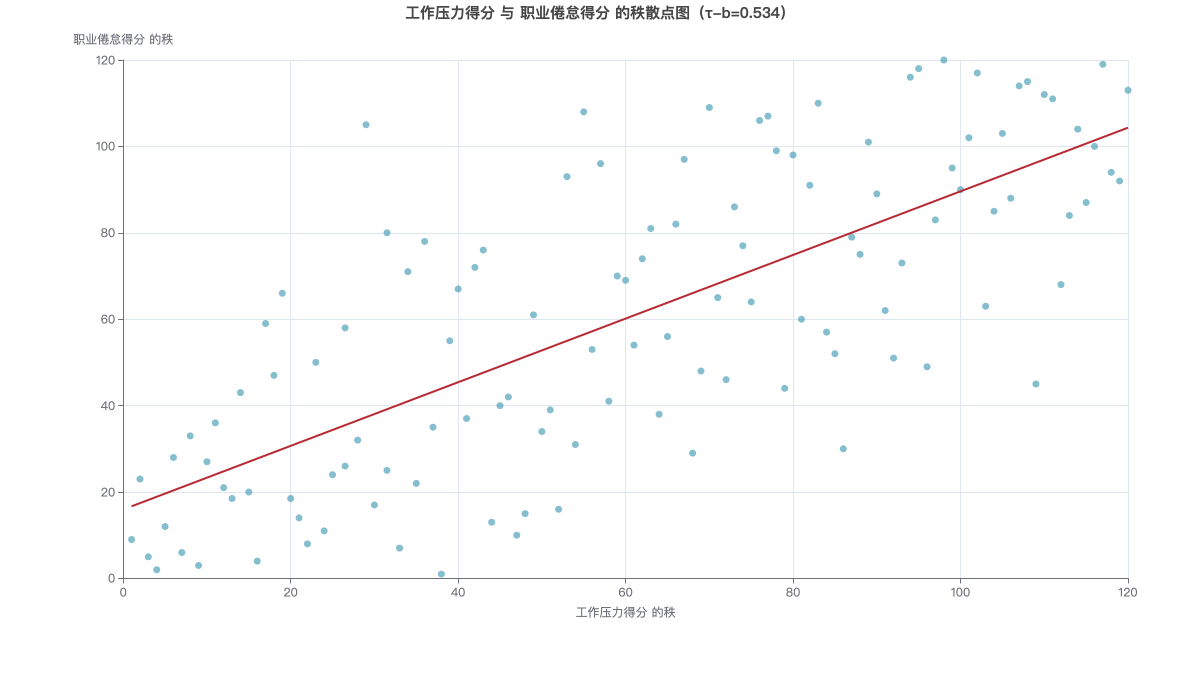
上图把「工作压力得分 — 职业倦怠得分」两变量各自换成秩后作散点,用于目视核查单调性。