
量具GageR&R(测量系统分析)
这个方法是做什么的
回答“我的量具和操作员,测出来的数有多少是真实差异、有多少是测量误差”。做法是让若干名操作员各自把同一批零件重复测量若干次,再用随机效应的双因素含交互方差分析把总变异拆成三块:重复性 EV(同一操作员重复测同一零件的波动,代表设备/量具本身)、再现性 AV(不同操作员之间的差异,含操作员主效应与零件×操作员交互)、零件间 PV(真正的产品差异)。前两者合起来就是量具 R&R。演示数据是 AIAG 手册建议的 10 零件 × 3 操作员 × 3 次重复共 90 次量测。
判定用两个指标。%GRR 按 √GRR/√TotalVar 计算(AIAG 判据:<10% 优秀、10%~30% 视应用与成本条件接受、>30% 不可接受),ndc(可区分类别数)=1.41×√(PV/GRR),表示这套测量系统能把零件分成多少档,AIAG 要求 ≥5。报告另给 ICC=PV/TotalVar 作为量具区分力的等价表达。卡④还把误差落到具体的人身上:操作员均值的两两比较(以交互均方为误差项、Holm 校正)定位系统性偏倚,分操作员的偏倚与重复性标准差则区分“手不稳”和“读数基准偏了”这两类完全不同的问题。交互不显著时,报告会额外给出把交互并入重复性的简化模型结果供相互印证。
需要准备什么数据
- 放入[定类]零件编号:不限
- 放入[定类]操作员/评价人:不限
- 放入[定量]测量值:不限
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 5%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]零件编号」的类别数需在 2~60 之间。
- 「放入[定类]操作员/评价人」的类别数需在 2~20 之间。
- 「放入[定类]零件编号」的每一组至少 4 个样本。
- 「放入[定类]操作员/评价人」的每一组至少 4 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 新量具、新检具、新测量方法投用前的验收
- 控制图上波动一直偏大,怀疑相当一部分来自测量而不是工艺
- 体系审核(IATF 16949、AIAG MSA)要求提交测量系统分析报告
- 做过程能力研究之前,先确认 σ 里没有掺进过多的测量误差
前提是硬的:必须是平衡完全交叉设计——每名操作员都测量全部零件,且每个“零件×操作员”组合的重复次数完全相同且至少 2 次,否则无法把重复性从交互中分离出来,模块在数据不平衡时会直接拦截并提示补齐。至少 2 个零件、2 名操作员;数据要求把行数下限定在 20,AIAG 建议的规模是 10×3×3=90 行。还有一条容易被忽略却最要命:所选零件必须覆盖实际生产的变异范围,卡①用零件主效应的显著性检验这个前提。
什么时候不要用它
- 要评估的是量具准不准(偏倚、线性)而不是稳不稳:Gage R&R 只管精密度,用标准件做偏倚/线性研究;比较两种测量方法是否一致请用「Bland-Altman法」。
- 数据不是平衡完全交叉(有人只测了部分零件、重复次数不齐):本模块会拦截,改用「方差成分分析」按不平衡随机效应模型估计各分量。
- 测量结果是分类判定(合格/不合格、等级 A/B/C)而不是连续读数:方差分解无从谈起,用「Kappa一致性检验」评估评价人之间的一致性。
- 评的是量表、问卷或评分者信度,不是工业量具:用「组内相关系数(ICC)」,它的模型选择更贴合评分场景。
- 零件与操作员是你真正关心的固定水平(就这三个人、就这十件),而不是从总体里抽样:随机效应的 EMS 口径不适用,用「双因素方差分析」按固定效应处理。
- 想知道过程本身够不够格:那是另一件事,用「过程能力分析」;本模块只回答“量出来的数可不可信”。
容易误读的地方
- 两个 %GRR 口径不能混用判据,混了会把不合格的量具判成优秀。 报告同时给出 %研究变异 30.14% 与 %贡献 9.08%。前者是标准差占比,是 AIAG 判据(<10%/10~30%/>30%)针对的那一个;后者是方差占比,因为开了平方,数值恒小于等于前者。演示数据按 30.14% 判是“不可接受”,若拿 9.08% 去对 <10% 这条线,会得出“优秀”的相反结论。卡③的图注专门解释了两者的大小关系,卡④的结论文案也点名了“两者判据不可混用”。
- 重复性和再现性指的是完全不同的两件事,改进方向也完全相反。 重复性 EV 是同一个人拿同一把量具重复测同一个零件的波动,问题在设备(夹持不稳、分辨力不足、量具磨损);再现性 AV 是不同人之间的差异,问题在人和方法(读数习惯、基准设定、作业指导书不清)。演示数据 σ_EV=0.038153、σ_AV=0.080972,卡④的结论文案据此给出“以再现性为主,改进重点在作业标准化与操作员培训”——这种情况下换一把更贵的量具是白花钱。
- 零件选窄了,好量具也会被判成不合格。 %GRR 的分母是本次所选零件的总变异,零件之间越接近,分母越小,同样的测量误差算出来的 %GRR 越差。卡①的表注把这称为 MSA 里最容易被忽视也最容易毁掉结论的前提,并用零件主效应的 F 检验来把关(演示 F(9,18)=831.232,p<0.001,说明零件确实跨越了可分辨的范围)。卡⑤进一步提醒:若产品有明确公差,还应报告相对公差的 %P/T=6σ_GRR/公差带,零件选窄时 %GRR 会变差而 %P/T 不变,两者可能给出相反结论;%P/T 本模块不计算,需按公差带自行折算。
- F 检验的分母是交互均方,不是误差均方——所以自由度看起来“不对”是对的。 随机效应模型下 E[MS_零件]=σ²_e+n·σ²_交互+b·n·σ²_零件,因此零件与操作员都要以交互均方为分母,只有交互项才以误差均方为分母。演示数据零件是 F(9,18)、操作员是 F(2,18)、交互是 F(18,60)。卡②的表注写明:若像固定效应模型那样一律除以误差均方,会系统性高估零件与操作员的显著性。同理,卡④操作员两两比较的自由度取的是交互自由度 18 而非误差自由度。
- 方差分量为负被截断成 0,是个需要留意的信号而不是修正。 EMS 法解出的分量可能为负,报告按惯例截断为 0。演示数据交互分量正是这种情况(σ²_交互=0.000000),卡⑤的“局限”一栏解释说这提示对应效应的真实方差接近 0,同时也提示样本量偏小。截断之后 AV 就完全等于操作员主效应,读数时要知道这一步做过。
- 操作员之间“全部显著”不等于量具不行。 演示数据操作员主效应 F(2,18)=227.237、p<0.001,三对两两比较经 Holm 校正后全部显著,三名操作员的均值分别高出/低于总均值 0.0749、0.0113、−0.0862。这些差异全部属于再现性,说明的是读数方法或基准设定不统一。把它读成“量具精度不够”,会导致换量具而问题照旧。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:双因素含交互 ANOVA(主结果)
- 输出结果三:可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
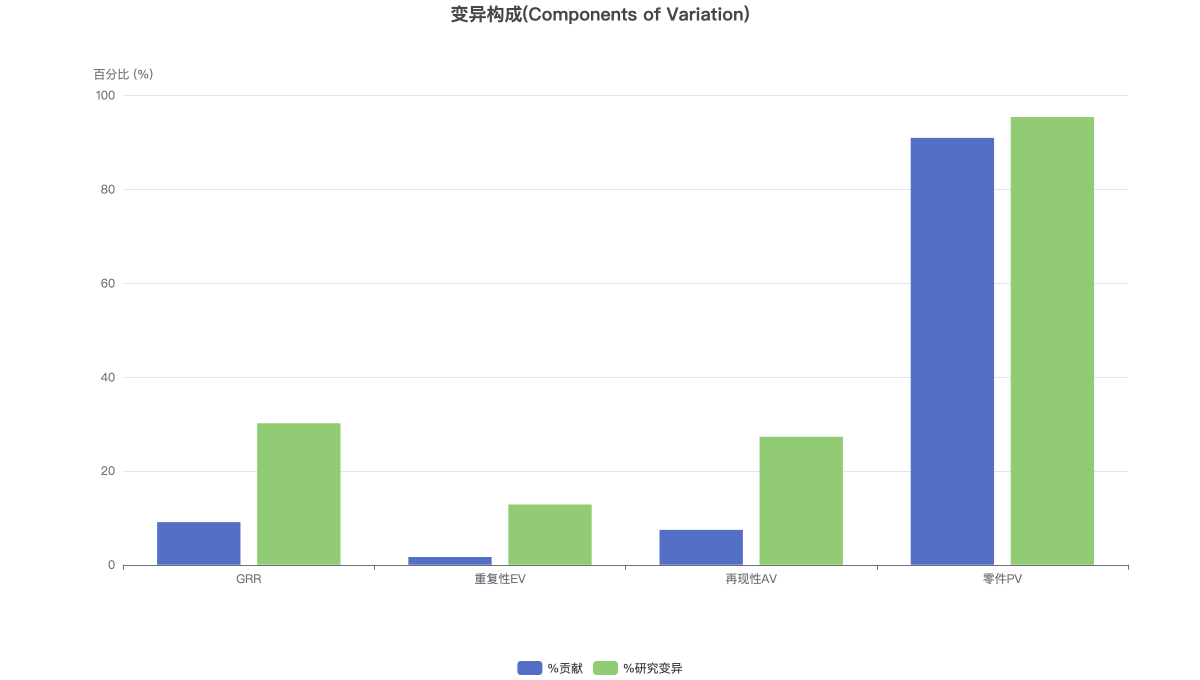
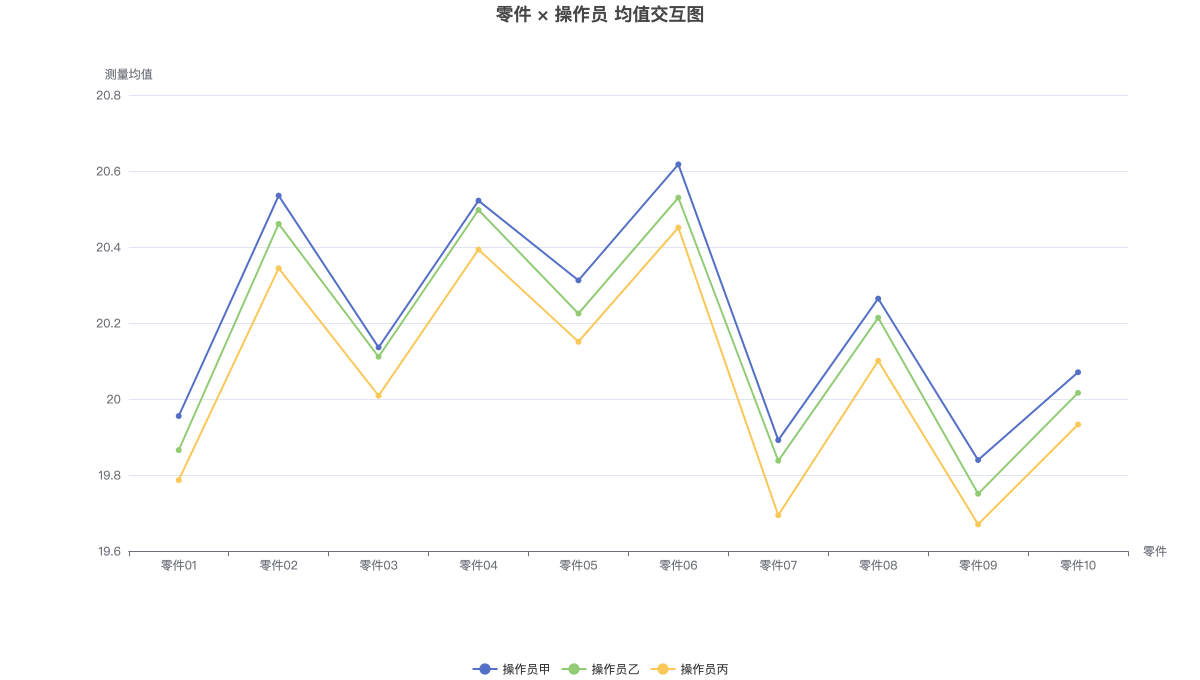
上图为变异构成(同一分量的 %贡献恒小于等于其 %研究变异,因为前者是方差占比、后者是标准差占比);下图为零件×操作员均值交互图。两图均可用切换器在图形/数据表之间切换。