
关联分析
这个方法是做什么的
从交易记录里挖出“买了 A 的人更可能同时买 B”这类共现规则。输入必须是长表:一行 = 一笔交易里的一个项目,索引变量标识交易(订单 / 顾客 / 病例),待分析变量标识项目(商品 / 症状 / 标签)。每条规则给出三个基本量——支持度(这条规则覆盖了多少比例的交易)、置信度(买了前项的交易中有多少也买了后项)、提升度(这种共现比“两者独立”的情形高出多少倍)。
除了这三个数,报告还把每条规则还原成一张 2×2 列联表做 Pearson χ²(1) 独立性检验,并用 Benjamini-Hochberg 法控制多条规则同时检验的错误发现率;第四张卡给提升度的 95% 置信区间(由对数提升度的 delta 法方差经指数变换得到,区间不含 1 与 χ² 显著等价),以及 Kulczynski、余弦、全置信度这三个“零不变”度量和不平衡比 IR。读这份报告的着眼点与别的方法不同:先看提升度的区间含不含 1,再回头看置信度有多高——置信度决定这条规则值不值得用,提升度区间决定它是不是真关联。
需要准备什么数据
- 放入 [定类] 待分析变量:1 个,定类变量(分组/标签)
- 放入 [定类] 索引变量:1 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 10%。
- 「放入 [定类] 待分析变量」的类别数需在 2~2000 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 购物篮分析:找捆绑销售、交叉推荐的候选组合
- 症状 / 诊断 / 标签之间的共现规律
- 已经是“一笔交易占多行”的长表明细数据
- 想区分“真关联”与“两个热门项目碰巧一起出现”
前提是数据确为长表:同一笔交易必须占多行,若每笔交易只有一行则形不成项集、挖不出任何规则。两列都必须是定类变量且不能是同一列。交易数(索引变量的唯一值个数)决定支持度的估计精度,第一张卡的结论文案给了口径:支持度的抽样标准误约为 √(s(1−s)/T),T 越小同一阈值下挖出的规则越不稳定。含缺失的记录会被整条剔除——实测把 40 条记录的项目列置空后,交易数 T 从 220 降到 207、全部支持度随之改变,而项目数仍是 9(缺失并不会变成一个新项目);第一张卡的“有效记录数 / 剔除缺失”一行会把剔掉多少条报出来,动笔前先看这一行。
什么时候不要用它
- 数据是“一行一个受访者、每个选项一列的 0/1”多选题:这不是长表,用「多选分析」。
- 要看两个分类变量的整体关联而不是逐条规则:用「列联(交叉)分析」看交叉表,用「卡方检验」判独立性。
- 问题是“选哪几个方案能覆盖最多的人”:那是净触达而非共现,用「TURF触达频次分析」。
- 想把顾客或交易分成若干群:关联分析不产生分群,用「聚类分析(K-Means)」。
- 想量化某个因素对“是否购买”的净效应并控制其他变量:用「逻辑回归」。
容易误读的地方
- 筛选阈值那个输入框换了指标就换了量纲,一不留神会把整份规则表清空。 默认是“置信度 ≥ 0.6”,0.6 对置信度是个合理门槛;把指标切成“支持度”而阈值仍是 0.6,实测规则数直接变成 0,第二张卡的规则表、第三张卡的热力图、第四张卡的效应量表整块不显示,报告只剩前提检验、频繁项集和一句“当前参数下未挖出满足阈值的关联规则”。切成“提升度”时 0.6 又太低(提升度以 1 为无效基准)。改指标必须同时改阈值。
- 置信度高可能只是后项本身热门。 实测“尿布 → 牛奶”的置信度 0.637 看着不低,但提升度只有 0.973、95%CI [0.884, 1.072] 含 1,χ² 的 p = 0.578——与“两者独立”没有区别。原因是牛奶自身的支持度就有 0.655,随便挑一个前项,后面跟牛奶的比例都不会低。第二张卡的结论文案对此写得很直白:置信度不减去后项本身的流行度。
- A→B 与 B→A 的提升度必然相同,方向性只能从置信度读。 实测“面包 → 牛奶”与“牛奶 → 面包”的提升度都是 1.362、置信区间也逐位相同,而置信度是 0.891 与 0.854、信念是 3.178 与 2.556。提升度、χ²、Kulczynski、余弦这几个量在数学上是对称的,所以“提升度高说明买面包会带动牛奶”这句话在提升度上找不到依据;在这张规则表的关联强度度量里,只有置信度与信念是不对称的,方向性只能从这两列读。
- 规则一多就要看 BH 校正列,不能看未校正的 p。 每条规则都做一次 χ² 检验,规则数就是同时进行的检验数。实测 7 条规则时校正前后都是 4 条显著、差别不大,但项目数一增加规则数会成倍上涨,那时两列会明显分开。表注已注明校正口径,论文里报的应当是校正后那一列。
- 交易的切分方式一变,全部支持度都会变。 支持度的分母是交易数 T,而同一批原始记录按订单切、按顾客切、按时间窗切会得到完全不同的 T。第五张卡的解释边界把这一条与“共现不是因果”并列写出:一条规则既可能来自互补需求,也可能来自促销、陈列、季节这些共同的第三方因素。要把规则用于捆绑或推荐,得再做一次 A/B 验证。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:频繁项集与关联规则
- 输出结果三:关联强度可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
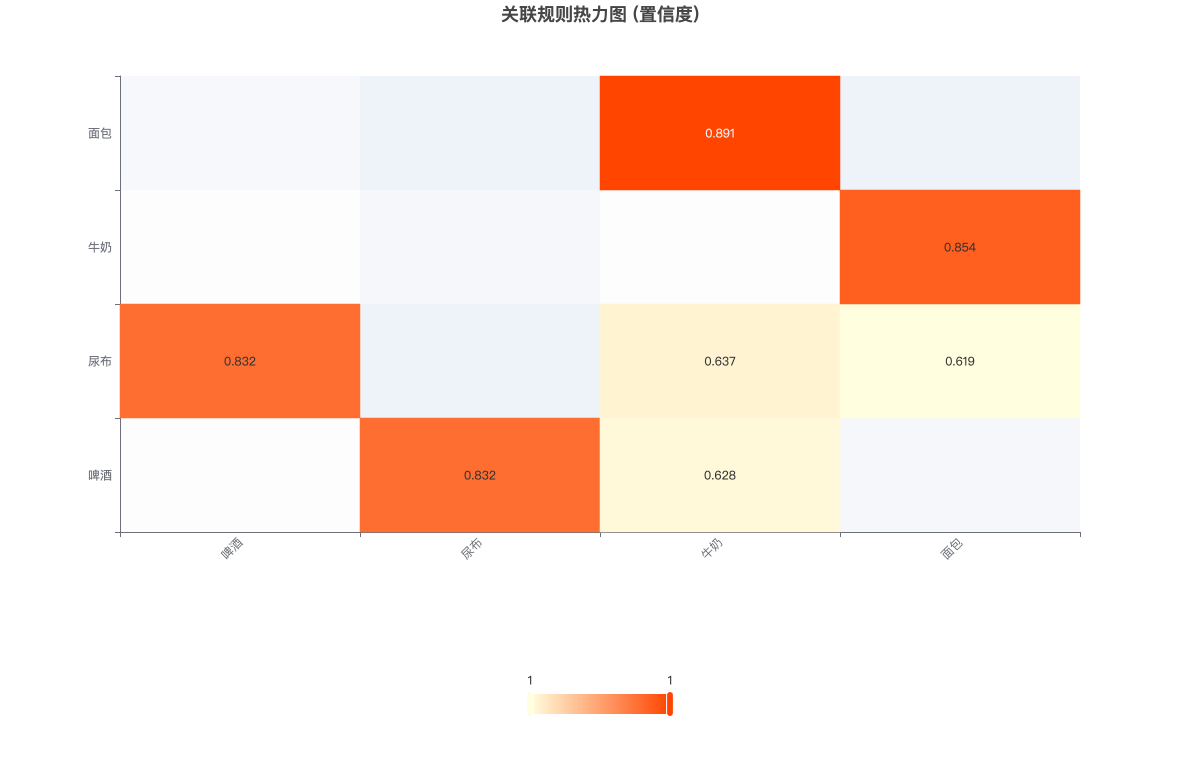
热力图展示「一对一」关联规则的强度:方块颜色对应「置信度」的大小,颜色越深(红)关联性越强。可用右上角切换器切到「条形图/表格」逐条读数。