
链式中介效应
这个方法是做什么的
链式(序列)中介和平行中介问的是同一类问题——机制——但多了一层:中介变量之间有先后。X 先影响 M₁,M₁ 再影响 M₂,M₂ 才影响 Y。这条顺序由你拖拽中介变量的先后决定,模块据此估计各段方程:a 是 X 对第一个中介的效应,d 是中介之间的传导,b 是最后一个中介对 Y 的效应,链式间接效应就是这几个系数的连乘。中介区至少要放 2 个变量,自变量与因变量各 1 个。
第四张卡是主结果:链式间接效应的点估计、2000 次 Bootstrap 的百分位 95% 置信区间(判定以区间是否含 0 为准)、Bootstrap 均值与标准误、Sobel 型 delta 法区间、中介比例 P_M 及其区间、完全标准化间接效应 ab_cs,另附一张“构成链式间接效应的各段路径”表用于定位薄弱环节。第二张卡给各分方程的完整回归结果、重组成路径的分解表,以及可直接排进正文的紧凑版系数表。第一张卡做最终方程的 VIF、残差正态性与 Breusch-Pagan 检验。
需要准备什么数据
- 因变量(单个):定量变量(数值)
- 自变量(单个):定量变量(数值)
- 串行中介(≥2列):至少 2 个,定量变量(数值)
- 控制变量(可选)(可选):定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 理论上存在一条明确的传导链(领导风格 → 满意度 → 信任 → 承诺),而不是几条并列的机制
- 想验证“中间还有一环”:X 影响了 M₁ 之后,是 M₁ 带动 M₂,M₂ 才作用于 Y
- 链条顺序有时间先后或实验操纵支撑,不是事后从相关矩阵里凑出来的
- 需要报告这条链在总效应里占多少,以及可跨研究比较的效应量 ab_cs
四个拖拽区都只收定量变量,定类列会在入口被点名拒绝;同一个变量不能出现在两个区;不得含常数列。技术上有效行数不少于 50 就能跑,但数据要求里写明文献通常建议 N ≥ 100,且链条越长要求越高——间接效应是多个系数的乘积,链条每加一段,估计的抖动就放大一层。
什么时候不要用它
- 几个中介之间并没有先后,是并列的机制:本模块会把它们强行串成一条链。改用「平行中介效应」,它逐条给出每个中介的间接效应,还能做两两强度对比,这两样本模块都不提供。
- 只有一个中介变量:中介区要求至少 2 列。单中介模型用「平行中介效应」,放一个中介即可,它的第一张卡会判定“单一中介,无需做中介间对比”。
- 你要问的是“在什么条件下效应更强”,而不是“经由什么传导”:那是边界条件问题,不是机制问题。用「调节作用分析」。
- 因变量不是定量的:二分类结局用「逻辑回归」,等级结局用「有序逻辑回归」,计数结局用「计数数据回归」,不要把这类结局硬当连续变量跑中介。
- 链条顺序其实是从相关矩阵里挑出来的:模块自己写明,同一批横截面数据换一个链条顺序同样能跑出“显著”的间接效应。没有理论或时序支撑时,退回「线性回归 (最小二乘法)」如实报告各变量对 Y 的关联,或用「偏相关分析」在控制其余变量后看两两关系,不要用中介的口吻写结论。
- 观测之间不独立(同一批人多期测量、个体嵌套在组织里):各段方程都是普通最小二乘,标准误会被低估。有个体与时间两维结构的用「面板模型」,重复测量或分层嵌套的用「混合模型」。
容易误读的地方
- 链条的顺序是你拖出来的,统计上不可检验。 第一张卡有一条“[说明]”,先把你这次的链条名字念一遍,接着逐字写道:“由拖拽顺序决定,统计上无法检验其正确性——中介的方向性完全依赖理论与研究设计(尤其是时间先后)。同一批横截面数据换一个链条顺序同样能跑出‘显著’的间接效应。”所以“我试了几种顺序,这种最显著”是最坏的做法——它把一个本就不可检验的假设,变成了数据挖掘的产物。
- c − c′ 不等于这里报告的链式间接效应,差额不是算错。 示例中 c = 0.6319、c′ = 0.1847,两者之差 0.4472,而链式间接效应只有 0.1358。原因是本模块只估计完整链条 X→M₁→…→Mₖ→Y 这一条,不分解经由单个中介的其它间接路径(X→M₁→Y、X→M₂→Y)。这件事写在两处:第五张卡的“解释边界”,以及第四张卡表8 里“总效应 c / 直接效应 c′”那一行的“解读”单元格——“c = c′ + 全部间接效应之和(含本链条以外的其它间接路径)”。想把其余路径也拆出来,需要用「平行中介效应」另跑一次。
- 中介比例 P_M 说的只是这一条链的份额。 示例 P_M = 0.2148,含义是总效应中约 21.48% 由这条链传导;剩下的 78% 既包含直接效应,也包含上一条讲的那些未被分解的路径。把它读成“中介总共解释了 21%”是把两件事混在一起。P_M 还继承了它的一般毛病:只有间接效应与总效应同号、且总效应不接近 0 时才能解释为比例,符号相反时是遮掩效应的信号。
- 链条上任何一段接近 0,整条链都会被压向 0;而分段显著与乘积显著是两回事。 第四张卡的分段表就是用来定位薄弱环节的:示例三段分别为 0.5860、0.5011、0.4623,全部显著,乘积才站得住。同时留意路径分解表里另有一行 a:变革型领导 → 组织信任 = 0.0743,p = 0.278 并不显著——它是“X 直接作用于第二个中介”的那条路,不属于本链条,却说明绕过第一个中介的替代通路很弱。反方向的错误同样常见:某一段显著不代表乘积显著,判定必须回到区间。
- 判定看 Bootstrap 百分位区间,不看 z 检验。 间接效应是乘积项,抽样分布偏态;模块同时给出的 Bootstrap z 与 Sobel 型 delta 法都是正态近似,表注写明它们在偏态时偏保守、仅供参考。示例里三者都指向显著(区间 [0.0806, 0.2054] 不含 0),一旦不一致,以百分位区间为准。样本量同理:能跑起来的技术下限是 50,够不够用要看那条 N ≥ 100 的经验建议。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:中介效应模型系数与路径分解
- 输出结果三:中介效应模型图与效应分解
- 输出结果四:间接效应、效应量与事后检验
- 输出结果五:结论与学术表述
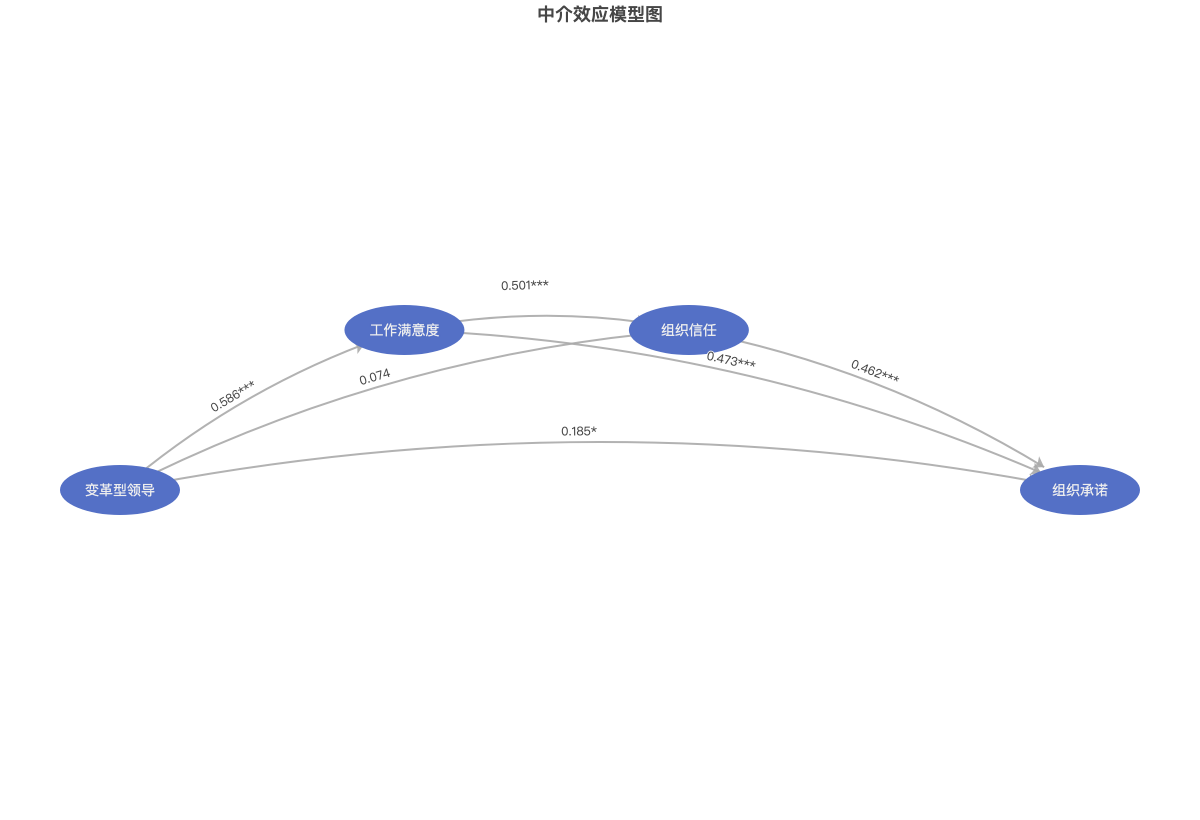
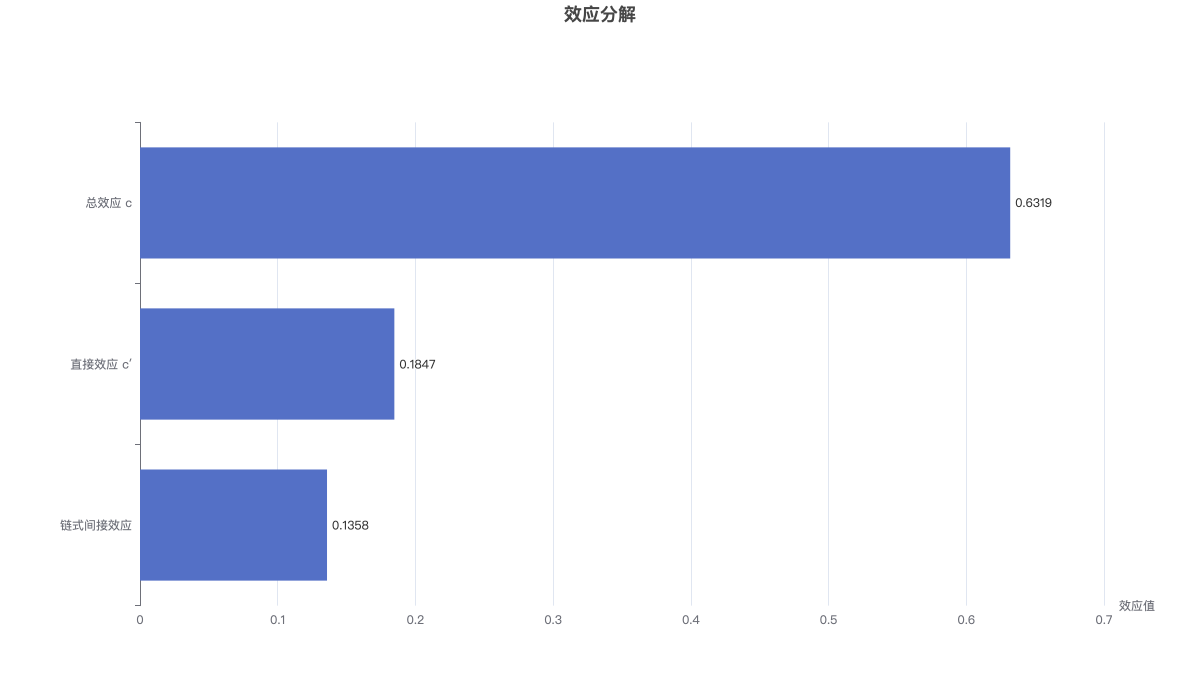
上图为路径图,箭线上标注各路径的非标准化系数与显著性星号;下图把总效应、直接效应与本条链式间接效应画在同一横轴上以便比较量级。两图均可用右上角切换器切到「表格」视图读取精确数值。