
分层卡方分析
这个方法是做什么的
在控制一个混杂因素的前提下,检验二分类暴露与二分类结局还有没有关联。做法是按分层变量把数据切成若干张四格表,在每一层内部比较,再用 Cochran-Mantel-Haenszel 方法把各层结果加权合并。它与“先把所有人合成一张大表再做卡方”是两回事:后者会被辛普森悖论扭曲,前者不会。
报告分三层回答问题。第二张卡给逐层四格表、逐层 OR 与合并结果(示例 CMH χ²(1)=6.317、p=0.012,Mantel-Haenszel 合并 OR=1.904,95%CI[1.151, 3.149]),另附连续性校正版本。第四张卡是决定结论能不能这样写的地方:Breslow-Day 齐性检验(示例 χ²(2)=2.488、p=0.288)判断“一个共同 OR”这个概念成不成立;粗 OR(2.041)与校正 OR 之差被量化为混杂程度(7.22%);逐层 Fisher 精确 p 再做 Holm 校正。第三张卡的森林图把各层 OR 与合并菱形画在一起,是最快看出各层是否一致的入口。
需要准备什么数据
- 暴露变量 X (2分类):1 个,定类变量(分组/标签)
- 结局变量 Y (2分类):1 个,定类变量(分组/标签)
- 分层变量 Z (分类):1 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 30%。
- 「暴露变量 X (2分类)」必须正好是 2 个类别。
- 「结局变量 Y (2分类)」必须正好是 2 个类别。
- 「分层变量 Z (分类)」的类别数需在 2~10 之间。
- 「分层变量 Z (分类)」的每一组至少 8 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 评估暴露与发病的关联时需要扣掉年龄、性别等已知混杂
- 多中心研究按中心分层,看合并后关联是否仍成立
- 病例对照研究按配对因素分层估计合并 OR
- 想验证一个“粗看有关联”的结论是不是混杂造成的假象
三个拖拽区都必须是分类变量,且暴露与结局恰好两类(非两类端点直接拒绝),分层变量 2~10 层、每层至少 8 条记录,总样本不少于 30。CMH 的一个重要优点是允许层内稀疏:它只要求合计够大(判据 ΣE(a)≥5 且 ΣVar(a)≥5,示例实测 46.137 与 15.399),不要求每层的期望频数都达标——这正是它比“逐层各做一次卡方”更有用的地方。第一张卡会逐层给出样本量、最小期望频数与零格数。
什么时候不要用它
- 手上只有两个变量、没有需要控制的混杂:分层反而白白损失效能,直接用「Pearson卡方检验」。
- 暴露或结局多于两类:本模块会拒绝。先按研究问题合并成两类回到这里,或改用能容纳多分类的「逻辑回归」;结局有序时用「有序逻辑回归」。
- 需要同时控制两个以上混杂因素:分层会迅速把格子稀释到无法估计,应改用「逻辑回归」把混杂因素一并作为协变量入模。
- 配对或成组匹配的病例对照设计(每层只有一个病例配几个对照):层内信息量太小,应改用「条件逻辑回归」。
- 分层变量位于暴露到结局的因果链上(中间变量):分层会把真实效应错误地扣掉;要估计经由它的路径,用「链式中介效应」。
- 结局是“多久发生”而不是“是否发生”:用「Cox比例风险回归」,它能同时容纳随访时长与删失。
容易误读的地方
- 先看 Breslow-Day,再看 CMH 的 p——顺序反了会得出完全相反的结论。 实测构造一份存在效应修饰的数据:Breslow-Day p=0.013(各层 OR 不齐),CMH p=0.787、合并 OR=0.935(95%CI[0.571, 1.531])看上去就是“没有关联”;可逐层是老年组 OR=0.365(95%CI[0.154, 0.866])与青年组 OR=2.263,方向相反、在合并时互相抵消。齐性不成立时那个合并 OR 不是“平均效应”,它什么也不是,必须分层报告。
- 混杂程度很小不等于分层没必要。 还是上面那份数据:混杂程度只有 0.72%(粗 OR 0.942 对校正 OR 0.935),报告如实写着“分层变量的混杂作用有限”,而同一张卡的 Breslow-Day 已经显著。混杂与效应修饰是两个独立的问题——前者问粗 OR 和合并 OR 差多少,后者问各层 OR 彼此差多少;10% 那条经验线只管前者,管不到后者。
- 逐层不显著而合并显著,这不是矛盾。 默认示例里 CMH 合并 p=0.012 显著,逐层 Fisher 经 Holm 校正后 0/3 层显著(老年组原始 p=0.034,校正后 0.101)。CMH 把三层的证据累加起来才够强度,单看任何一层样本量都不足。齐性成立时主结论看合并,逐层表只作探索;齐性不成立时才反过来。
- 谁是“暴露”、谁是“阳性结局”由类别取值的排序决定,模块不会问你。 实测把“暴露/非暴露”与“发病/未发病”同时改写成“是/否”:OR 仍然是 1.904(行列同时翻转对 OR 恰好抵消),可合并 RR 从 1.533 变成了 1.219——它算的已经是另一个量。OR 对这种改写免疫,最容易让人放松警惕;定稿前请照第二张卡的表头逐字核对四个格子各是谁。
- 分层只能控制被拖进去的那一个变量,而且它必须是混杂因素而非中间变量。 第一张卡把这一条的判定栏标成“不可统计检验”,并在表注里说明须由研究者按专业知识判定——统计上分不出来。若 Z 处在暴露→结局的因果路径上,分层等于把真实效应扣掉一部分,得到的“校正后无关联”是人为制造的。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二: 分层卡方检验主结果表
- 输出结果三: 分层 OR 森林图
- 输出结果四: 效应量与事后分析
- 输出结果五: 结论与学术表述
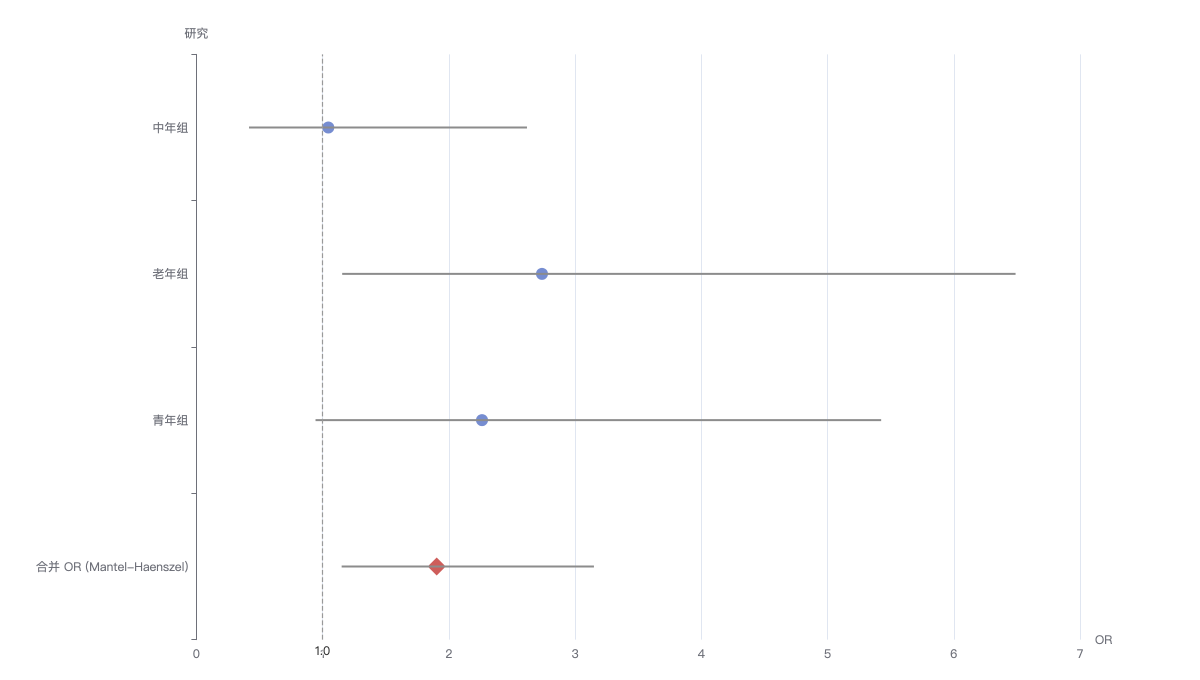
上图为按“年龄分层”分层的比值比(OR)森林图:每个圆点是该分层内“是否暴露”与“是否发病”的 OR 点估计,两侧横须为其 95% 置信区间(与“输出结果二: 分层卡方检验主结果表”的 OR 及 95%CI 列同源);底部红色菱形为 Mantel-Haenszel 合并 OR 及其 95%CI(与“输出结果四: OR值估计表”一致)。可用右上角的视图切换器切到「表格」查看逐层 OR 与区间的数值。