
AdaBoost分类
这个方法是做什么的
用一串弱分类器接力来判类别:先训练第一个弱分类器,把它判错的样本权重调高,再训练第二个专门去啃这些难样本,如此重复 50 轮,最后按各轮的表现给它们不同的投票权重加权表决。和随机森林“各棵树互不相干、平行长出来再平权投票”不同,本模块是顺序的,后一轮完全取决于前一轮错在哪里。因变量为定类列,自变量可含定量与定类,定类列在管线内独热编码;报告不产出系数、优势比或针对自变量的 p 值。
报告共五张卡:卡① 建模设置与八项前提体检,卡② 分层 5 折交叉验证主结果与无信息率检验,卡③ 混淆矩阵与 ROC/PR/逐类别指标四张图,卡④ 效应量与置换重要性,卡⑤ 论文表述。本模块有一件事报告没写、但决定你怎么读它:卡① 只印“弱学习器数量 50”和“学习率 1.0”,没有一行告诉你弱学习器是什么——它是深度为 1 的决策树,也就是只在一个自变量上砍一刀的“树桩”。50 个树桩加权相加,本质上是一个加性模型:每个自变量各自贡献一段,彼此之间不相乘。这条性质决定了它擅长什么、又结构性地做不到什么(见下)。
需要准备什么数据
- 放入因变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入因变量Y」的类别数需在 2~20 之间。
- 「放入因变量Y」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 类别边界比较复杂、单个简单规则明显欠拟合,但你相信各自变量的作用基本是各管各的
- 想要一个比单棵决策树强、又比深树集成更不容易记住噪声的中等复杂度模型
- 自变量个数不多(几个到十几个),每一个都经过挑选、确认与结局有关
- 需要一个与随机森林、提升树口径一致的对照结果,用来判断“换个算法结论会不会变”
前提:因变量是定类列,2~20 个类别、每类至少 5 例;整表至少 30 行,含缺失的整行剔除。还有一条不在体检表里、但对本模块格外要紧:训练样本的标签要可靠。逐轮抬高错分样本权重的机制意味着,一个标错的样本会被后面几轮反复“重点照顾”,最终吃掉相当一部分模型容量。
什么时候不要用它
- 因变量是连续数值:用「AdaBoost回归」。
- 要报告每个自变量的效应方向、大小与显著性:本模块整份报告没有系数表;二分类结局用「逻辑回归」,结局有序用「有序逻辑回归」。
- 你关心的机制本身就是交互(“促销只在大店有效”):树桩加性结构表达不了变量之间的相乘关系,换成单棵树深度更大的「随机森林分类」或「GBDT梯度提升分类」。
- 数据里有明显的极端值或疑似误标:这两类样本会被权重机制放大成模型的主要目标;极端值先用「缩尾处理(Winsorize)」处理,误标只能回到数据本身核对。
- 观测之间不独立(同一对象多期、班级或医院内嵌套):交叉验证会把同一个体拆到训练折与验证折两边,性能虚高;用「面板模型」或「混合模型」。
- 想看的是各组在多个指标上的整体分离结构、并画一张二维分离图:那是判别分析的活,用「线性判别分析」。
容易误读的地方
- “较强(substantial)”这个量级词是点估计的标签,不是有把握的结论。 演示数据的 Cohen's κ=0.6169,卡④ 表7 按 Landis & Koch 判为“较强(substantial)”——而这套分级的切点正好是 0.61,κ 再少 0.007 同一份数据就会印成“中等(moderate)”。同一行给出的 95%CI 是 [0.5232, 0.7087],横跨这条切点。往外写的时候报 κ 的数值与区间,不要只抄那个词。
- 别把“学习率要小”的经验从提升树搬过来。 本模块的学习率默认 1.0,而同族的 GBDT、XGBoost、LightGBM 默认都是 0.1,因为两处的学习率作用位置不同:这里它乘在每个树桩的投票权重上。卡① 的第二条方法学说明写着“学习率越小往往需要越多弱学习器”。实测:只把学习率从 1.0 调到 0.1、轮数仍是 50,交叉验证 Accuracy 从 0.8083 掉到 0.7750、κ 从 0.6179 掉到 0.5523;把轮数同时加到 500 也只回到 0.7833 / 0.5680,并没有补回来。这两个控件要一起改,而且改了未必更好。
- PR-AUC 比 ROC-AUC 高不是算错了。 表4 里 PR-AUC=0.9244、ROC-AUC=0.9143。两者的“及格线”不同:ROC 的随机基线恒为 0.5,PR 的基线是正类占比,本次是 0.5125(卡④ 表7 那一行写明了)。所以两个数不能直接比大小,只能各自和自己的基线比。类别越不平衡,正类占比越低,PR-AUC 的基线越低、数值也越低,那不是模型变差。
- 卡① 的八项体检里没有一项在查“标签有没有标错”。 最接近的两项是“完全重复记录(数据泄漏)”与“标签泄漏扫描(NMI)”,前者查重复行、后者查某个自变量是不是把答案带进来了,都不是标签噪声。而本模块的权重机制会主动去追那些“怎么都判不对”的样本——一个标错的标签不但不会被忽略,还会被后面几轮当成重点。体检八项全“通过”不构成“数据是干净的”这一结论。
- 顺序训练意味着弱学习器数量不是越多越好。 随机森林加树只降方差,本模块加轮次会持续提高对训练数据的贴合度:卡① 的方法学说明写的是“弱学习器数量越多集成的表达能力越强但训练更慢且可能过拟合”。调完这个数必须回到表4 看交叉验证均值有没有真的涨,而不是看留出测试集那一列——后者只有 48 例,波动大得多。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉验证性能主结果表
- 输出结果三:分类效果可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
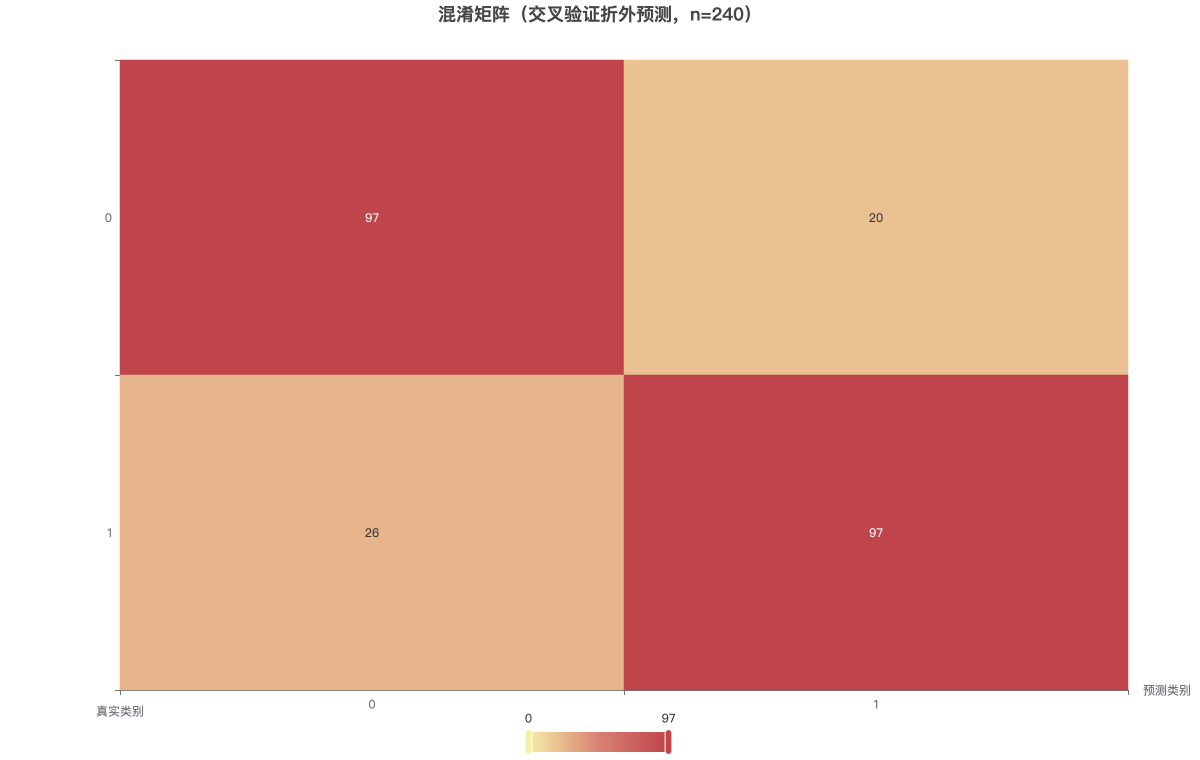
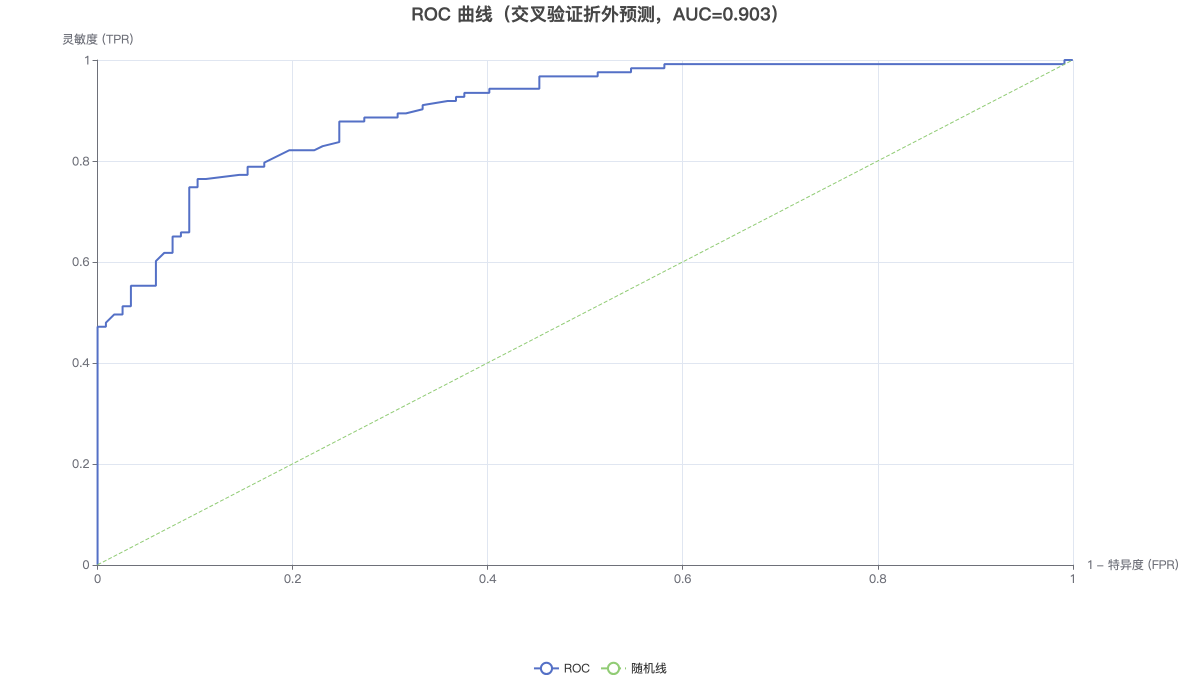
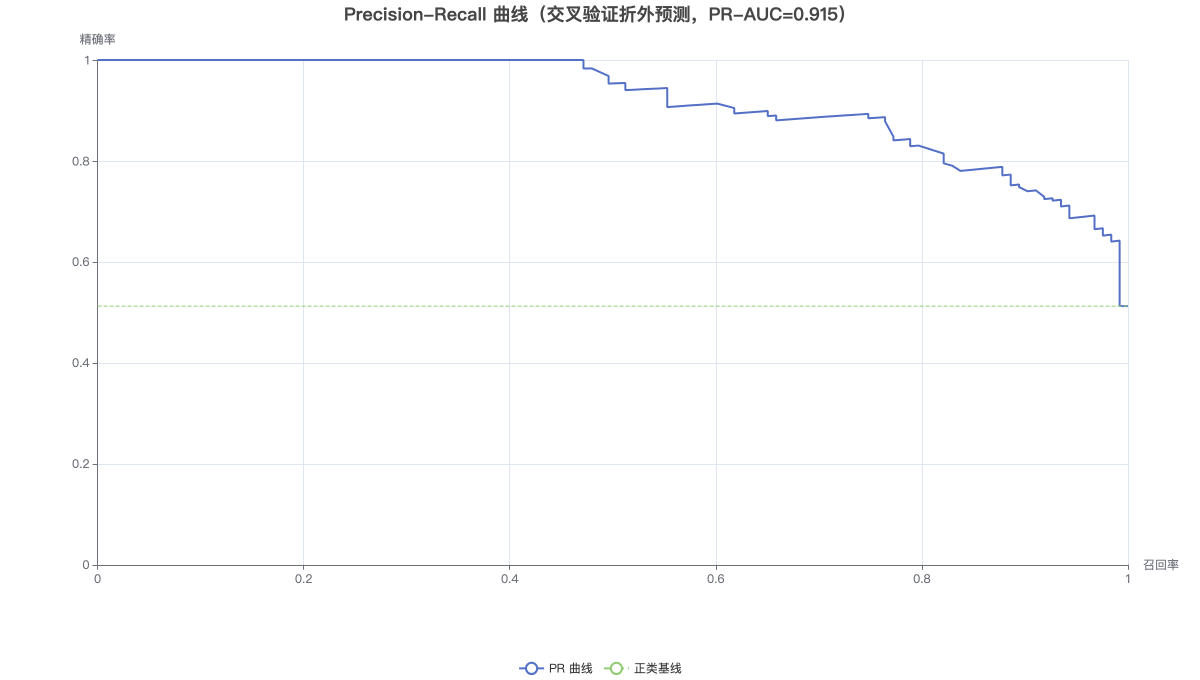
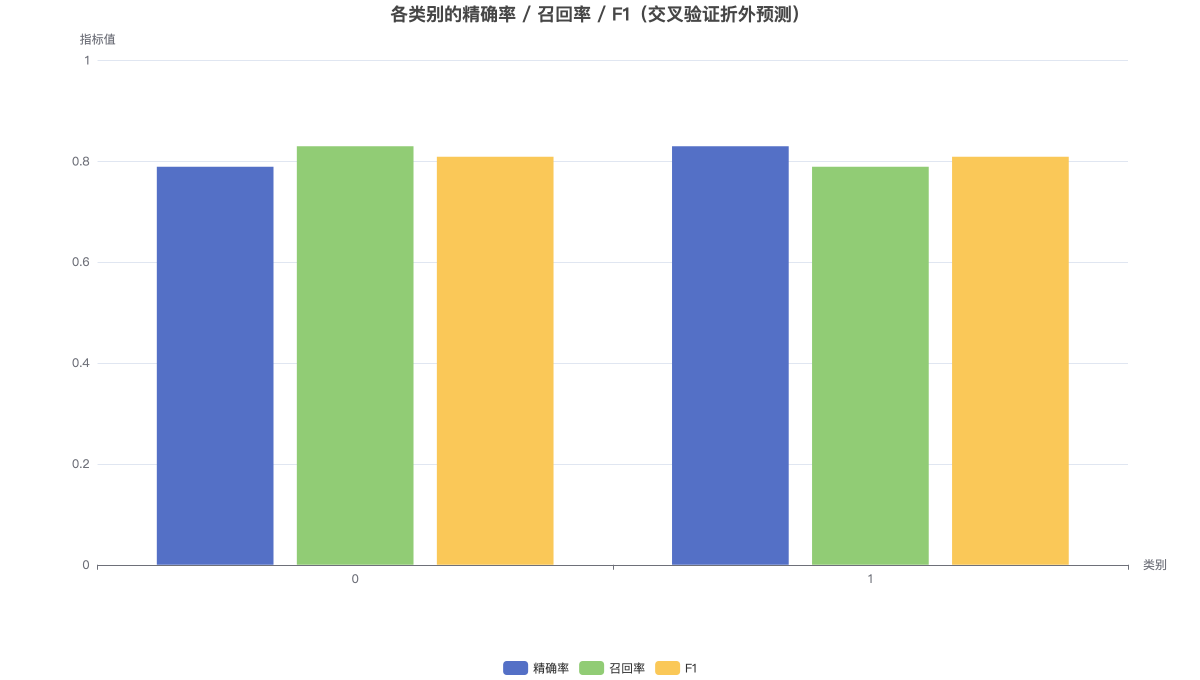
卡③ 全部基于交叉验证折外预测绘制:混淆矩阵与曲线所用的预测都来自模型未见过该样本的那一折,不是训练集回代结果。