
NRI/IDI 重分类改善
这个方法是做什么的
它评价的不是一个模型,而是两个模型之间的差:在同一批受试者上,新模型相对旧模型带来了多少增量。IDI(综合判别改善)是两个模型“判别斜率”之差,判别斜率 = 事件组的平均预测概率 − 非事件组的平均预测概率;连续 NRI(净重分类改善)则统计有多少事件者的预测风险被调高、多少非事件者被调低,两者相加。这两个数离开“旧模型”就没有意义,单独一个模型不适用本方法。
报告把增量放进“判别 + 校准 + 重分类”的完整框架里对照:第二张卡给 IDI、连续 NRI 及其分事件组/非事件组的分量,置信区间与 p 值由 1000 次固定种子的 bootstrap 给出;第四张卡再补上分类 NRI(按旧模型概率的三分位切风险层)、DeLong 检验的 ΔAUC,以及两个模型的 Brier 分数。第一张卡的校准诊断是这份报告特有的着眼点:示例旧模型校准斜率 0.6042、Hosmer-Lemeshow p=0.002 已提示校准不良,新模型分别是 0.9035 与 0.456——IDI 直接吃概率的绝对水平,两个模型校准差这么多时,必须把这一行读进去。
需要准备什么数据
- 放入[二分类]结局变量:不限
- 放入[定量]旧模型预测概率:不限
- 放入[定量]新模型预测概率:不限
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[二分类]结局变量」必须正好是 2 个类别。
- 「放入[二分类]结局变量」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 在已有风险评分之上再加一个新生物标志物,评估它值不值得加
- 比较院内旧版预测模型与新版模型的增量价值
- 论文里除了 ΔAUC,审稿人还要求补报 NRI 与 IDI
- 想知道改善究竟来自“把高危者识别出来”还是“把低危者放心排除”——分事件组与非事件组的两个分量正是回答这个
三列必须来自同一批受试者、逐行一一对应:任一列缺失即整行剔除。两列都必须是取值落在 0~1 的预测概率,不是原始评分(超出区间端点直接拒绝)。结局恰好两类,事件与非事件各至少 10 例。第一张卡还会给出两列概率的相关系数(示例 Pearson r=0.698)——两个模型高度相关时 bootstrap 区间会明显收窄,此时“统计显著”离“临床上值得换模型”还很远。
什么时候不要用它
- 手上只有一个模型或一个评分:没有比较对象,增量指标无从谈起,用「ROC曲线分析」评价它自身的判别力。
- 两列是原始评分、风险分或线性预测值,不是 0~1 的概率:端点会拒绝。先用「逻辑回归」把自变量拟合成预测概率,再把两个模型的概率列拿到这里。
- 你想问的是“模型说的 30% 是不是真的 30%”:那是校准而不是重分类,用「校准曲线」。
- 你想问的是“按这个模型决策,临床上净赚多少”:NRI/IDI 不含代价权衡,用「决策曲线分析(DCA)」。
- 两个模型的预测来自两批不同的人:配对前提不成立,重分类无从定义;只能各自单独评价,用「ROC曲线分析」。
- 结局是“多久发生”并且存在删失:用「Cox比例风险回归」。
容易误读的地方
- 连续 NRI 只看概率变动的方向、完全不看幅度,把所有人的概率整体抬高一点点就能把事件组分量顶到 +1.0。 实测构造“新模型 = 旧模型 + 0.02”:两个模型的判别斜率都是 0.1877、IDI=0.0000、ΔAUC=0.0000,判别力一分没涨;可 NRI-事件组 = 1.0000、NRI-非事件组 = −1.0000,因为每个人的概率都“上调”了。合计恰好为 0 纯粹是两个分量精确抵消。只摘“事件组 NRI 高达 1.0”写进结论,是这个指标最容易被滥用的方式——同一次实测里 Brier 反而从 0.2241 变差成 0.2258。
- 分类 NRI 的风险层切点是数据驱动的,谁被放在“旧模型”那个区决定了整套切点。 表注写明切点取旧模型预测概率的三分位数(示例 0.3661 与 0.6944)。实测把新旧两列对调:IDI 与连续 NRI 精确变号(0.0828 → −0.0828),而分类 NRI 从 +0.1991 变成 −0.1791,切点也换成了 0.3486 / 0.6779——它并不是简单取负。研究领域若已有公认的临床风险分层阈值,应改用那套阈值重算,并在方法学部分交代切点来源。
- NRI、IDI、ΔAUC 三个数结论不一致是常态,不是算错。 它们问的是不同的事:NRI 只看方向,IDI 依赖概率的绝对尺度,ΔAUC 只看排序。示例三者同向(IDI=0.0828、连续 NRI=0.3450、ΔAUC=0.0831)算是幸运情形。冲突时应由研究问题决定主指标,其余作为敏感性分析一并报告,而不是挑一个显著的报。
- p 值不会小于 0.0020,那是 bootstrap 的分辨率下限而不是真实的 p。 表注写明双侧 bootstrap ASL 的下限约为 2/(B+1)=0.0020(B=1000 次)。看到 0.0020 只能理解成“1000 次重抽样里没有出现更极端的情形”,写成“p<0.001”是不成立的。
- 增量指标不能替代“这个模型能不能用”的判断。 两个都很差的模型之间照样可以有显著的 IDI。而且本模块把两列概率当作外生已知量,bootstrap 没有在每个重抽样样本里重新拟合模型——如果概率来自同一批数据的拟合结果,所有增量都会偏乐观,结论须在独立队列里复核。方法学文献也一再指出,原模型校准良好时,纯噪声变量也可能得到正的 NRI。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:NRI/IDI 指标(主结果表)
- 输出结果三:重分类与判别可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
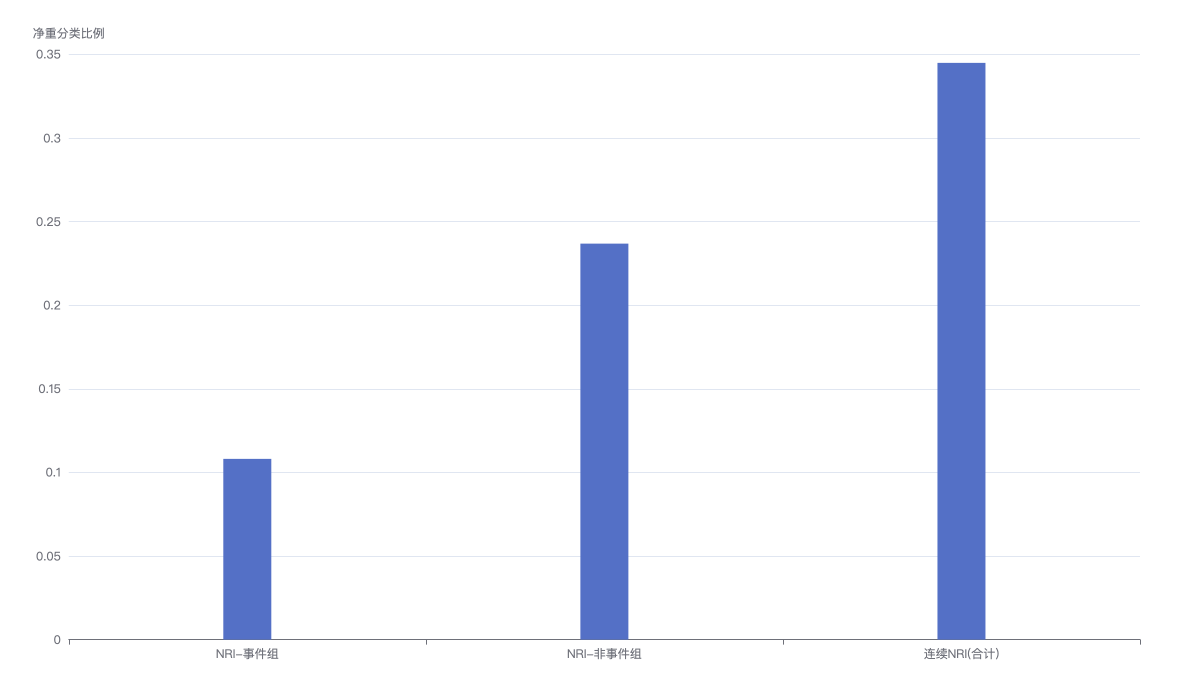
正值(蓝)=重分类改善方向,负值(红)=恶化;NRI>0 说明新模型重分类能力提升。
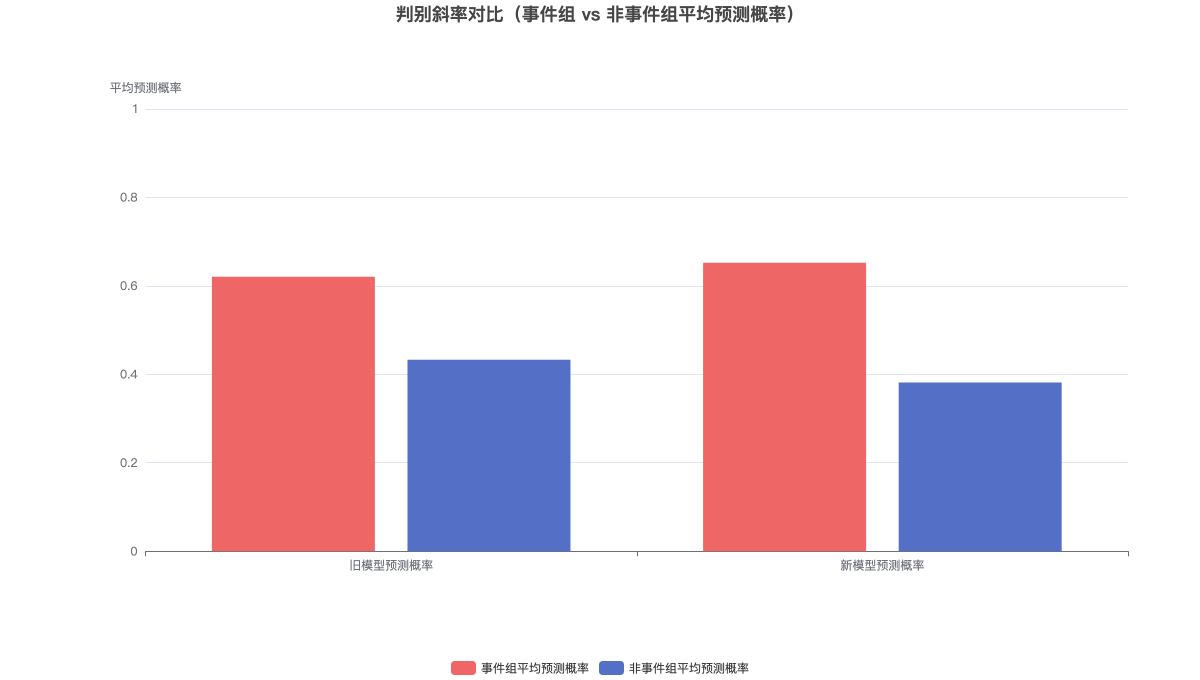
两根柱子的高度差即该模型的判别斜率;两个模型判别斜率之差就是 IDI。