
词频统计
这个方法是做什么的
把一列自由文本(每行一条,如评论、工单、问卷开放题)切成词,统计每个词出现了多少次。它先用 jieba 精确模式分词,再依次剔除纯标点与纯数字、词长小于设定值(默认 2)的词、以及一份内置的中文停用词表,剩下的词按频次降序排出前 N 名,同时给出占比、累计占比与文档频率——出现该词的文本条数及其占比。
它不设原假设,因而没有 p 值。第四张卡本该放效应量的位置换成了一组分布特征:log 频次对 log 排名的最小二乘斜率 b 与 R²(Zipf 结构)、Top10/20/50 覆盖度、类符与形符之比 TTR、Guiraud's R、归一化熵与 HHI。第一张卡把预处理的每一步剔除量逐行摆了出来——切分出多少词次、标点数字剔了多少、短词剔了多少、停用词剔了多少、最终保留率是多少——这几行是判断榜单可不可信的第一道依据。
需要准备什么数据
- 放入[文本]待分析文本列:不限
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 90%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 开放题、评论、工单文本拿到手后的第一步:看清用户在反复说哪些词
- 给后续的人工编码框架找线索:哪些词值得单独立一个类别
- 构建领域停用词表或领域词表前的摸底(Top50 覆盖度很高且多为虚词,就说明该扩表)
- 论文或汇报里需要一张高频词表、一张词云
前提是这一列必须是自然语言文本,且每行是一条独立文本。纯数字列会被直接拒绝;但编码列(如 A1/B2)与选项标签列(如"非常满意")不会被拒绝,它们会安安静静产出一张看起来很正常的词频榜——这一步没有自动检查,只能你自己看住。文本行越多、平均越长,Zipf 斜率与 TTR 这类分布特征越稳定。
什么时候不要用它
- 你想找的是"有区分度的词"而不是"出现最多的词":高频词往往正是所有文本都在说的通用词,用「TF-IDF关键词提取」,但要看的是它第二张卡的 IDF 与"单篇最大 TF-IDF"两列。它的主榜按全语料平均权重排,实测与文档频率的相关高达 +0.98,前几名和这里的高频榜基本重合,换过去并不会自动得到一张更有分辨力的榜单。
- 你想把文本聚合到几个潜在主题上:词频只给一张平铺的词表、不做任何聚合,用「LDA主题模型」。
- 你想知道这些文本是好评还是差评:词频不带情感方向,"不推荐"分词后"推荐"照样计入高频,用「情感分析」。
- 这一列其实是分类选项或多选题的选项标签:对它分词没有意义,用「频数分析」;多选题用「多选分析」。
- 你要比较两组人的用词差异:本模块一次只吃一列、也不分组。可行的做法是按组各跑一次,再把关心的词是否出现编成 0/1 变量,用「卡方检验」比较两组的出现率。
容易误读的地方
- 换一套分词器或停用词表,高频词榜就会变——这是本模块结论最不稳的一环。 它用的是 jieba 的默认词典与一份一百二十余词的内置停用词表,两者都不能在界面上改。默认词典不认识的领域词会被切碎:示例语料里"响应速度"恰好被当成一个词,但换成自家的产品名、药品名、机构简称,多半会散成几个片段,各片段频次都不高,于是集体掉出榜单。看到榜单里冒出意料之外的碎片词,先怀疑分词,别急着解释。
- "最短词长"默认为 2,所有单字被整批丢掉。 示例那次实测就剔除了 401 个词次。中文里"好、贵、慢、卡、差"全是单字的核心评价词,按默认设置它们一个都进不了榜单。语料以短评为主时,把这个参数改成 1 再跑一遍对照——代价是没被停用词表覆盖的那些虚字也会一起涌进来。
- 频次高不等于重要,"文档频率"那一列才是分辨的依据。 一个词频次 40,可能是 40 条文本各说一次(普遍关切),也可能是两条长文里各念了 20 次(个别人反复强调)。第二张卡的文档频率就是拆开这件事的:出现该词的文本条数与占比。两个频次接近的词,文档频率差一倍,含义完全不同。
- TTR 会随语料变长而系统性下降,两份长度不同的语料不能直接比。 词汇丰富度 TTR = 类符/形符,分母随文本量线性增长而分子增长得越来越慢,所以 120 条评论的 TTR 天然低于 20 条,这不代表后者用词更丰富。要跨语料比较,看报告里一并给出的 Guiraud's R(类符除以形符数的平方根),或者把两份语料截到相同词次数再比。
- 第一张卡那几条"[通过]"是预处理体检,不是对结论的背书。 它检的只有三件事:有效文本够不够、平均每条保留了多少词、过滤强度是否适中(示例保留率 70.46%)。保留率正常只说明文本没被削没,既不说明分词切对了,也不说明这份停用词表适合你的领域。同理,Zipf 斜率偏离 −1(示例为 −0.400)是对这批语料"词频分布比自然语篇更平"的描述,不是"数据出错了"的警告。
报告里有什么
- 输出结果一:语料概览与预处理充分性检验
- 输出结果二:高频词统计表
- 输出结果三:词频可视化(条形图 / 词云)
- 输出结果四:词频分布特征(Zipf / 覆盖度 / 词汇丰富度)
- 输出结果五:结论与学术表述
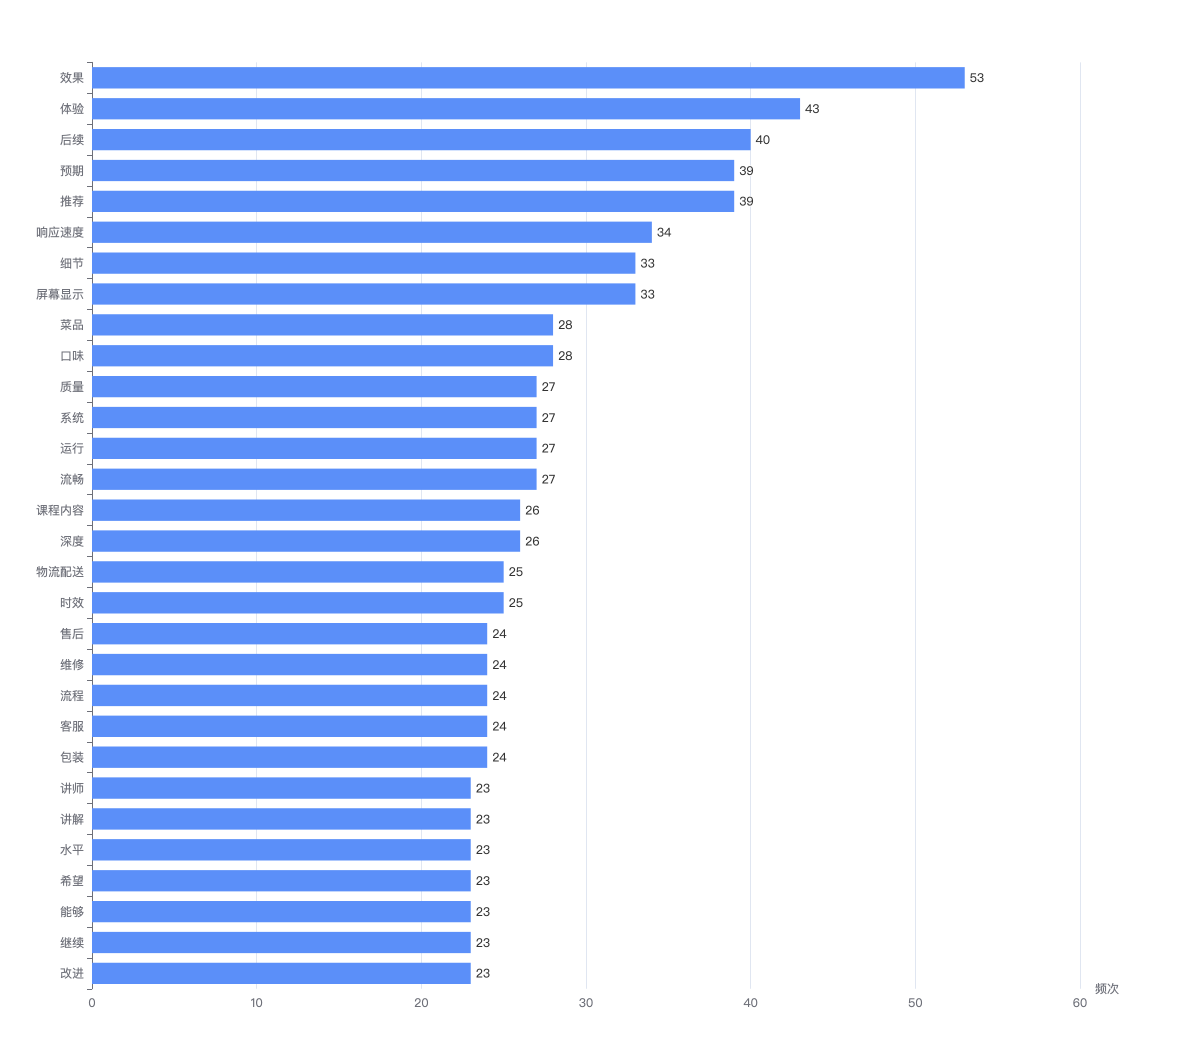
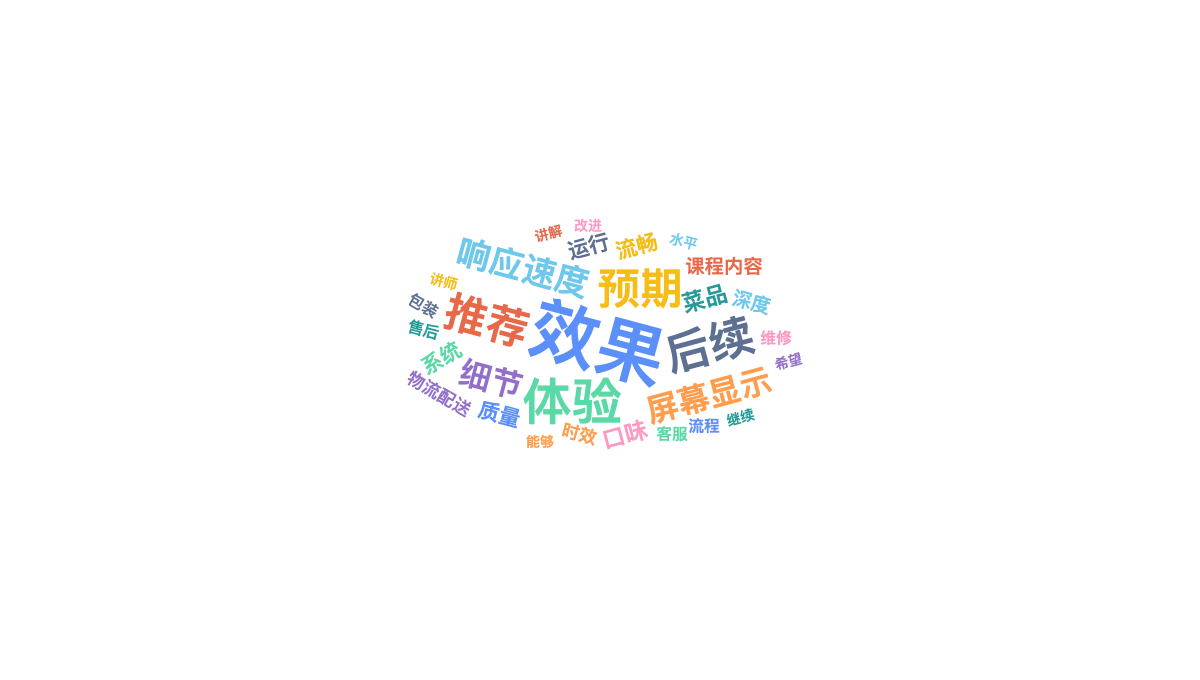
上为词频条形图(可用右上角切换器切到表格视图逐条读数),下为词云图;词云中词语字号与其频次成正比。