
计数数据回归
这个方法是做什么的
因变量是“数了多少次”——年度事故起数、月就诊次数、投诉件数这类非负整数时,用它而不是普通回归。系数 β 在对数尺度上,更好用的是 IRR = exp(β):自变量每增加 1 个单位,期望计数变为原来的 IRR 倍。模型选择是一个四选一的下拉框:泊松、负二项、零膨胀泊松(ZIP)、零膨胀负二项(ZINB)。
除了系数与 IRR,第一张卡先替你判“该选哪个模型”:因变量的均值、方差、方差-均值比 VMR、零值个数与泊松分布下的期望零值个数,加上 O 检验(离散指数检验)与自变量的 VIF。第四张卡给模型层面的效应量(McFadden 与调整 McFadden 伪 R²、Cragg-Uhler 伪 R²、Pearson χ²/df 离散比、AIC/BIC、对数似然)和变量层面的效应量(逐自变量的 IRR、95%CI 与“期望计数变化”百分比)。第三张卡除系数森林图外还有一张预测校准图,把样本按预测计数等分后对比每组的平均预测值与平均观测值——这是本模块特有的着眼点:结论文案点明它是模型无关的诊断、不依赖分布假设,所以四个候选模型跑完之后可以拿这张图(连同 AIC/BIC)横向比拟合,而不是各看各的伪 R²。选了零膨胀族时,第二张卡会多出一张 Vuong 非嵌套比较表。
需要准备什么数据
- 放入因变量 (Y) [定量]:定量变量(数值)
- 放入自变量 (X) [定量]:至少 1 个,定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 结局是事件发生次数,取值为 0、1、2、… 的非负整数
- 想要一个能直接说“变为原来 1.36 倍”的效应量(IRR),而不是对数尺度的系数
- 零值不算少,需要先判断是普通过度离散还是零膨胀
- 想在同一份数据上比较泊松 / 负二项 / 零膨胀哪个设定更站得住
前提是因变量真的是非负整数——出现负数或小数会被直接拒绝;自变量必须是定量列、不能是常数列、彼此不能完全共线。最大似然是大样本方法,样本量太小时 Wald 检验与置信区间都不可靠,具体行数下限见下方“数据要求”。
什么时候不要用它
- 因变量是连续量(金额、浓度、评分):用「线性回归 (最小二乘法)」。
- 因变量是“是 / 否”:用「逻辑回归」;是等级(轻 / 中 / 重)用「有序逻辑回归」。
- 只想检验一列计数是否服从泊松分布,不带自变量:用「泊松分布检验」。
- 零值很多,且要说清“什么样的人属于结构零”:用「零膨胀计数回归(ZIP/ZINB)」——它把自变量同时放进计数部分与零膨胀部分,拆成两张独立的系数表(分别带 IRR 与 OR 及各自的 95%CI),另给四个候选计数模型的横向比较表和对总体期望计数 E[Y] 的平均边际效应。本模块的零膨胀部分只有一个截距(见下方“容易误读的地方”)。
- 观测按组嵌套或同一对象重复测量:独立性前提不成立,用「广义线性混合模型(GLMM)」(要组内效应)或「广义估计方程(GEE)」(要总体平均效应)。
- 因变量是正的连续偏态量(住院费用、理赔金额):那不是计数,用「Gamma 回归」。
容易误读的地方
- 第一张卡的 O 检验与第四张卡的 Pearson χ²/df 回答的不是同一个问题,两者打架很常见。 实测同一份数据:O 检验 = 3.840、p < 0.001,判定列写“存在显著过度离散……建议改用负二项或零膨胀模型”;而拟合泊松之后 Pearson χ²/df = 1.0423,结论文案写“该值接近 1,条件散度设定合适”。表注解释了原因:O 检验只用到因变量本身的均值与方差、不考虑自变量,χ²/df 看的是控制自变量之后的残余散度。协变量把那部分离散解释掉了,此时该听第四张卡的。
- 换到零膨胀族之后系数表变了结构,别照抄成 IRR。 实测选零膨胀泊松:第二张卡的表标题变成“计数部分 + 零膨胀 logit 部分”,IRR 列被撤掉,以 inflate_ 开头的行属于 logit 部分。更要紧的是:本模块的零膨胀方程只含一个截距——实测 logit 部分只出现 inflate_常数 一行(−14.170,标准误 119.310,p = 0.905,第四张卡随之报“估计参数 5 个”=计数部分 4 个加这一个截距),自变量并不进入零膨胀方程,所以这份报告答不了“哪些因素让一个人属于结构零”。第四张卡的表注还写明“零膨胀 logit 部分的系数不作指数化解读为 IRR”,那里的 IRR 只针对计数部分。
- Vuong 检验判“不需要零膨胀”是很常见的结果,而且它是单尾的。 实测 Vuong Z = −0.240、p(单尾)= 0.595,结论“两模型拟合无显著差异,按简约原则可用标准计数模型”。表注给了读法:Z 显著为正支持零膨胀模型,显著为负支持标准模型,不显著则两者无差异。零值多不等于零膨胀——同一份数据实测零值 15 个、泊松期望零值 12.2 个,第一张卡判“暂无明显零膨胀迹象”。
- 换模型往往不换结论,只换拟合指标;别把“模型更复杂”当成“模型更好”。 实测三个能跑通的分支里,三个自变量的 IRR 几乎不动(都是 1.3643 / 1.0435 / 0.9808),变的是 AIC:泊松 1174.303、负二项 1176.301、零膨胀泊松 1176.303——最简单的泊松反而最小。McFadden 伪 R² 也从泊松的 0.0692 掉到负二项的 0.0604(零膨胀泊松 0.0687)。挑模型要同时看 AIC/BIC 与 Vuong,不能只凭伪 R²,而伪 R² 本身也不能按线性回归 R² 的尺度读(表注:0.2~0.4 已属拟合良好)。
- 不是每个选项都保证跑得出来。 实测同一份数据选零膨胀负二项时接口直接返回错误“拟合零膨胀负二项回归时出错: 模型未能收敛,请检查数据或尝试其他模型。”,没有报告可看。零膨胀族要在计数方程之外再估一套 logit 参数,似然面比泊松、负二项复杂得多,样本不够大或自变量量纲差异悬殊时很容易停在不收敛上——这时应先做变量标准化,或退回负二项。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:模型主结果
- 输出结果三:模型可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
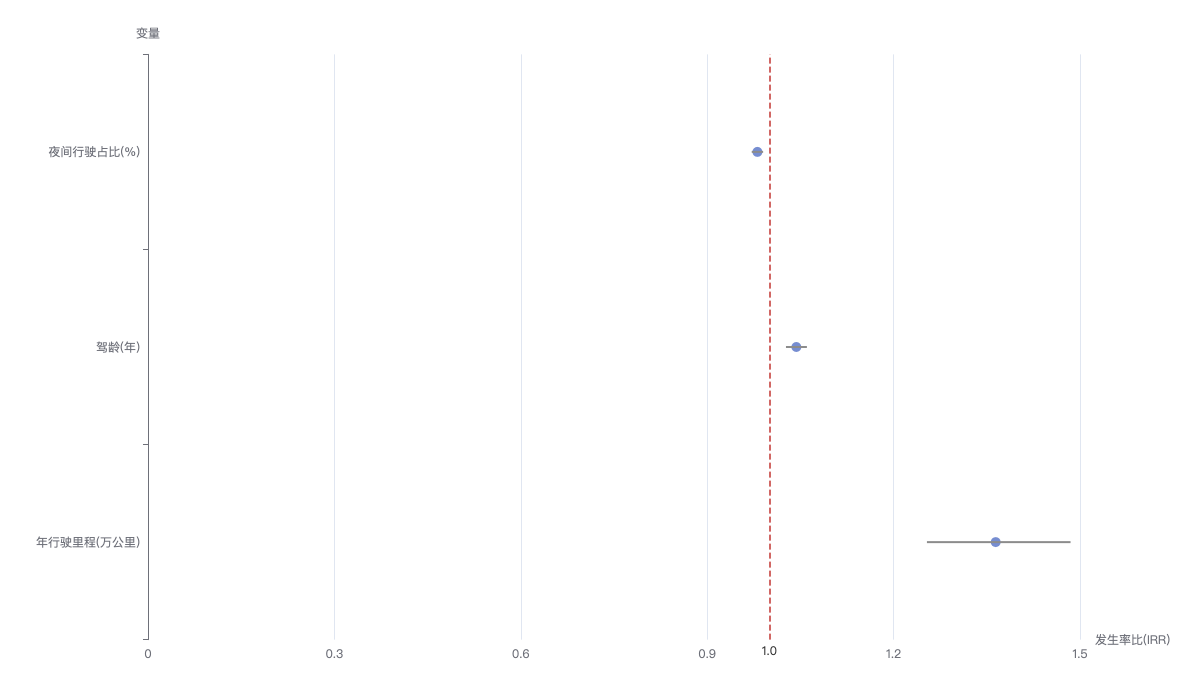
读图:圆点为各自变量的发生率比 IRR = exp(β),横向须为其 95% 置信区间,红色虚线为 IRR = 1 的无效参考线。须跨越参考线(区间含 1)表示该变量对计数无显著影响(灰点),完全落在参考线一侧表示显著(蓝点)。为避免截距量级过大压扁图形,已略去截距。
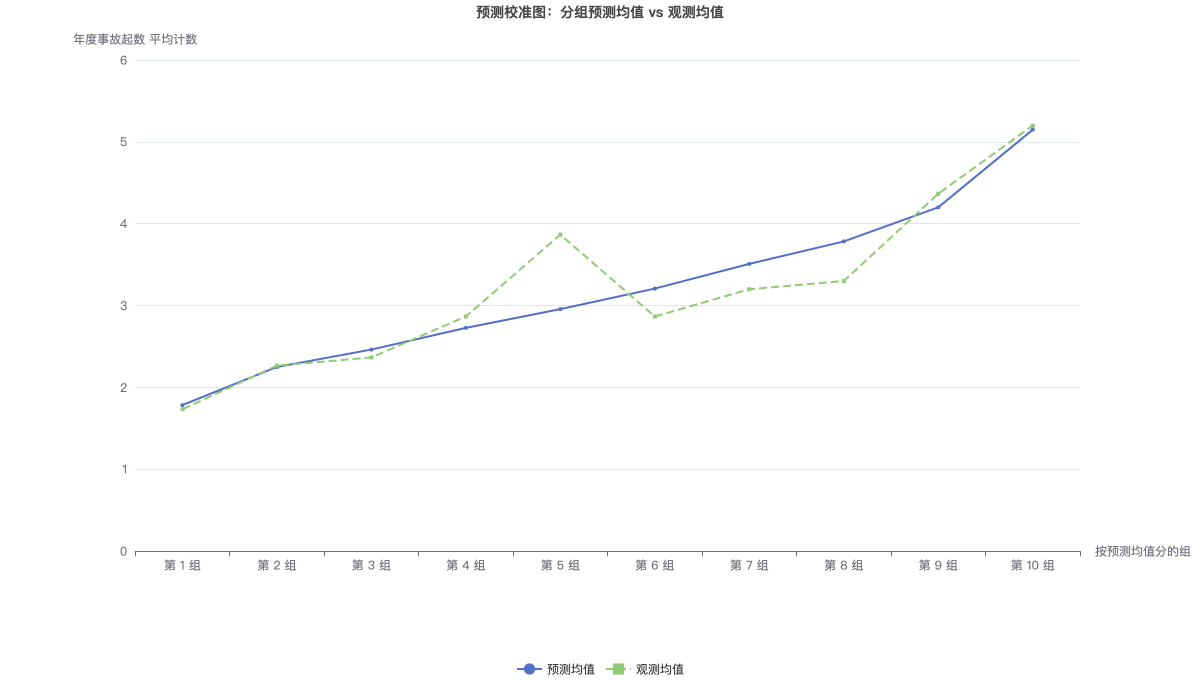
校准图把样本按模型预测的期望计数从低到高等分成若干组,对比每组的「平均预测计数」与「平均观测计数」。两条线越贴近,模型对计数水平的刻画越准确。