
安慰剂检验(Placebo)
这个方法是做什么的
它不估计任何新的效应,它做的是证伪:保持时期结构与控制变量不变,只把“谁是处理组”这个标签在个体层面随机重排,每重排一次就重跑一遍双重差分,默认 500 次,于是得到 500 个本不该存在的“伪 ATT”。真实 ATT 如果落在这堆伪估计的尾部,就说明同等大小的效应很难由随机的分组划分产生;如果落在中间,那么你的效应与随机噪声就分不开。随机种子固定为 42,同一份数据重跑结果可复现。
报告把两套推断并排放在一张表里:真实 ATT 的解析推断(HC1 异方差稳健标准误加 t 分布)与随机化推断的经验 p 值,另给零分布的均值、标准差、经验 95% 临界区间和真实 ATT 所处的百分位;卡③ 画伪 ATT 直方图与伪回归自身的 p 值分布图;卡④ 除随机化 z 值外,还做一项少见但重要的诊断——把每次置换回归自己的 p 值当成一次“原假设为真时的检验”,统计其中 p<0.05 的比例,再用精确二项检验与名义水平 5% 比较,等于给你当前这套 DID 设定量了一次假阳性率。
需要准备什么数据
- 放入[定量]因变量 Y:1 个,定量变量(数值)
- 放入[定类]分组变量 Treat:1 个,定类变量(分组/标签)
- 放入[定量]时间变量 Time:1 个,定量变量(数值)
- 放入[定类]个体ID (可选)(可选):不限
- 放入控制变量 (可选)(可选):不限
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]分组变量 Treat」必须正好是 2 个类别。
- 「放入[定类]分组变量 Treat」的每一组至少 4 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 已经用双重差分得到一个显著的净效应,需要回应“会不会只是碰巧分组分出来的”
- 个体数不多、序列相关明显,担心解析标准误的分布假设撑不住
- 审稿人点名要求随机化推断或置换检验
- 想顺带体检一下当前 DID 设定本身是不是容易制造显著(卡④ 的假阳性率诊断)
分组变量必须是 0/1,时间变量至少两个取值。强烈建议提供个体 ID:置换必须发生在处理被分配的那一层级。置换次数默认 500、可填 50 到 2000,填得更大会被夹到 2000,报告会把你填的值和实际执行的次数都写出来。
什么时候不要用它
- 还没估出效应,只是想做双重差分:先用「双重差分(DID)」跑主结果,它卡④ 本来就自带一行把事件时点前移的安慰剂检验;本模块是在主结果之后追加的稳健性证据。
- 想检验的是平行趋势而不是随机性:这是两件事。卡① 的结论文案讲得很清楚,安慰剂检验回答的是效应会不会由随机分组偶然产生,它不能替代平行趋势检验。要检验平行趋势,用「双重差分(DID)」的事件研究法事前联合检验。
- 想做的是“换控制变量、换子样本、换滞后期再跑一遍”:那是多设定复核不是随机化推断,用「稳健性检验」,它会在多个变体下重复估计并汇总。
- 数据是前后各一期、两组基线差得多:先把主模型建对,用「PSM-DID」,它自带 300 次分时期随机重排处理标签的安慰剂检验。
- 只有一期截面、没有时间维度:置换双重差分无从谈起,回到「倾向得分匹配 (PSM)」,用共同支撑与均衡性来支撑可比性。
容易误读的地方
- 通过安慰剂检验,不等于因果识别成立,只等于这一条没被证伪。 卡④ 的结论文案写明:它只检验效应是否可能由随机分组产生,无法排除遗漏变量、同期政策冲击等与处理状态系统相关的混杂。卡⑤ 的方法边界还补了一句更狠的——拒绝原假设只说明存在某种效应,不等于这个效应就是你声称的那个政策效应。把“安慰剂检验通过”写成“因果关系成立”,是这一族里最常见的越界。
- 经验 p = 0.0020 是地板,不是一个精确的 p 值。 表注写明经验 p 值含 +1 连续性修正,最小可能取值就是 1/(N+1)。演示数据 500 次置换里 0 次达到真实 ATT,于是 p 被写成 0.0020——它的含义是“比 1/501 还小”,同一份数据跑 2000 次会写成 0.0005。拿它去和别人报告里的 p 值比大小、或者写成“p 恰为 0.002”,都是误读。想要更细的分辨力,就把置换次数调大。
- 不给个体 ID,置换层级会退化,模块会明说但不会拦你。 实测同一份数据去掉个体 ID:卡① 的置换层级由“个体层面,按企业编号整体重贴标签”、判定“正确”,变成“行层面”、判定“退化”,卡④ 的假阳性率也由 2.8% 变成 6.8%。逐行置换会把同一个体的多期观测打散,构造出一个现实中不可能出现的分配方式。面板数据一定要把 ID 拖进来。
- 假阳性率诊断体检的是你的 DID 设定,不是你的政策效应。 演示数据里 500 次置换有 14 次(2.8%)的伪回归自己达到了 p<0.05,精确二项检验 p=0.023,判定为显著低于名义水平、推断偏保守——这句话说的是这套 HC1 加 t 分布的推断偏保守、真实效应的显著性可能被低估,不是“你的结论更可靠”。反过来若这个比例明显高于 5%,说明当前设定容易制造显著(常见原因是序列相关或聚类结构未处理),真实结果的显著性就要打折扣。
- 这里的解析标准误是 HC1,即使你提供了个体 ID 也不做聚类。 主结果表的口径说明写的就是 HC1 异方差稳健标准误加 t 分布,个体 ID 只用来决定置换层级。所以本模块的解析 95%CI 不能直接当成主结果引用:要用聚类稳健标准误,回「双重差分(DID)」跑一遍,那里提供个体 ID 就会按个体聚类,并把聚类数一并印出来。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(真实 ATT 与随机化推断)
- 输出结果三:可视化(零分布与假阳性率)
- 输出结果四:效应量与事后分析(随机化推断·假阳性率诊断)
- 输出结果五:结论与学术表述
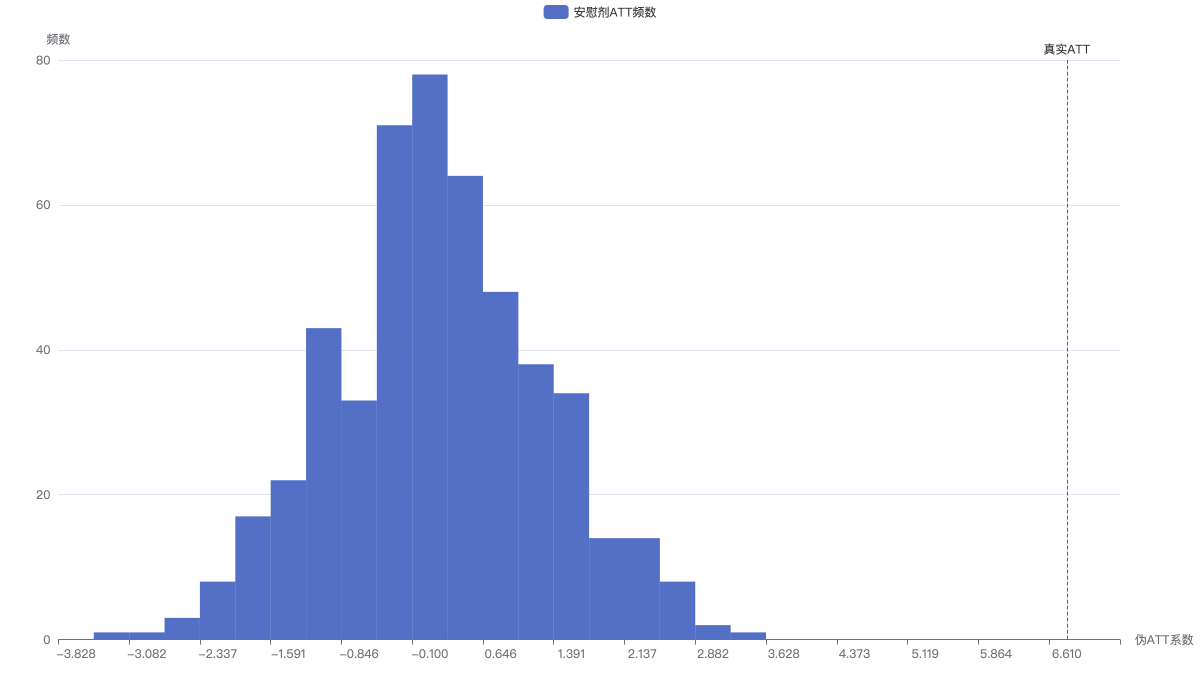
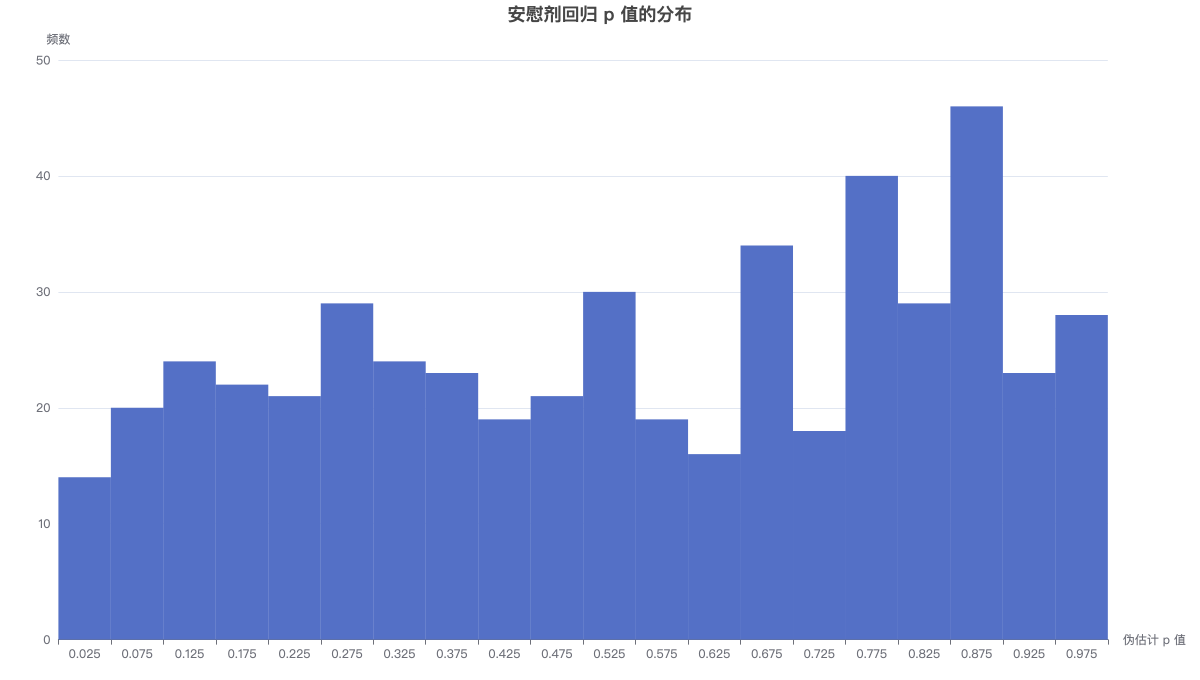
上图为 500 次随机置换处理组标签得到的「伪 ATT」分布直方图,红色虚线标记真实 ATT(6.661);下图为这些伪回归自身 p 值的分布。