
单率Meta
这个方法是做什么的
把多项研究各自报告的单组发生率合并成一个总的率估计。只要两列:事件数与总数(研究标签可选),一行是一项研究,不是一个受试者。没有对照组,也没有效应量选择器:每个研究的率先经 logit 变换 z = ln(p/(1−p)) 转到近似正态的尺度上加权平均,再反变换回率展示,因此所有区间端点都自动落在 (0, 1) 内。
这里有一件和本族其他模块都不同的事:单率没有“无效值”这个参照。OR 有 1、均值差和相关系数有 0,率没有。所以主结果表里那个 Z 与 p 检验的其实是“logit 尺度上的合并值是否为 0”,也就是“率是不是等于 50%”,表注与卡2 的结论文案都明确写着它不作为主要结论;森林图的灰色虚线也只画在合并率的位置作视觉对照,不是无效线。除此之外的输出与本族一致:第一张卡给各研究的率、95%CI、两套权重与异质性诊断(Q、I² 及其 95%CI、τ²/τ、H²),第二张卡给固定效应与随机效应合并结果加一行 95% 预测区间,第三张卡是森林图与漏斗图,第四张卡做留一法与四项发表偏倚诊断,第五张卡整理成可誊写的学术表述。
需要准备什么数据
- 研究标签 (可选)(可选):不限
- 事件数:不限
- 总数:不限
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 多项研究报告了同一疾病的患病率、检出率、并发症发生率或阳性率
- 多项研究报告了同一干预的不良反应发生率、有效率或失访率
- 系统评价需要一个合并的发生率以及它的区间,并要报告异质性
- 想知道各研究之间的率差异有多大、合并值会不会被某一项研究带着走
数据上的前提:事件数与总数都是非负整数,事件数不超过总数,总数为正,至少 3 项研究。更要紧的前提在数据之外——各研究必须测量同一个结局、来自可比的目标人群,否则把一堆率平均出来的数字没有指代对象。
什么时候不要用它
- 有对照组,要比较两组的率:用「二分类效应Meta(OR/RR/RD)」,它会替你算 OR/RR/RD 并处理零格校正。
- 只有一项研究,想给单个率一个置信区间或与某个理论值比较:那不是 Meta 分析,用「二项式检验」。
- 各研究只报了率与它的 95%CI,拿不到事件数与总数:先把率与区间换算成 logit 尺度上的估计与标准误,再用「通用效应量Meta(亚组/回归)」。
- 想按地区、年份或诊断标准做亚组分析或 Meta 回归:本模块没有这两个拖拽区,用「通用效应量Meta(亚组/回归)」。
- 结局是人时发生率(每千人年这类发病密度):事件数与总数的结构填不进去,先算好 ln(率) 与其标准误,再用「通用效应量Meta(亚组/回归)」。
- 要合并的是连续结局的均值而不是率:用「连续效应Meta(MD/SMD)」。
容易误读的地方
- 主结果表里那个 p < 0.001,不是“这个率显著”。 它检验的是 logit 尺度上的合并值是否为 0,翻译过来就是“合并率是否等于 50%”。本次它说的是“31.86% 显著地不等于 50%”——这句话对任何研究问题都没有用处。该报告的是合并估计本身:0.3186,95%CI [0.2789, 0.3612]。摘要、表注和卡2 的结论文案都已声明不做显著性判定,但这个星号还是最容易被顺手抄进论文的东西。同理,森林图上跨不跨那条灰色虚线,与显著性无关。
- 失安全数与留一法那列“结论不变”,在单率下几乎没有解释价值。 表5 的 Rosenthal 失安全数 N_fs = 1459.9,它的字面含义是“再补进约 1459 项率恰好为 50% 的研究,合并率才会不再显著异于 50%”——问题问错了,答案再大也没意义。留一法末列同样:表注已声明它在这里只当作“结果是否被单一研究左右”的稳健性信号。真正该读的是各行点估计的漂移幅度:本次全模型合并率 0.3186,逐一剔除后最低 0.3116(剔 Xu 2021)、最高 0.3322(剔 Li 2017),整张表的跨度是 2.06 个百分点,没有哪一项研究能把结果带走——这才是稳健的证据。
- τ 印在 logit 尺度上,别读成“各研究的率相差 0.30”。 本次 τ² = 0.09012、τ = 0.3002,这是对数几率的单位,0.30 大致相当于优势比差 1.35 倍;换算到率的尺度上它不是常数——logit 在中间陡、两端平,同样是 0.30,在率 50% 附近约合 7 个百分点,在率 5% 附近只合 1 个多百分点。至于 I² = 82.2%(95%CI [70.1%, 89.4%]),单率合并出现这个量级是常态而非异常:各研究的人群、诊断标准与年代本来就不同,真值本来就不一样。所以 I² 高在这里既不构成“必须换随机效应”的理由(该看的是你认不认为这些研究估的是同一个率),也不该靠剔掉几项研究把它压下去——那只是在挑数据。
- 要回答“换到我们这个人群大概是多少”,看的是预测区间,不是置信区间。 合并率 0.3186 的 95%CI 只有 [0.2789, 0.3612],很窄,因为它刻画的是“这 12 项研究背后那个平均率”估得有多准;而同一张表里的 95% 预测区间是 [0.1880, 0.4857],说的是再做一项同类研究、其真实率可能落在 18.8% 到 48.6% 之间。把置信区间当成新场景下的率区间来引用,是单率 Meta 最常见的越界,也是异质性高时后果最严重的一种。
- 事件数为 0 或等于总数的研究会被加 0.5,而这一步的影响取决于样本量。 极端率会让 logit 发散,模块按惯例给这类研究加 0.5 连续性校正,表注会明写本次校正了几项(本次所有研究的率都严格落在 0 与 1 之间,未做校正)。要留意的是:同样是“0 例事件”,n = 20 与 n = 2000 校正后得到的估计与权重差很多,率接近 0 或 1 的研究一多,合并结果就明显依赖这个人为常数。遇到这种数据,除了照常报告,最好把这些研究单独列出来,再用留一法看看去掉它们结论会不会变。
报告里有什么
- 输出结果一:纳入研究概览与异质性前提检验
- 输出结果二:合并效应主结果表
- 输出结果三:森林图与漏斗图
- 输出结果四:敏感性分析与发表偏倚检验
- 输出结果五:结论与学术表述
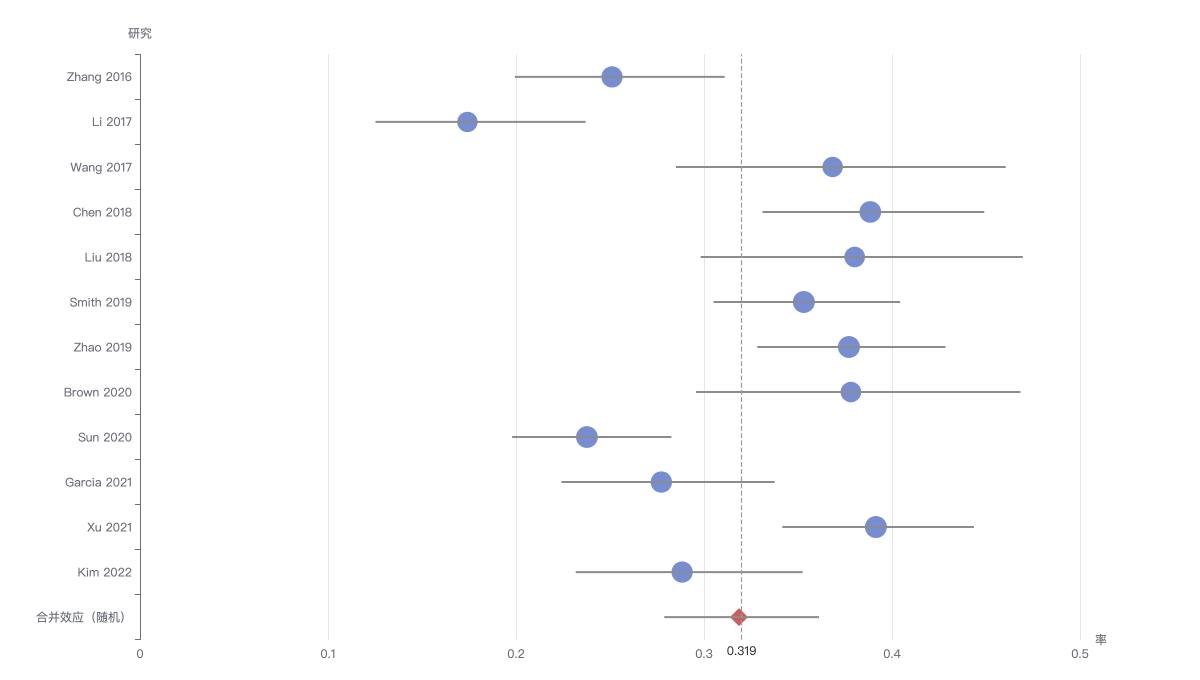
森林图在 率 的自然尺度上展示:每行一个研究,圆点为点估计(面积 ∝ 随机效应权重),横须为 95% 置信区间;底部红色菱形为随机效应合并效应及其区间;灰色虚线画在合并率位置作为对照参考(单率没有「无效值」,不能据虚线判断显著性)。
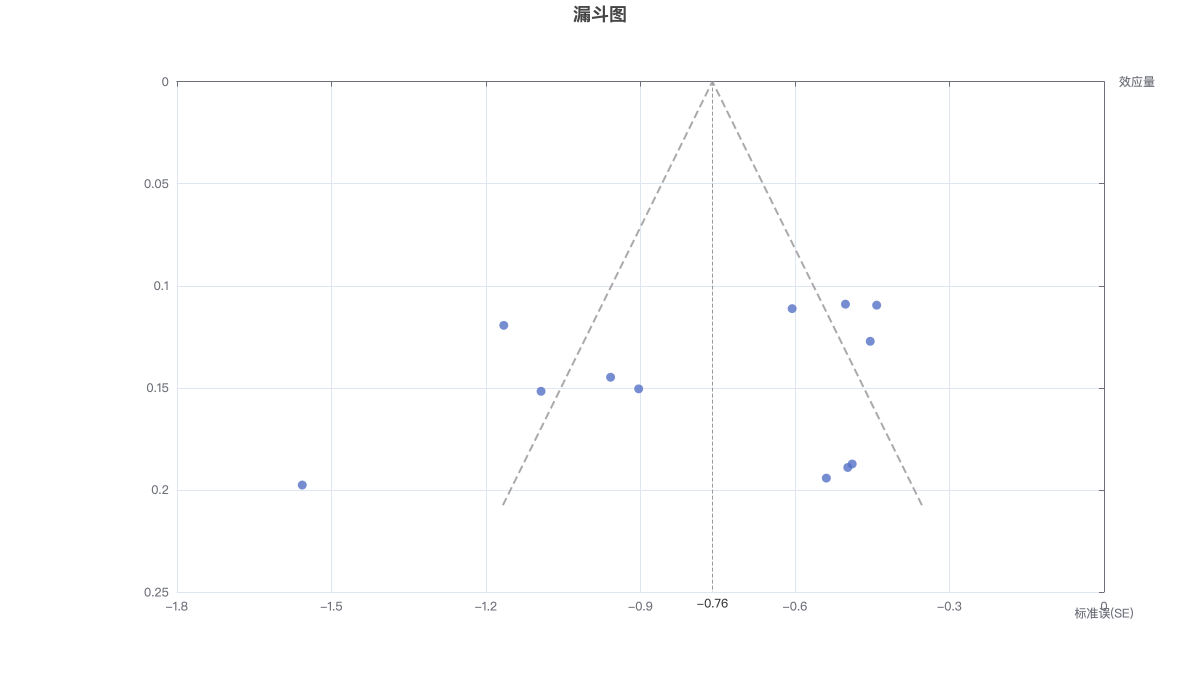
漏斗图横轴为各研究的效应量(分析尺度),纵轴为标准误(越靠上越精确);两条斜虚线为 95% 伪置信漏斗边界。若不存在小研究效应,散点应大致对称分布在漏斗内。