
游程检验
这个方法是做什么的
检验一列数据按当前行序排下来的排列是不是随机的。做法是以该列的中位数为分割点,把每个观测标成“≥中位数”或“<中位数”,再数连续同侧的片段(游程)有多少段。随机排列下游程数应当落在一个可以算出来的期望值附近:明显偏少意味着数据成段聚集或存在趋势,明显偏多意味着高频交替。它检验的是排列与独立性,不是分布形态。
卡②给出观测游程数 R、原假设下的期望 E(R)、SD(R)、Z、正态近似 p,以及由游程分布闭式概率求和得到的精确 p(N>600 时不算),还有 R 在原假设下的 95% 参考区间。卡④给效应量 r=|Z|/√N、游程比 R/E(R)、一阶自相关 ρ₁ 及其 95% 置信区间、最长游程与平均游程长度——这些回答的是“非随机到什么程度、以什么形式”。卡③是逐点的序列运行图,中位数画成一条水平线。可以一次拖多列,逐列分别检验。
需要准备什么数据
- 放入 [定量] 待检验序列:至少 1 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 生产线上按顺序抽检的读数,看过程有没有漂移或批次聚集
- 回归模型或时间序列模型的残差,看是否还残留系统性成分
- 质量抽样的先后记录,检查抽样是不是真的随机
- 一串号称随机生成的数,看有没有“人为凑随机”的过度交替痕迹
- 按答题顺序记录的作答数据,看有没有连续同答的倾向
唯一的实质前提是行序必须是真实的观测顺序(时间、生产、抽样顺序),这一条数据本身检验不了,只能由你保证。此外变量须是数值型且非常数列;正态近似要求二分后两侧各不少于 10 个,不满足时看卡②的精确 p 即可,不必换方法。
什么时候不要用它
- 想知道数据是不是正态分布:用「正态性分析」。这是本模块被误用得最多的方向。
- 想量化相邻观测的依赖有多强、滞后几期还有相关:用「(偏)自相关分析」,游程检验只给一个是非判断。
- 关心的是有没有单调的上升或下降趋势:用「Mann-Kendall趋势检验」,它对趋势的检验效能比游程检验高得多。
- 想找出序列在哪个时点发生了突变:用「突变点检测(Pettitt)」,游程检验不定位变点。
- 要监控一个生产过程是否受控并给出控制限:用「单值-移动极差(I-MR)控制图」或「X-bar/R 控制图」,游程规则本来就是控制图判异准则的一部分。
容易误读的地方
- 它检验随机性,不检验分布。 p 值不显著只说明这批数据的排列看不出系统性模式,与数据是不是正态、是不是偏态毫无关系;反过来,一列完美的正态数据只要按大小排过序,游程检验必然极显著。模块自己在卡①专门写了一句“本检验不检验分布形态”,正是因为这个误用太常见。要判断分布形态请用「正态性分析」。
- 行序不对,整份报告就作废,而且从数据里看不出来。 卡①的“观测顺序有意义”一列写的是“须由研究者确认”,因为这一条无法统计检验。表格在导入前若按某个字段排过序,游程数会人为地变得极少、检验必然显著,但那反映的是你的排序动作,不是过程本身。删除缺失行也有同样的性质:删掉之后前后两段被直接接上,原本被隔开的两个片段会连成一个游程,游程数凭空减少。
- 重复值多的列,中位数分割会失衡甚至退化。 实现约定是“≥中位数记为高侧”,所以恰好等于中位数的观测全部并入高侧。连续测量值里这类“结”很少,但李克特量表、计数、0/1 编码这类离散数据会有大量结,二分后两侧可能极不均衡,甚至一侧为空。一侧为空时模块不会报错,反而会给你一个看上去很硬的显著结论:实测按顺序放进 20 个 3 与 10 个 5(中位数 3.000,n₁=30、n₂=0、结 20),卡②主表出 z = -inf、p = 0.000,分解表给 R = 1、E(R) = 1.00、正态近似 p < 0.001,SD(R)、精确 p 与卡④的效应量 r 全是“-”,卡⑤仍然判“序列排列非随机”,那段“可直接誊入论文”的表述里还带着 Z = -inf、r = inf,并自相矛盾地写着“观测游程数多于期望,提示序列存在过度交替”。所以先看卡①:n₁ 或 n₂ 只要有一个是 0,这份报告的检验结论一律不可用,不要拿去写论文——该改分割点、改测量口径,或换别的方法。卡①单列的“结(=中位数)”与 n₁ / n₂ 三列,就是让你先看这个。
- 显著只说明“不随机”,没说是哪一种不随机。 游程偏少可能是趋势,也可能是批次聚集或正自相关;游程偏多则对应过度交替或负自相关。要区分得看卡④的游程比 R/E(R) 落在 1 的哪一侧、一阶自相关 ρ₁ 是什么符号,再配卡③的运行图。只写一句“p=0.002,序列非随机”,等于把最有用的信息全丢了。
- 样本量一大,极轻微的序列依赖也会显著。 判断要不要动模型,看的是 r 与 ρ₁ 的大小,不是星号。样例里“随机抽检读数”ρ₁=0.194、其 95% 区间跨过 0、r=0.075,与“工序连续读数”ρ₁=0.602、r=0.352 完全不是一回事;但若样本量再大几倍,前者也可能把 p 压到 0.05 以下,而它实际的依赖程度并没有变。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:游程检验主结果表
- 输出结果三:序列运行图
- 输出结果四:效应量与序列结构诊断
- 输出结果五:结论与学术表述
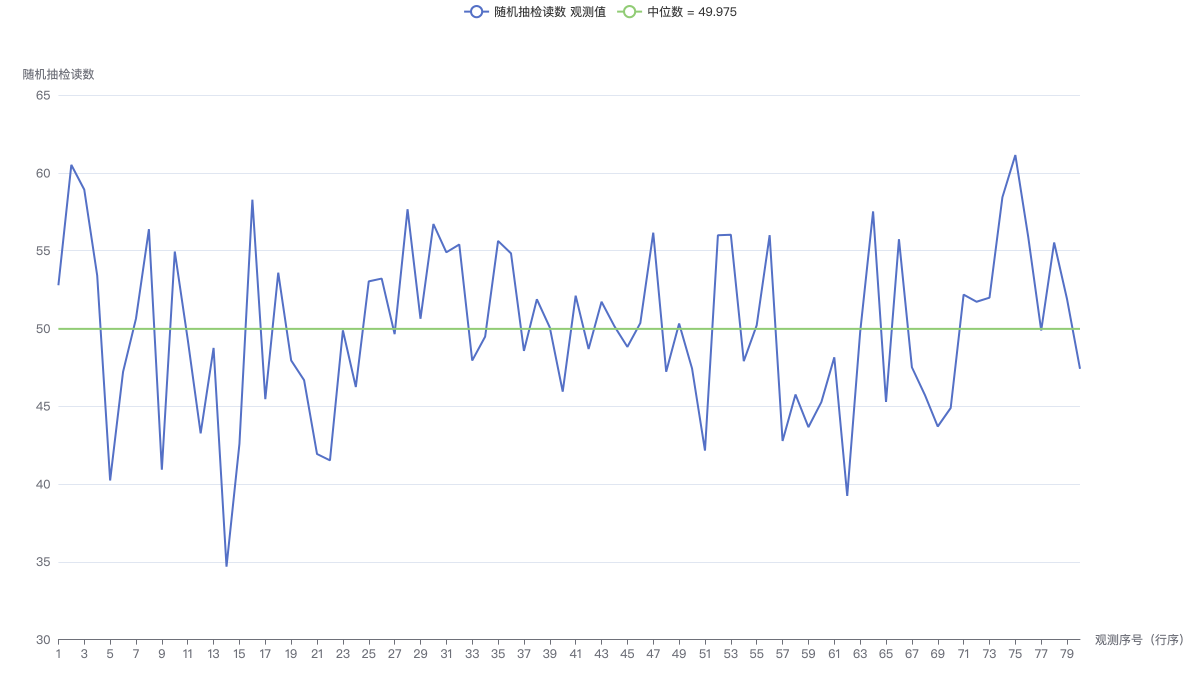
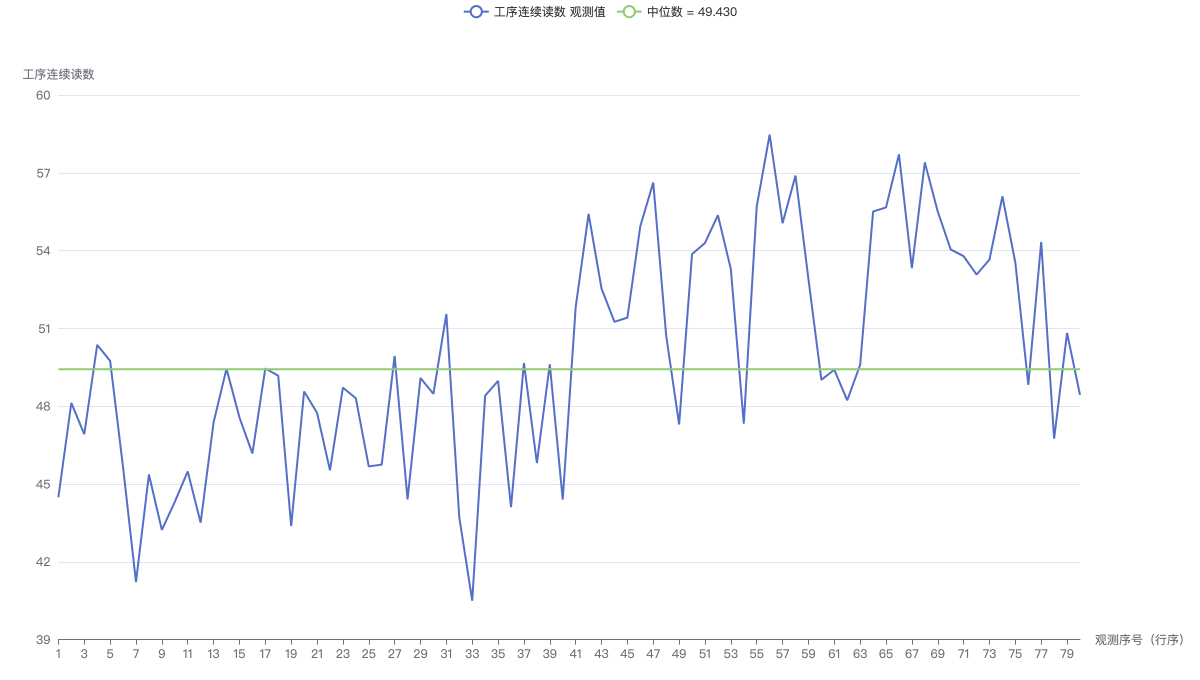
序列运行图按行序展示每个观测值,水平线为该变量的中位数(即游程检验的分割点)。折线在中位数线上下来回穿越的次数越少,说明同侧观测连成的片段(游程)越长、游程数越少,对应数据存在趋势或聚集;穿越过于频繁则对应高频交替。可用上方切换器切到表格查看逐点数值。