
限制性立方样条(RCS)
这个方法是做什么的
回答一个很具体的问题:某个连续暴露与结局的关系是不是一条直线。做法是在 X 的取值域上按分位数布置若干节点,每段用三次多项式拟合、在节点处连续可导,两端强制为直线(这就是“限制性”的含义),再把这组样条基放进回归模型。结局是二分类时走 Logistic、效应以 OR 报告;结局是连续变量时走线性回归、效应改报均值差。
它的核心产出是两个似然比检验:总体关联检验(样条模型 vs 只含协变量的空模型)问“X 与结局有没有关系”,非线性检验(样条模型 vs 只含线性项的模型)问“这关系是不是直线”——示例 χ²(3)=55.350、p<0.001 与 χ²(2)=2.935、p=0.231。样条模型没有单一的回归系数可报,所以第四张卡改用“若干关键分位点相对参考点的效应”来表达:参考点固定取 X 的中位数(示例 63.000),P5~P95 各给一个 OR 与 delta 法置信区间,另附曲线的最高/最低点与内部拐点个数、AIC/BIC 与线性模型的对比。
需要准备什么数据
- 放入结局变量Y:不限
- 放入[定量]预测因子X:不限
- 放入[定量]校正协变量 (可选)(可选):不限
数据要求
- 数据表至少 32 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 年龄、BMI、血压这类连续暴露与结局是否存在 U 型或 J 型关系
- 论文审稿要求“用样条验证线性假定”,或需要一张带置信带的剂量-反应曲线
- 建 Logistic 模型时 Box-Tidwell 提示某个连续自变量非线性,需要先看清它的形态
- 想知道风险在 X 的哪一段上升得最快
预测因子 X 必须是连续定量变量且取值数多于节点数;校正协变量区只吃定量列,而且拖错类型时的报错会指向别处:实测把一个文字分类列放进协变量区,整列被转成缺失,端点回的是“去除含缺失的整行后只剩 0 条”——看到这句先检查协变量的类型,不要去补样本。节点数可在 3~6 之间调,默认 4。有效样本量的门槛随节点数变化,作用在去掉含缺失整行之后的记录上,实测为 3 节点 30 条、4 节点 32 条、5 节点 40 条、6 节点 48 条——菜单上标的 32 只是默认配置的口径,调大节点数前先算一下手上够不够。二分类结局还要满足 EPV≥10,第一张卡给出实测值。
什么时候不要用它
- 预测因子本身是分类变量:样条对无序类别没有意义,直接把它做成哑变量放进「逻辑回归」或「线性回归 (最小二乘法)」。
- 你要的是一个能写进指南的切点(“超过多少就该干预”)而不是一条平滑曲线:样条给的拐点只是拟合曲线的形态描述,结局为连续变量时应改用能对切点做统计推断的「门槛回归(Hansen)」。
- 结局是“多久发生”且存在删失:本模块只接受连续或二分类结局,生存资料用「Cox比例风险回归」。
- 样本量达不到门槛(3 节点也要 30 条有效记录):样条比线性模型多估 k−2 个参数,样本不足时曲线会被少数几个点带偏,退回「线性回归 (最小二乘法)」或「逻辑回归」更诚实。
- 你要的是一个包含多个自变量的预测工具:本模块一次只对一个 X 做样条,其余只能作为线性协变量;要出个体化风险评分用「列线图(Nomogram)」。
- 只想描述两个连续变量的走向、不做协变量校正与推断:用「拟合工具箱」更直接。
容易误读的地方
- 节点数一改,“曲线长什么样”的结论就跟着改,而非线性检验可能全程不显著。 实测同一份数据从 3 个节点加到 6 个:内部拐点个数是 0 / 1 / 1 / 0,拐点位置从 X≈44.333(4 节点)跳到 X≈88.333(5 节点),曲线最低点从 29.000 变成 44.333 又变回 29.000;而非线性检验的 p 一路是 0.141 / 0.231 / 0.362 / 0.460,从头到尾不显著。第四张卡的“曲线形态”描述的是这一次拟合出来的那条线,报告自己在那一行里写着“非线性检验不显著,该拐点不足以支持总体存在 U 型/阈值效应”。节点数是主观选择,必须写进方法学并用 3~5 个节点重跑做敏感性分析。
- 千万别为了让 p 小于 0.05 去挑节点数。 上面那组实测里,非线性检验的 p 随节点增加而单调变大(因为自由度也在增加),反方向挑同样可行。非线性不显著是最常见、也完全正当的结果:此时样条的价值恰恰是“排除了非线性”。示例 4 节点时线性模型的 AIC(361.577)与 BIC(372.688)都比样条模型小,信息准则与似然比检验一致地支持简约的线性设定,正确写法是按线性模型报告、样条曲线作为敏感性分析附上。
- 曲线两端是外推,不要在那里读拐点。 第一张卡的节点区间表逐段给出样本数:4 节点时最稀疏的一段还有 57 例,6 节点时只剩 26 例(占 8.67%)。样条在观测稀疏的区间上本质是外推,置信带会急剧变宽,弯曲基本由少数几个点决定——实测 5 节点算出的“最高点 X=88.333”恰好落在最稀疏的那一段里。
- 分位点表的 p 值不做多重比较校正,这是有意为之而不是漏了。 那 6 个非参考分位点是同一条曲线上的不同切片、彼此高度相关,不构成独立的假设检验,学界惯例不做 Bonferroni 一类校正,报告在表下写明了这一点。要判断“X 与结局整体上是否相关”,唯一的依据是第二张卡的总体关联检验。
- 所有效应都是“相对参考点”的,而参考点固定为中位数、不能自己指定。 示例的 OR 全部以 X=63.000 为 1,P75(70 岁)的 OR=2.330 意思是“相对 63 岁”而非“相对最低风险点”。论文里必须写明参考点取值,否则读者无法复现这些 OR;想以临床常用切点为参照时,只能先把数据裁到相应范围或换用别的模型。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:样条模型主结果表
- 输出结果三:限制性立方样条曲线(含95%CI)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
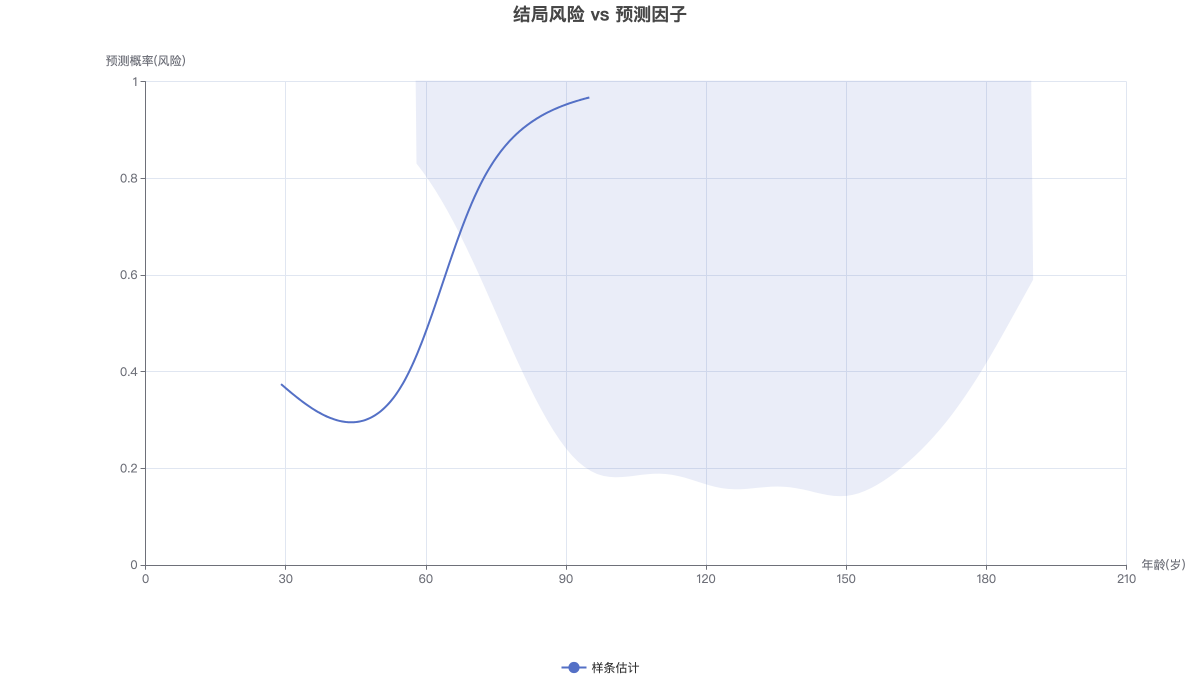
实线为样条估计的预测值,阴影为 95% 置信带;协变量按均值固定。可用右上角的视图切换器切到「表格」查看曲线上等距 21 个点的预测值与上下限。