
np 图
这个方法是做什么的
监控每批的不合格品件数是否稳定。每一行是一个子组,你给出该子组的受检样本量与其中的不合格品数,图上直接画件数 xᵢ 本身。中心线是 np̄=n·p̄,控制限取 np̄±3√(n·p̄(1−p̄)),下限在 0 处截断。它有一条区别于 P 图的硬前提:各子组样本量必须完全相同;样本量一旦不一致,模块会直接拦截并提示改用 P 图,而不是替你换算。样本量固定,控制限才能是一条水平线,车间也才能直接按“今天坏了几件”读图。
它比 P 图多给一样东西:精确二项控制限。3σ 限是正态近似的产物,而件数是整数,所以报告同时按 Binomial(n, p̄) 的分位数给出一组不依赖正态近似的整数界限,并注明其实际误报率。演示数据里 3σ 限是 [1.6353, 21.4047]、精确二项限是 [3, 22],两者判出的越限子组同为 2 个。其余部分与计数型控制图共通:卡①查 n·p̄≥5 的近似条件、Pearson 过离散 χ² 与一阶自相关;卡②补一个超限点数的精确二项检验;卡④给 DPMO、长期/短期西格玛水平、过离散比 φ,以及各子组与其余子组合并率的两比例比较(率差 95%CI、Cohen's h、Bonferroni 校正 p)。判异准则是 Nelson 8 条。
需要准备什么数据
- 不合格品数:1 个,定量变量(数值)
- 样本量:1 个,定量变量(数值)
- 子组编号/批次:1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 10%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 每批固定抽检同样件数的检验方案,例如每小时固定抽 200 件
- 现场希望直接看“坏了几件”这个绝对数,而不是换算成比率
- 需要一个整数化的报警门槛贴到工位上:越限点数与精确二项控制限都能给出整数界限
- 需要把不合格水平折算成 DPMO 或西格玛水平,与其他工序横向对齐
前提:每行是一个子组;不合格品数为非负整数且不超过样本量;各子组样本量固定;抽样相互独立、组内单元同质。数据要求把行数下限定在 20,少于 20 个子组会被前置校验拦下。3σ 控制限依赖二项分布的正态近似,需要 n·p̄≥5 且 n·(1−p̄)≥5——不满足时报告仍会给出精确二项控制限供替代,卡①会逐条列出实测值。
什么时候不要用它
- 各批受检数量会浮动:不用勉强凑成一样,改用「P 图」,它按每个子组自己的 nᵢ 逐点算控制限。
- 一件产品上能数出多个缺陷:件数与缺陷数不是一回事,检查机会恒定时用「c 图」,检查机会变化时用「u 图」。
- 质量特性本来是连续测量值:二分成合格/不合格会丢掉大部分信息,用「X-bar/R 控制图」「X-bar/S 控制图」或「单值-移动极差(I-MR)控制图」。
- 要抓不合格件数的小幅持续上升:3σ 限对这类漂移迟钝,可把标准化后的序列交给「CUSUM累积和控制图」或「EWMA控制图」。这条路要你手工做两步:先自己加一列 zᵢ=(xᵢ−np̄)/√(np̄(1−p̄)),再在 CUSUM 里把目标值 μ0 显式填 0(留空它取的是样本均值)。
- 样本量固定但你要比较的是两个批次之间有没有差异,不需要整条序列的监控:用「卡方检验」,件数很少时用「Fisher精确检验」,只有一个比率要对标某个目标值时用「二项式检验」。
- 想知道不合格件数本身的分布形态与集中程度:用「频数分析」或「描述性统计」。
容易误读的地方
- 样本量“基本一致”不算一致。 np 图的控制限是一条水平线,这条线只有在 n 严格恒定时才成立;n 变了,同样的件数对应的不合格率就变了,图上却看不出来。模块选择直接拦截而不是自动折算,正是因为这种“看起来还能画”的错误无法从图上察觉。批量会浮动就老老实实用 P 图。
- 3σ 界限落在小数上,真正的报警门槛是它旁边的整数。 演示数据 LCL=1.6353,件数是整数,所以下侧实际只有 xᵢ≤1 才会越限;UCL=21.4047 意味着上侧要 xᵢ≥22。这就是报告同时给出精确二项控制限 [3, 22] 的原因——它按 Binomial(200, 0.0576) 的分位数直接取整数,实际误报率 0.001929,与 3σ 的名义 0.0027 并不相等。两套界限判出的结果可能不同,报告时应写明用的是哪一套。
- np 图与 P 图给出的判异结论本质相同,选哪个是呈现问题不是统计问题。 卡①的表注写明两者只差一个常数 n。所以不要指望“换成 np 图看看会不会报警”——n 固定时它们的标准化统计量完全一样。真正的差别在沟通:件数便于车间执行,比率便于跨批量、跨产线比较。
- 过离散会伪装成失控,而且方向是固定的。 演示数据 χ²(24)=83.475、p<0.001、离散比 φ=3.478。φ=χ²/(k−1) 比的是方差:批间实际方差是二项抽样方差的 3.48 倍,折成标准差是 √3.478=1.86 倍,别把 3.48 读成“波动大了三倍半”。此时按二项方差算出的 3σ 限太窄,越限点会成片出现,看上去过程严重失控,其实是模型漏掉了批间的额外变异(原料批次、班次、设备差异)。卡①的结论文案会建议改用 Laney p′ 图,但产品目前不提供该图型;可行的替代是把分层因素显式建模,例如用「计数数据回归」或「零膨胀计数回归(ZIP/ZINB)」,或者把子组拆细、让混入的分层因素成为独立子组。
- Z_ST 是加出来的,不是测出来的。 卡④给 Z_LT=1.575、Z_ST=3.075,后者只是前者加 1.5,表注写明这个 1.5 是六西格玛领域的经验约定、非统计推断结果。把 Z_ST 当成实测能力写进报告,等于把行业惯例包装成了测量结论。
- “越限点只有 2 个、看起来不多”不能替代统计判断。 卡②给的精确二项检验回答的正是这件事:受控时 25 个子组的期望误报只有 0.0675 个,观测到 2 个的概率 p=0.002。反过来,若期望误报本来就有零点几个,出现 1 个越限点完全可能只是随机误报——此时应结合过离散检验与多重比较一起判,而不是看到一个红点就下失控结论。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:控制限与稳态检验(主结果)
- 输出结果三:np 控制图可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
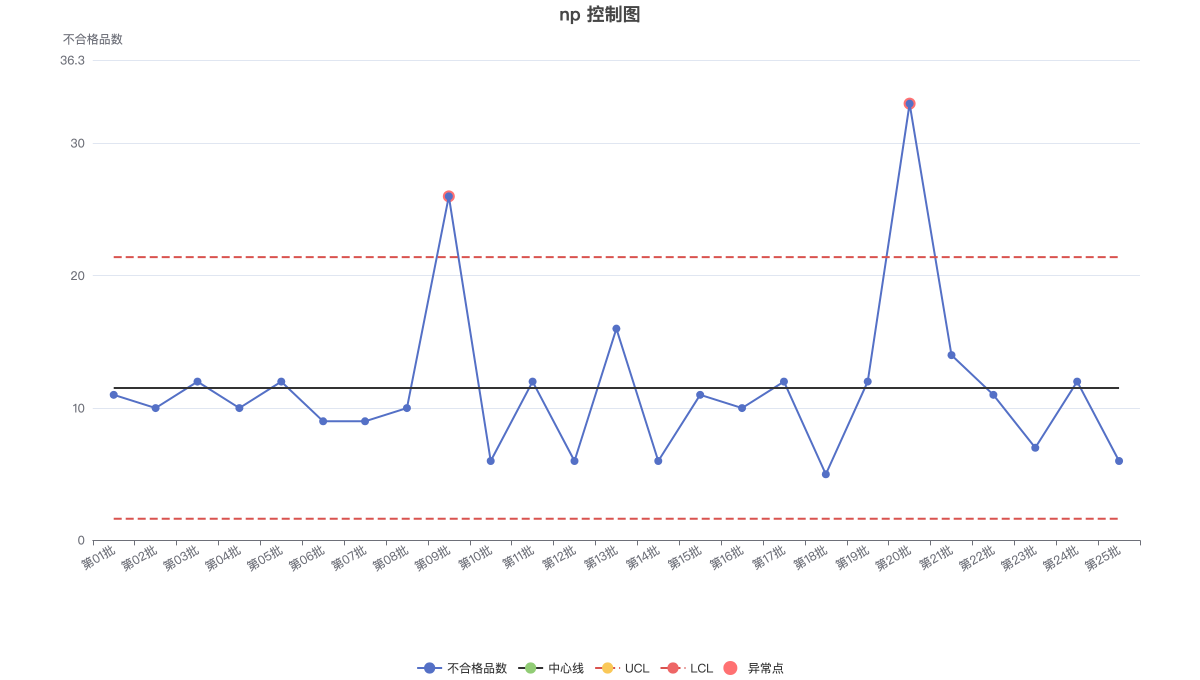
np 图用于监控固定样本量下各批的不合格品件数;黑实线为中心线 np̄,红色虚线为水平控制限,红点为超限子组。可用切换器在折线图/柱状图/数据表之间切换。