
聚类分析(K-Means)
这个方法是做什么的
把一批没有标签的样本,按特征上的相似程度分成你预先指定个数的群。它没有因变量、没有原假设,也没有 p 值——问的不是“组间有没有差异”,而是“这些人自己能分成几堆、每堆长什么样”。算法在标准化后的特征空间里用欧氏距离最小化簇内平方和(Inertia),初始化方式为 k-means++,n_init = 10;全部特征的 Z-score 标准化由模块自动完成,不需要你先处理。
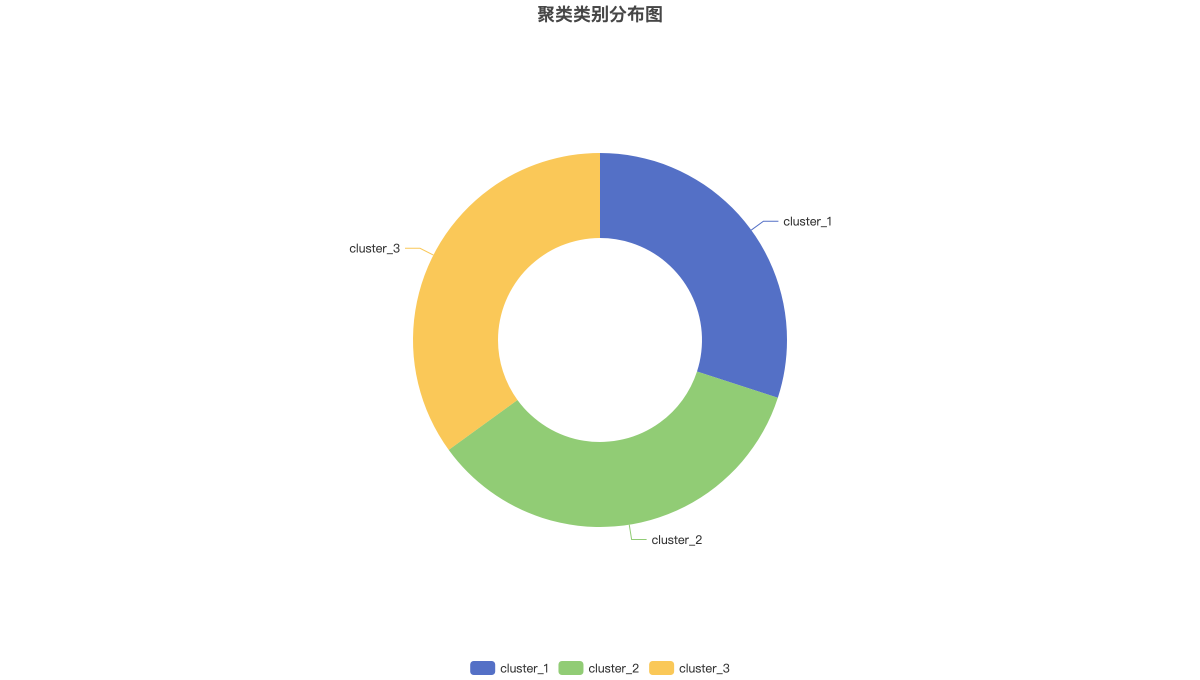
除了每个样本的归属,报告还给三样东西。一是簇的画像:第二张卡的聚类中心同时给标准化尺度与还原回原始业务量纲两套数值(正负号表示该簇在此特征上高于还是低于全体平均),并给出各簇规模、Wilson 95% 置信区间与簇内平均到中心距离。二是质量与稳健性:第四张卡给平均轮廓系数、Calinski-Harabasz 指数、Davies-Bouldin 指数与逐簇轮廓系数,给各变量在簇间差异的 F、p 与 η²,再换 4 组随机种子重跑、报告调整兰德指数(ARI)。三是簇数依据:第一张卡给出肘部法拐点与轮廓系数最优 k 两条参考,第三张卡把两条曲线画在同一张图上。
需要准备什么数据
- 放入聚类分析变量(可选):至少 1 个,定量变量(数值)或定类变量(分组/标签)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 手上是一批客户、门店或样本,还没有分类,想先切出几个可命名的群体
- 想拿到一列“类别”变量,再用它去做后续的画像、差异检验或效果追踪
- 业务上已经定死了要分几档(如“分三档做差异化运营”),只需要一个可复现的划分规则
- 参与聚类的都是定量变量,且预期各簇大致等大、形状接近球形
拖拽区同时接受定量与定类变量,但定类变量只能被整数编码后参与欧氏距离,这等于给类别强加了“有序且等距”的假设。数据要求:有效行数不少于 20、缺失比例不超过 20%、不得含常数列;聚类个数只能填 2~20,且建议样本量至少为 k 的 10 倍。
什么时候不要用它
- 你真正想找的是“异常的少数”:K-Means 把每个样本都硬分进某个簇,没有“噪声”这一类,离群点会被塞进最近的簇并把该簇中心拉偏。要让离群点单独成类,用「密度聚类(DBSCAN)」,它会输出一个“异常样本”类别;只想把极端值压回合理范围再聚类,先做「缩尾处理(Winsorize)」。
- 变量里有本无顺序的定类变量(所在城市、渠道来源):整数编码会凭空造出顺序与等距关系,划分结果随编码顺序而变。改用「二阶聚类」,它对定类变量走独热编码,不给类别强加顺序。
- 你要分组的是变量而不是样本(“这 20 道题聚成几个维度”):本模块聚的是数据行。变量分组用「分层聚类」(本产品的分层聚类做的正是 R 型、聚变量),或用「因子分析(探索性)」与「主成分分析(PCA)」把变量压成少数几个连续成分。
- 样本已经有现成的分组标签(已知会员等级、已知实验组):那是有监督问题,不该用聚类。只想描述各组特征用「分类汇总」,检验组间均值差异用「单因素方差分析」,想用特征去预测已知类别用「线性判别分析」或「随机森林分类」。
- 簇明显不是球形、或规模悬殊:K-Means 以到中心的欧氏距离划界,会把细长带状的簇拦腰切断,也会把大群旁边的小群吸收掉。形状不规则时用「密度聚类(DBSCAN)」;动手前想先看一眼有没有分离结构,用「t-SNE降维可视化」。
- 只是想做客户价值分层:直接用「RFM客户价值分层」,它按业务规则打分分层,比聚类更可复现也更好解释。
容易误读的地方
- 给出了簇,不等于数据里真的有簇。 把一团均匀的随机数丢进来,它照样返回 k 个簇。第四张卡“各定量变量在簇间的差异”那张表的 F 与 p 值不能当作簇存在的证据——表注写得很直白:簇本身就是为最大化组间差异而构造的,p 值必然偏小,它只能用来排序各变量的区分贡献。真正提示结构强弱的是平均轮廓系数,示例数据为 0.4042,模块判读为“结构尚可(0.25~0.5)”;低于 0.25 时它给的原话是“结构微弱,簇间重叠明显”——说的是簇之间分不开,不是“数据里没有簇”。
- 簇数由你填,模块只给参考、不替你改。 示例里三条线索给了三个答案:肘部拐点 k = 4、轮廓系数最优 k = 2、而设定值是 k = 3。第一张卡会打出两条“[注意]”指出这个不一致,但仍按你填的 k 出全套结果。两条参考本来就不同源:Inertia 随 k 单调下降,只能看拐点、不能取最小值;轮廓系数有明确最优值,却系统性偏好分离清晰的少数几个簇。二者不一致是常态,最终取哪个 k 要靠业务可解释性,并在论文里写明依据。
- 种子稳定性 ARI = 1.000,只说明算法收敛稳定,不说明簇结构在新样本上还在。 第四张卡那张稳定性表换的是 random_state(初始化种子),它回答的是“目标函数是否存在多个近似最优解”。“换一批客户还能不能分出同样的群”是另一个问题,需要重抽样才能回答,本模块不做——产品内用 Bootstrap 重抽样算 ARI 的是「二阶聚类」。所以种子 ARI 高只是及格线,不构成稳健性证据。
- 标准化模块替你做了,但标准化本身就是一次加权决定。 Z-score 让每个变量在距离里的权重相同,这是假设而非中立操作。后果有二:其一,若你拖进 5 个都在测消费金额的变量、只有 1 个测到店频次,消费维度会以 5 比 1 的权重主导划分;其二,标准化不解决离群值——数据要求里原话是“标准化后仍可能被个别观测拉走簇中心”。拖变量之前先用「Pearson相关性分析」看看它们是不是成堆重复。
- 簇的名字和含义是你赋予的,编号更没有大小之分。 报告只客观给出“某簇在各特征上偏高还是偏低”,叫它“高价值客户”还是“高频低客单人群”属于解释。第二张卡标准化中心的正负号与绝对值是唯一客观依据,绝对值很小的特征不该写进该簇的命名。另外第五张卡的“到所属中心的距离”要一并看:距离大的样本处在簇边界、同时带有多个簇的特征,拿它当典型代表做画像会失真。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:聚类中心与簇规模
- 输出结果三:簇数选择曲线与聚类可视化
- 输出结果四:聚类质量、组间差异与稳定性检验
- 输出结果五:结论、学术表述与聚类成员
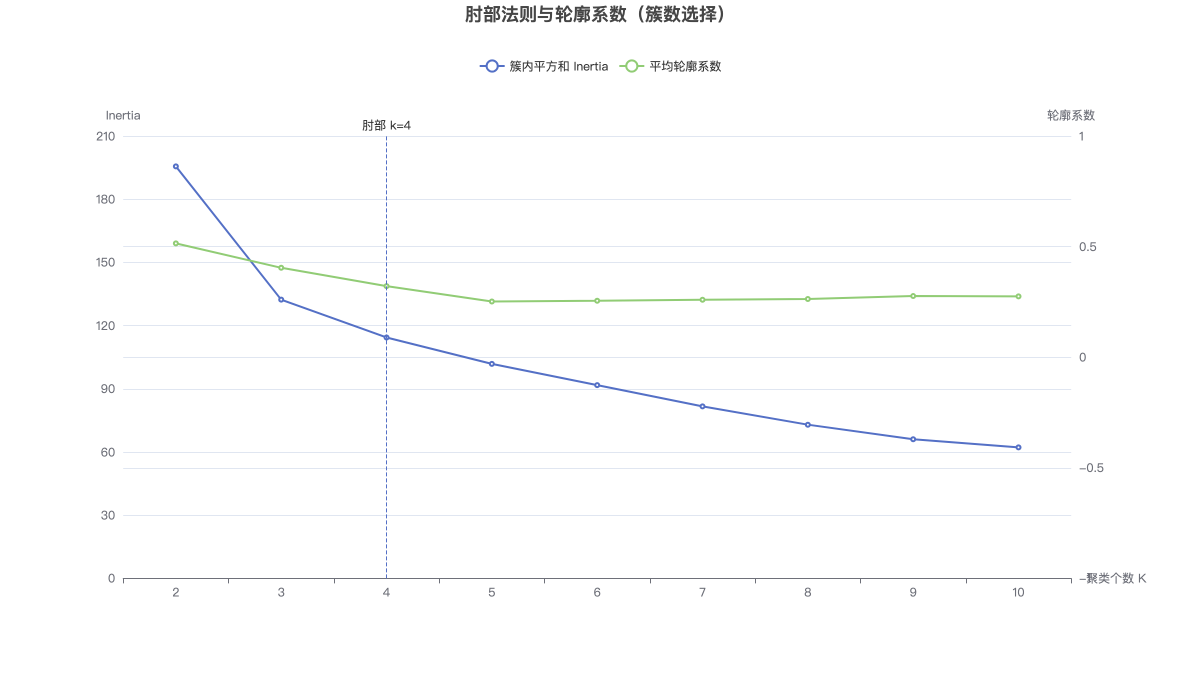
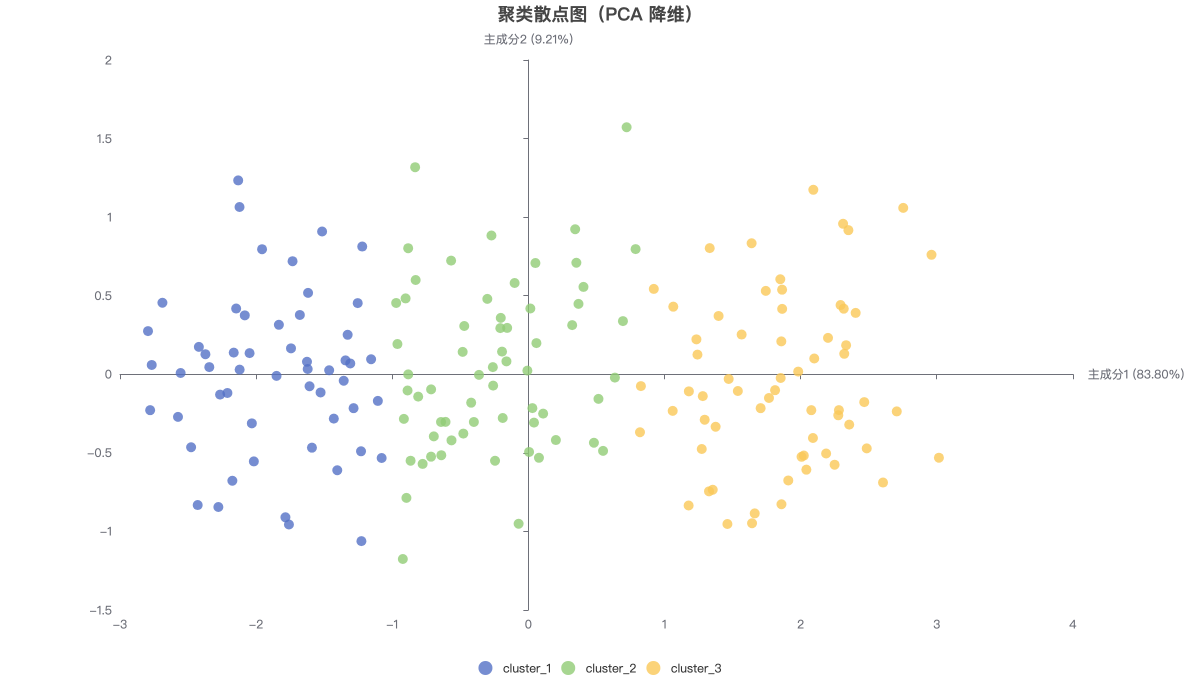
肘部图叠加了轮廓系数曲线:Inertia 随 k 单调下降,只能看「拐点」;轮廓系数则有明确最优值,两者结合比单看肘部更可靠。 聚类在 3 维标准化空间中进行,散点图通过主成分分析(PCA)降至二维展示,前两个主成分共解释 93.01% 的总方差。