
线性判别分析
这个方法是做什么的
在已知分组的前提下,找出几个定量指标的线性组合,使各组在这条组合轴上分得最开——组间差异与组内差异之比达到最大。这条轴叫典范判别函数,g 个组最多能提取 min(g−1, 判别变量个数) 条。它和这一族其它模块最根本的差别在于它是有分布假设的方法:假定各组内多元正态、且各组的协方差矩阵相同。假设换来了别处没有的东西——整体显著性检验(Wilks' Λ)、可解释的判别系数与结构载荷、一张把各组画在同一平面上的分离图,以及一条把新个体代进去就能算出归类的 Fisher 分类函数。
报告共六张卡,比同族多一张附表。卡① 给样本结构、各组描述统计、逐变量的组均值相等性检验,以及四条前提的实测(每组样本量是否多于判别变量个数、Box's M 协方差齐性、逐组逐变量的 Shapiro-Wilk 正态性、合并组内相关);卡② 给特征值与典范相关、Wilks' Λ 检验、判别系数与 Fisher 分类函数;卡③ 给判别得分散点图与各组质心;卡④ 给结构矩阵、效应量与三种口径的分类正确率;卡⑤ 给论文表述;卡⑥ 是测试集逐例明细。读之前要留意报告内部有两套样本量:典范部分与整体检验用全部 240 例(表3 的 F 自由度是 (2, 237)=(g−1, N−g)),而表8 的 Fisher 分类函数与卡⑥ 的逐例判别只用训练集那 168 例(表8 的表注写着“本表由训练集(n=168)拟合”)。
需要准备什么数据
- 分组变量 (Y):定类变量(分组/标签)
- 判别变量 (X,多选):至少 1 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「分组变量 (Y)」的类别数需在 2~10 之间。
- 「分组变量 (Y)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 分组已经确定(已确诊 / 未确诊、三档客户),想知道一组定量指标整体上能不能把它们区分开,并且需要一个显著性检验
- 需要知道哪几个指标在区分上贡献最大,且要写进论文的是载荷与系数,不是“重要性排名”
- 需要一张把各组画在同一平面上的分离图,直观展示组与组的距离
- 需要一条能手算、能写进流程文件的判别式,新个体代入即可归类
前提:判别变量必须全部是定量列(拖拽区只收定量),分组变量 2~10 组——实测 11 组会被直接挡下,提示“超过线性判别分析允许的上限 10 个”;每组至少 5 例,整表至少 30 行(29 行同样被挡下)。还有一条更硬的:每组样本量必须多于判别变量个数,否则组内协方差矩阵奇异,典范判别函数与 Box's M 都求不出来——卡① 表4 第一行给出实测的“最小组 n vs p”。经验准则是总样本量至少为判别变量个数的 5 倍。
什么时候不要用它
- 分组本身是要找出来的、而不是已知的:判别分析必须先有组标签;想从数据里分出群体用「聚类分析(K-Means)」或「二阶聚类」。
- 判别变量里有定类列:本模块的判别变量区只接受定量列。含类别自变量的分类问题用做哑变量的「逻辑回归」,或能直接按类别分组的「CHAID决策树」。
- 结局只有两类、你要的是优势比与置信区间:判别分析给的是判别系数不是 OR;用「逻辑回归」。
- 各组的协方差明显不齐,或组间关系根本不是线性的:线性边界会系统性偏离最优;改用不对分布与协方差做任何假设的「随机森林分类」。
- 分组超过 10 个:会被数据契约挡下;这种规模的多分类用「随机森林分类」或「XGBoost分类」。
- 观测之间不独立(同一对象多期、机构内嵌套):组内协方差被低估、判别力虚高;用「混合模型」。
容易误读的地方
- 判别函数的正负方向是任意的,“得分高”本身不含褒贬。 把某条函数的全部系数与载荷同时取反,所有统计量一字不变。演示数据里函数1 的结构载荷是“近12月消费额(千元)”−0.6626、“月均登录次数”−0.5967、“客服工单数”+0.4207,而卡③ 的质心是流失风险 +2.067、成长型 −0.071、高价值 −1.995——这条轴是“越大越像流失风险”。要判断方向只能看质心表,凭系数正负想当然会把结论说反。
- 表11 的三个正确率是三个口径,只有留一交叉验证那一行能往外报。 本次训练集回代 0.8274、独立测试集 0.7917、留一交叉验证 0.7875。表注写着“训练集回代正确率必然偏乐观,判别分析的规范报告应以留一交叉验证结果为准”,卡④ 的结论文案还把偏倚量算了出来:“比训练集回代低 0.0399,该差值即回代的乐观偏倚”。另外表12 的混淆矩阵是留一口径(n=240),卡⑥ 的逐例明细是测试集口径(n=72),两处的误判例数不能互相对账。
- 函数2 显著,却只解释 1.53% 的组间方差。 表5 里函数1 的特征值 2.7879、占 98.47%、典范相关 R=0.8579;函数2 特征值 0.0433、占 1.53%、R=0.2038,而表6 对它的 Wilks' Λ 检验给出 p=0.007,仍然显著。显著只说明“它带的信息不是零”,不说明“它有用”。 要不要保留第二条函数,看的是方差解释比例,以及卡③ 的散点图在第二个方向上各组有没有真的分开,不是看那个 p。
- Box's M 判“满足”不等于协方差齐性成立,判“违背”也不等于不能做。 表4 那一行自带提醒:“注:Box's M 对非正态与大样本极其敏感,需结合样本量与正态性一并解读。”实测把其中一组的离散度放大四倍后,这一行的判定从 p=0.506 时的“满足”翻成 p<0.001 时的“违背”,报告随即建议改用二次判别分析(QDA)——但产品里没有 QDA 这个模块。产品内可行的出路有两条:先对变量做方差稳定变换后重跑,或换成不对协方差做任何假设的「随机森林分类」。
- 正态性“部分违背”多半不致命,但也别倒过来把“不显著”读成“前提成立”。 演示数据 9 项 Shapiro-Wilk 里拒绝了 4 项,其中三项都出自“客服工单数”——一个整数计数变量,本来就不该期待它正态。表4-1 的表注写着“样本量很大时轻微偏离也会被判为显著”,所以 n=80 下的 p=0.014 说明不了偏离有多严重。反方向同样要小心:表4 的表注专门声明,判定栏写成“未能计算”的项目表示该前提确实没有检验,不得当作前提成立来读。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:典范判别函数与显著性检验
- 输出结果三:判别得分与分类效果可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
- 附表:测试集逐例判别明细
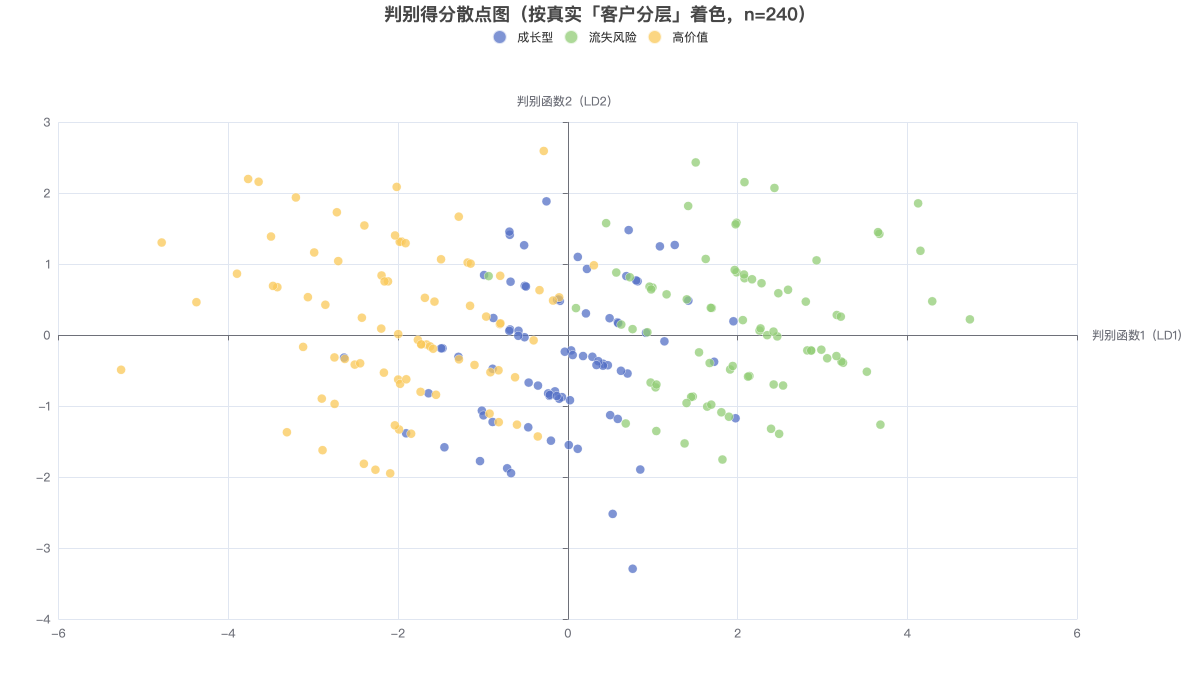
图示为全部 240 个观测在典范判别函数上的得分,按**真实组别**着色;横纵轴分别为前两个判别函数。
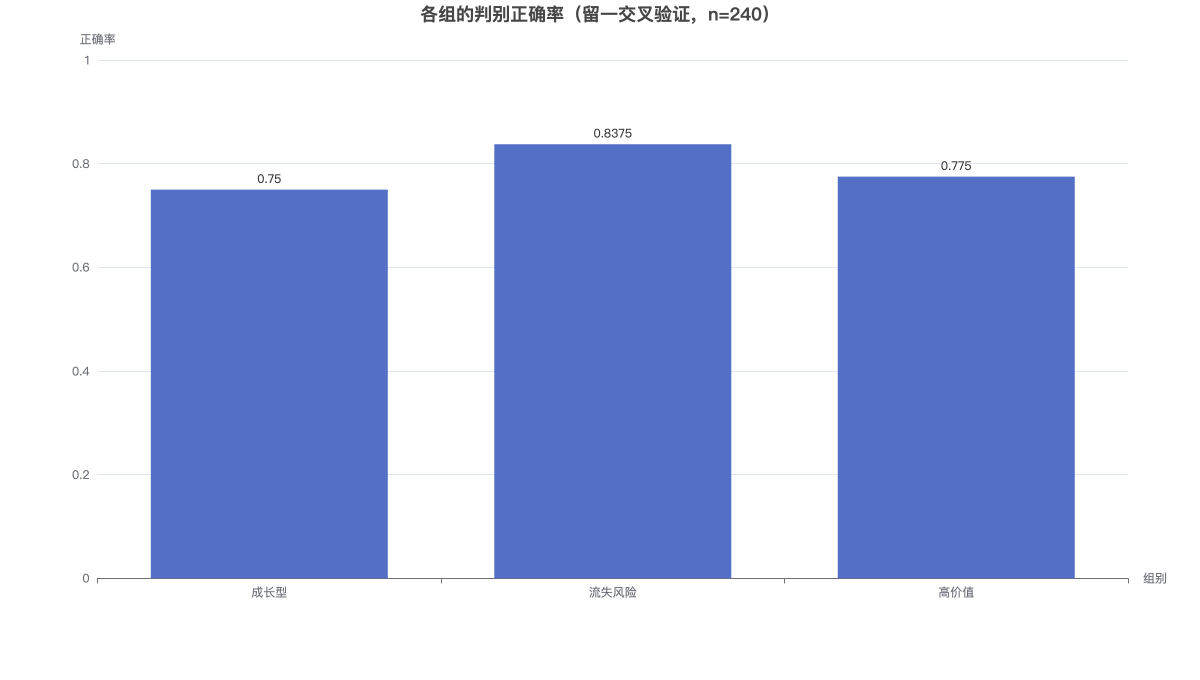
该图给出每个组被正确判别的比例(留一交叉验证口径)。