
时间因果模型
这个方法是做什么的
在一个向量自回归框架里,对纳入的每一对变量做双向的格兰杰式检验:控制住结果变量自身的历史以及其余变量的历史之后,原因变量的历史还能不能显著改善预测。与单纯的两两检验相比,它把所有变量放进同一个 VAR,因此“控制其余变量”是真的做到了。
它替你处理三件本来要手动做的事:按 ADF 判断是否非平稳并可自动做一阶差分(开关默认打开);按 AIC、BIC、HQIC、FPE 中你选定的准则,在最大滞后阶范围内自动定阶;逐方程做 Ljung-Box 残差白噪声检验确认滞后设定够不够。卡④ 给出这个模块相对同族的独有产出——Geweke 线性因果度量 F=ln(σ²受限/σ²完整) 与部分 R²,前者是把“预测误差减少了多少”写成一个可跨数据集比较的数,后者直接是原因变量的历史额外解释的方差比例,并配 BH-FDR 校正。读报告时的着眼点是卡① 的“平稳化处理”那一行:它决定了后面所有结论说的是水平之间还是变化量之间的关系。
需要准备什么数据
- 放入时间序列变量:至少 2 个,定量变量(数值)
- 放入时间变量(可选)(可选):0~1 个
数据要求
- 数据表至少 29 行。
- 单列缺失率不超过 15%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 三条以上时间序列,想一次筛出所有值得关注的方向性关系
- 不确定该用几阶滞后,希望由信息准则自动决定并留下依据
- 需要在显著性之外报告一个可比较的因果强度指标
- 多方向筛查,需要现成的多重比较校正而不是自己算
前提是观测等间隔、无断档,各序列非常数。行数下限 29 行是按“默认最大 6 阶 + 3 个序列”由 (p_max+1)×(k+1) 算出来的,28 行会被直接拦下;变量更多或滞后阶更大时要照这个公式加行(模块说明里举了 4 个序列 6 阶需 36 行),而要得到可靠的 F 检验仍建议 50 期以上。拖入“时间变量”后模块会按它排序——把演示数据行序打乱重跑,输出逐字不变。
什么时候不要用它
- 只有两条序列、且它们本身就平稳,你要的就是一张最简的双向检验表:用「格兰杰因果检验」,它另外给 Bonferroni 与 BH 两套校正(两条序列非平稳时不适用,见下面“序列非平稳且彼此同阶单整”那一条)。
- 你要的是冲击的传导路径、持续期与方差贡献占比:本模块不给脉冲响应,用「VAR向量自回归模型」。
- 序列非平稳且彼此同阶单整,而长期均衡正是你的研究问题:本模块只会一阶差分,长期均衡信息就此丢掉——用「协整检验」定协整关系个数,再用「ECM模型」刻画短期调整。反过来,只想知道谁领先谁的话不必转走:“非平稳时自动一阶差分”开关默认打开,这类数据直接就能跑(实测三条 I(1) 序列照跑不误,卡① 的“平稳化处理”一行写“全变量一阶差分”),结论说的是变化量之间的领先关系。
- 想估计一次干预的真实因果效应:这里的“因果”只是预测增量,用「双重差分(DID)」或「断点回归(RD)」。
- 只想知道两条序列错开几期最同步:用「互相关分析」。
容易误读的地方
- 模块名里的“因果”是格兰杰意义上的,不是机制意义上的。 卡⑤ 的“解释边界”把话说全了:它既不排除共同的第三方驱动因素,也不排除同期(瞬时)因果,更不能替代随机化实验或结构式识别。把这里的箭头方向直接写成“A 导致 B”,是这个模块最容易被误用的地方;正确的表述是“在控制了各变量的历史之后,A 的历史对 B 具有增量预测力”。
- 自动差分开着的时候,结论的主语会悄悄换掉。 序列非平稳时模块会做一阶差分再检验,此时得到的是“变化量之间的预测关系”,与“水平之间”不是一回事——一个变量的增速能预测另一个的增速,不代表它们的水平有关联。卡① 的“平稳化处理”行会写明是“原序列”还是差分后(演示数据三条序列水平即平稳,因此显示“原序列”)。这一行必须跟着结论一起报告。
- 滞后阶准则不一致时,模块只按你选的那个走,不会提醒你。 卡① 的“VAR 滞后阶数选择”表把 AIC、BIC(SC)、HQIC、FPE 四个推荐值全列出来,演示数据上四者一致给 2 阶。如果它们分散在不同的阶上,说明结论对滞后阶是敏感的,应当在几个候选阶各跑一遍看方向是否稳定,而不是默认接受 AIC 的那一个。
- 残差白噪声检验不通过时,F 统计量会被高估。 卡① 逐方程的 Ljung-Box 就是查这个的,表注写明“残差若仍显著自相关,说明滞后阶数不足,Granger 检验的 F 统计量会被高估”。也就是说,残差不干净时看到的显著多半是滞后阶不够造成的假象,此时该加大最大滞后阶重跑,而不是照抄那张因果表。
- 显著性和强度要分开报,热力图只给前者。 卡③ 的热力图画的是 −log₁₀(p),颜色深只说明 p 小。演示中“先行指标 → 工业增加值增速”的部分 R²=0.1873(中等),而“先行指标 → 社会消费品零售增速”虽然也显著,部分 R² 只有 0.0945(小)。两条方向在热力图上都是深色,实际强度差一倍有余。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Granger 时序因果检验
- 输出结果三:因果关系可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
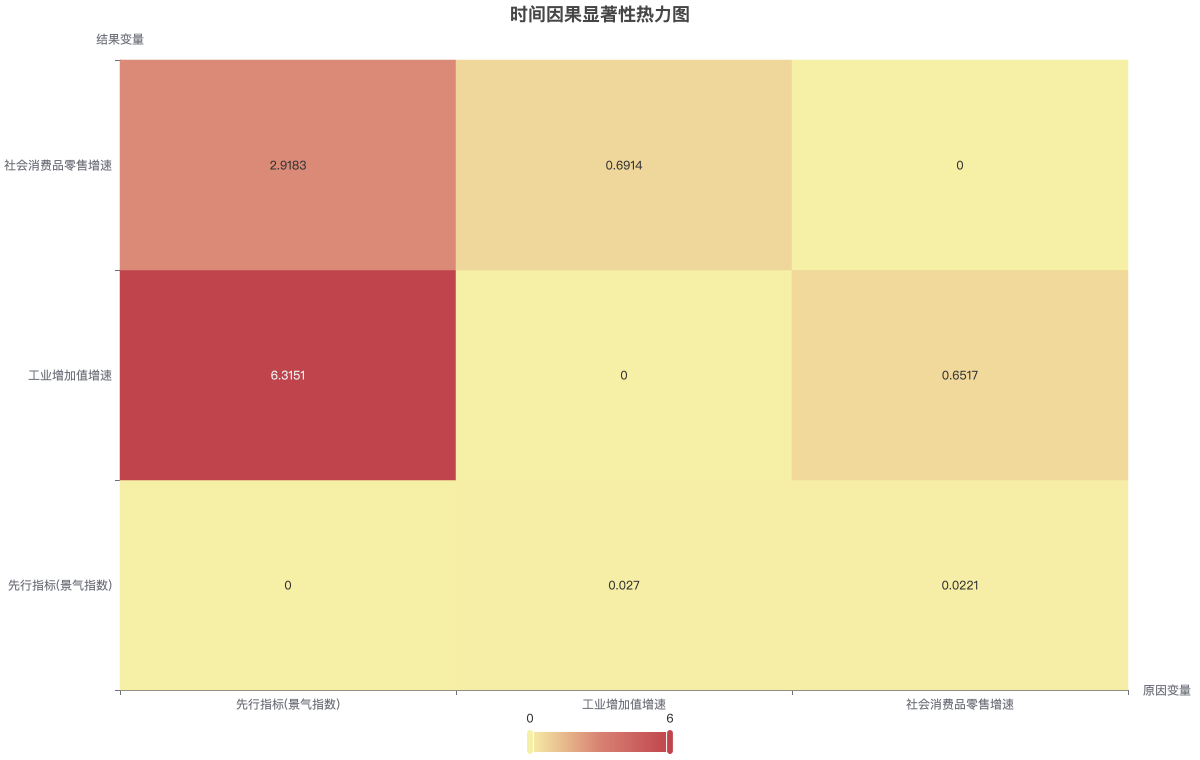
热力图数值为 -log₁₀(p),值越大说明该方向的因果关系越显著(α = 0.05 对应 -log₁₀(p) ≈ 1.30)。可用右上角切换器在「热力图/柱状图/条形图/表格」间互切,数据完全同源。