
C&RT决策树
这个方法是做什么的
把样本反复二分,最终得到一棵能逐条读出来的规则树。C&RT(CART)每一步都在全部自变量、全部可能的切点里搜一遍,选使两个子节点加权不纯度下降最多的那一组切下去——永远是二叉分裂,定类自变量经独热编码后条件写成“变量=某水平 ≤ 0.5”。它是四棵树里唯一能做回归树的:目标是定类还是定量由平台按唯一取值个数自动判定(唯一值 ≤ 10 判为定类),另外三棵只接受定类目标,拖入连续变量会直接报“当前算法要求目标变量为定类变量”。
报告共六张卡。主结果是卡② 表5 的 5 折交叉验证折外指标,“训练集”列只作过拟合对照。C&RT 特有的读法在后三张卡:卡④ 的变量重要性表比另外三棵树多一列“不纯度重要性(对照)”,即 sklearn 的 feature_importances_,表注写明它偏爱取值多的变量且完全基于训练集;卡⑤ 表9 的节点明细没有 p 值列,表注逐字写着“C&RT 的分裂不做显著性检验,因此本表没有 p 值列——这与 CHAID/QUEST 不同,不是遗漏”;回归任务下卡⑤ 表10 给的是各叶节点的预测均值、组内标准差与取值范围,分类任务下换成提升度 Lift。它也是这一族里最快的:同一份 240 条数据,端点耗时 0.07 秒,CHAID 要 1.98 秒。
需要准备什么数据
- 放入目标变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 目标变量是连续数值,又想要一棵能读出阈值的树(另外三棵树做不了回归)
- 需要精确切点:“广告投入 ≤ 6.24 万元”这类条件可以直接落到业务规则里
- 定量与定类自变量混在一起,不想自己构造交互项
- 想用代价复杂度剪枝(ccp_alpha)而不是靠显著性阈值来控制树的大小
- 只要预测规则,不需要每个自变量的系数与显著性
前提:至少 20 条完整记录(19 条会被直接拦下并报“有效样本量过少”),所选变量上有任一缺失的整行会被剔除,禁止常数列,目标变量不能同时出现在自变量里。样本量最好达到自变量个数的 10 倍以上,卡① 表4 第二行会给出实测比值与判定。20 条只是能跑通的下限而不是能用的下限:把演示数据截到 20 行重跑,折外 R² 是 −0.8250,比直接用均值预测还差。
什么时候不要用它
- 想让每一次分裂都带显著性检验、并且允许一次分成三支以上:用「CHAID决策树」;希望它把合并方案枚举到底再选最优,用「Exhaustive CHAID决策树」。
- 担心分裂偏向取值多的变量:C&RT 靠遍历切点选变量,候选切点越多的变量越占便宜;把选变量与找切点拆开的「QUEST决策树」正是为这件事设计的。
- 要的是预测精度而不是一棵可读的树:单棵树对数据扰动很敏感,删掉少量样本就可能换一个根节点;分类用「随机森林分类」,回归用「随机森林回归」。
- 要系数、置信区间与 p 值:整份报告没有任何针对自变量的显著性检验。连续因变量用「线性回归 (最小二乘法)」,二分类因变量用「逻辑回归」。
- 观测之间不独立(同一批门店的多期数据、同一所学校里的学生):交叉验证会把同一个体拆到训练折与验证折两边,指标虚高;用「混合模型」或「面板模型」。
容易误读的地方
- “分裂准则”控件在回归任务上是摆设。 演示数据的目标是连续的月度销售额,把控件从 squared_error 换成 gini 或 entropy,输出逐字一样:折外 R² 都是 0.3367、都是 15 个叶节点。两个分类准则被静默换回 squared_error,反过来在定类目标上选 squared_error 也会被换回 gini。要知道实际用的是哪个,看卡① 表4 “超参数:分裂准则”那一行显示的值——它显示的是生效值,尽管释义列写着“由用户在左侧控件设定”。
- 表9 里“广告投入被选进根节点”不等于它显著。 C&RT 选的是让不纯度下降最多的切分,全程不做任何检验,所以表9 只有“不纯度”列。想要带 p 的分裂,得换 CHAID 或 QUEST——但那两个的 p 也不是假设检验结论(各自条目里另有说明)。
- 表5 的 R² 和表7 的 R² 不是同一个数,也不是其中一个算错了。 本次表5 给 0.3367(逐折算完再取均值),表7 给 0.3705(把全部折外预测汇总成一份后再算),差 0.034。两张表的表注都写了口径。写进论文时必须注明用的是哪一种,不能挑大的那个报。
- 默认参数下叶节点会碎得很快,而它们才是规则的可信度上限。 演示数据最大深度只有 4,就切出了 15 个叶节点,其中 8 个只有 5~7 个样本(占比 2.08%~2.92%)。C&RT 唯一的约束是“最小叶节点样本数 ≥ 5”,没有显著性门槛:把 CHAID 那份 240 条的二分类演示数据同时喂给两个模块,C&RT 长出 14 片叶、CHAID 只长 7 片,而折外准确率是 0.7250 对 0.7292。样本量个位数的叶节点,其“预测均值”和“取值范围”由那几个样本决定,换一批数据基本不成立。
- 不纯度重要性和置换重要性给出的是两件事,报告只让你信后者。 本次两列排序恰好一致(广告投入 0.6273/0.63169、门店面积 0.2733/0.28638、促销折扣力度 0.0994/0.11627),但表注写明前者“偏爱取值多的变量、且完全基于训练集,仅作对照;结论应以置换重要性为准”。而置换重要性本身也只是“在这个模型里谁被用上了”,不是因果效应,变量之间高度相关时还会互相稀释。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉验证性能主结果表
- 输出结果三:树结构图与折外预测诊断图
- 输出结果四:误差分解与变量重要性
- 输出结果五:节点明细与叶节点决策规则
- 输出结果六:结论与学术表述
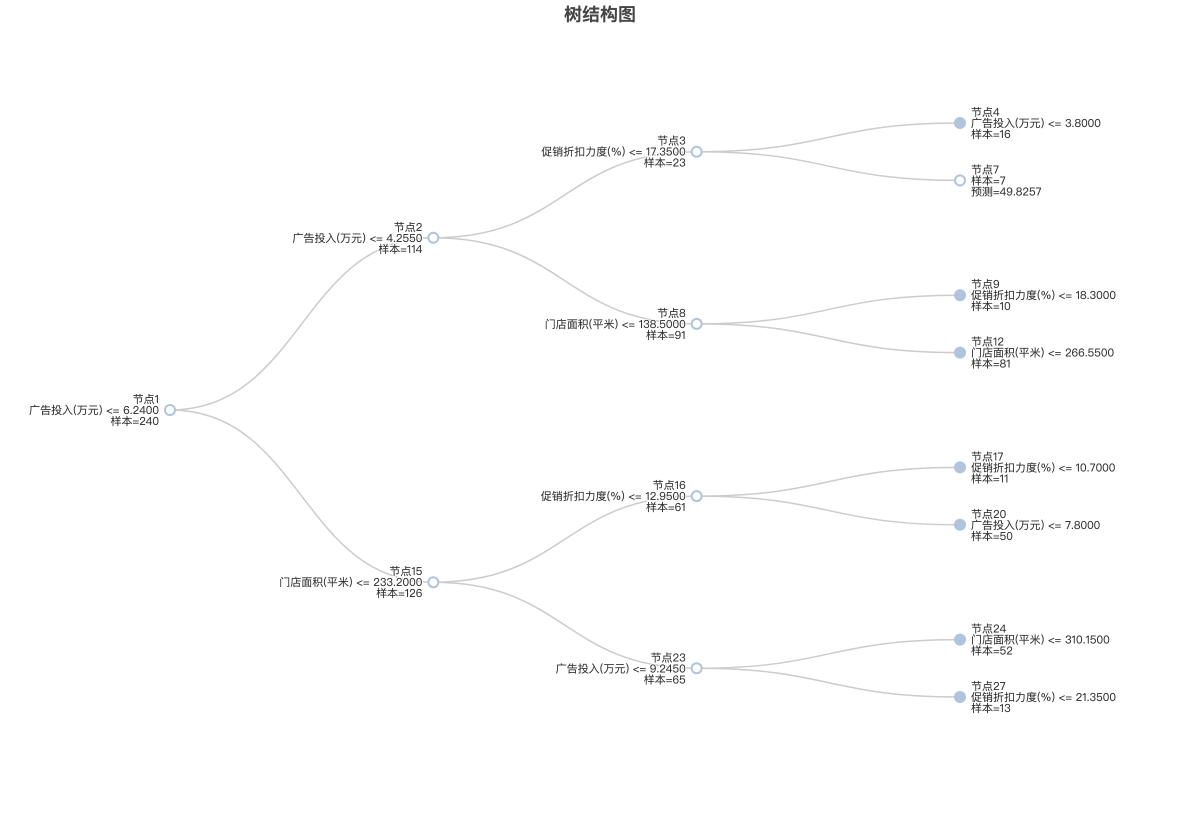
树图自左向右展开:每个节点标注编号、分裂条件(变量 ≤ 阈值)、样本数与预测值;可用右上角切换器切到「表格」查看同一棵树的节点清单(含不纯度)。
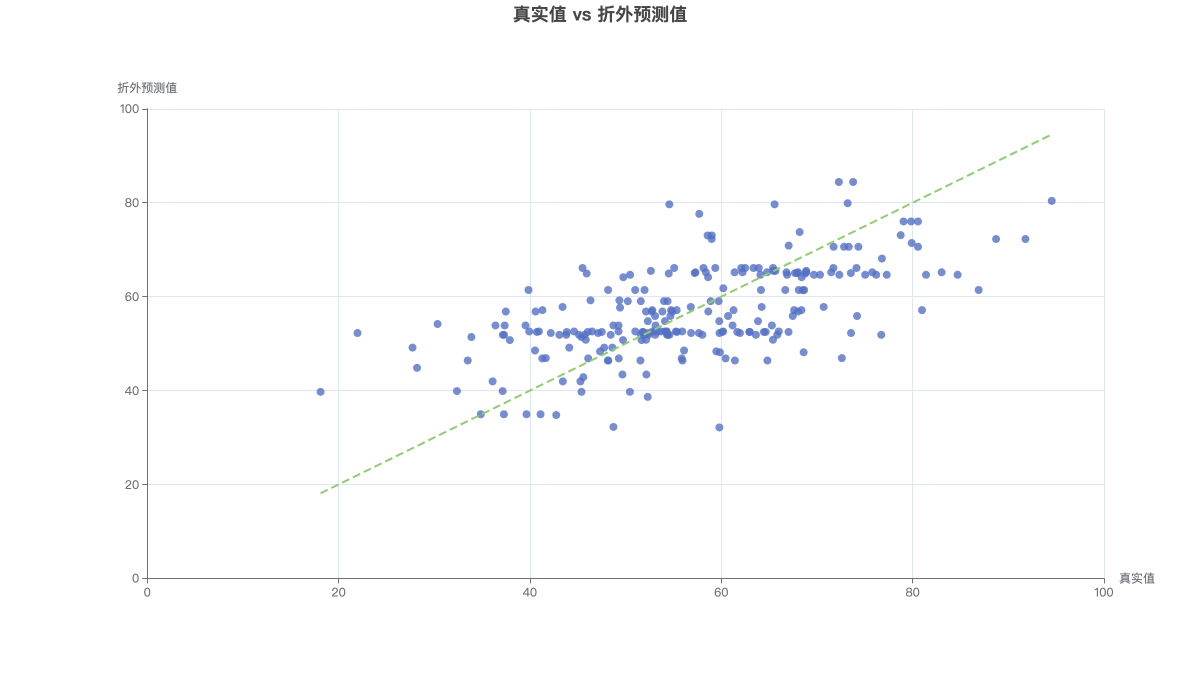
散点为每个样本的(真实值, 折外预测值),虚线为 y = x 理想线;点越贴近虚线说明预测越准。