
Kano模型
这个方法是做什么的
回答“这个功能属于哪一类需求”。做法是对同一个功能问两遍:正向问“如果有这个功能,你怎么看”,反向问“如果没有这个功能,你怎么看”,两题用同一套 5 级选项(本模块约定 1=喜欢、2=理应如此、3=无所谓、4=勉强接受、5=不喜欢)。把每份问卷的这一对回答落进 Kano 评价矩阵,就得到该受访者对这个功能的标签:必备型(M)、期望型(O)、魅力型(A)、无差异型(I)、反向型(R)、可疑(Q);全样本取众数即该功能的类别,并列时按 M>O>A>I>R>Q 的传统重要度仲裁。
除了类别标签,报告给出可以量化比较的部分:Better(SI) =(A+O)/(A+O+M+I),越大表示做了越能加分;Worse(DSI) = −(O+M)/(A+O+M+I),绝对值越大表示不做越会扣分——两者都配 Wilson 95%CI,且 R 与 Q 不计入分母。还有分类强度 CS(首位类别占比减次位类别占比)与总强度 TS、Goodman(1965) 的 z 检验判断首位类别是否真的高于次位、A/O/M/I 四类分布的 χ² 拟合优度与 Cohen's w,以及 Better 系数经 Bonferroni 校正的两两比较。卡① 逐特性给出编码合法性、Q+R 矛盾率、正反向题的 Spearman ρ,以及“按 6−x 反向计分后矛盾率会不会下降”的量表方向诊断。
需要准备什么数据
- 放入[正向问题]功能列:至少 1 个
- 放入[反向问题]反功能列:至少 1 个
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 功能排期:先分清哪些是不做就挨骂的、哪些是做了才有惊喜的
- 改版前判断某个新功能值不值得投入,或某个旧功能能不能砍
- 已按双问法设计好问卷、回收后需要归类的分析
- 想用 Better/|Worse| 四象限给一批功能排投入优先级
前提中最容易翻车的一条是列的对应关系:正向列与反向列必须数量相等且按顺序一一对应,第 i 个正向列与第 i 个反向列要描述同一个功能,拖错顺序不会报错,只会给出一份看起来正常但完全错位的报告。两列均须为 1–5 的整数,越界作答会被剔除并计数;数据不少于 50 行——类别由众数确定,样本太少时众数会随抽样大幅摆动。
什么时候不要用它
- 只问了一遍(手上只有正向题):Kano 类别必须由正反两题的组合决定,单题无法归类。单题的满意度或重要度分布用「描述性统计」和「频数分析」看,多个功能横向排优先级用「MaxDiff最大差异分析」。
- 要比较的是功能水平之间的取舍(价格 199 还是 299、64G 还是 128G):Kano 只问“有/无”,水平层面的效用要用「联合分析(Conjoint)」。
- 问的是某个属性“是不是刚刚好”(太甜/正好/太淡):那是三级 JAR 量表的问题,用「惩罚分析(JAR)」。
- 想从一批功能里选几个组合起来覆盖最多人:Kano 逐功能独立归类,不做组合覆盖,用「TURF触达频次分析」。
- 想量化每个功能对总体满意度贡献了多少:Kano 给的是类别与比例,不给贡献度。把各功能评价对总体满意度建模用「线性回归 (最小二乘法)」,总体口碑的推荐倾向用「NPS净推荐值分析」。
- 同一个功能被不同人群理解成完全不同的类别:众数会把这种分歧一刀抹平。先用「聚类分析(K-Means)」把受访者分群,或用「列联(交叉)分析」看类别在人群变量上的交叉分布,再分组解读。
容易误读的地方
- 类别是众数投出来的,首位和次位常常只差几个人。 卡② 的 Goodman z 检验就是为此存在:示例里“有续航时间时的态度”首位是可疑(Q) 89 人、次位是必备型(M) 69 人,z=1.601、p=0.1093——两类在统计上分不开,把它当成“这是个 Q 类功能”就是过度解读。只有 z 显著的那些特性(示例中 4 个里有 2 个)才谈得上归属稳健;不显著的通常处在 A→O→M 的演化过渡带,此时单看“Kano 类别”这一个标签会丢信息,得结合 Better/Worse 一起读。
- 量表方向录反会让整份报告反号,而模块不会替你改数。 本模块约定 1=喜欢…5=不喜欢,不少问卷平台默认反着编。卡① 的方向诊断把“当前编码的 Q+R 比例”与“按 6−x 反向计分后的 Q+R 比例”并排给出,后者明显更低就是录反的证据。示例里两个特性被判“疑似方向录反”,从那一刻起,它们的类别与 Better/Worse 全部不可信。这不是“注意数据质量”的套话——它是本模块唯一会让结论整体翻个个儿的错误,而且报告不会自动修,只会提示。
- Better/Worse 的分母不是全部受访者。 计算时 R(反向) 与 Q(可疑) 两类被踢出分母,只留 A+O+M+I。示例里“有续航时间时的态度”总 N=200,有效分母只有 92,另外 108 人落在 R 或 Q。分母缩水一半时置信区间会宽很多,而点估计看上去还是个正常的小数。读 Better 之前先看同一行的“有效分母”那一列,否则会把一个由 92 人投出来的数字当成 200 人的结论。
- Better 之间的高低差距,多半经不起多重比较。 卡④ 对 Better 做了 Bonferroni 校正后的两两比较,示例里 6 组全部不显著(最小校正 p=0.9290)。也就是说,虽然摘要写着某个功能“Better 最高、最具提升满意度潜力”,但它与其它功能之间并不存在可确证的差别。按 Better 点估计的名次去分配研发预算,等于在噪声上做决策;卡④ 的结论文案已经直说了这一点。
- Kano 类别会随时间和人群漂移,它不是产品的固有属性。 一个功能早期是魅力型(A),普及后变成期望型(O),再往后成为必备型(M)——这本来就是 Kano 模型自己的核心命题。所以两年前的结论不能直接沿用;用自家老用户群、内部同事这类便利样本跑出来的类别,也只代表这个圈子:老用户早把某功能视为理所当然,新用户可能连听都没听过。类别归属对样本构成的敏感度,远高于对样本量的敏感度,而后者才是大家习惯去核对的那一个。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Kano 分类结果与分类可靠性检验
- 输出结果三:可视化(Better-Worse 四象限与类别构成)
- 输出结果四:效应量(Better/Worse 系数)与事后多重比较
- 输出结果五:结论与学术表述
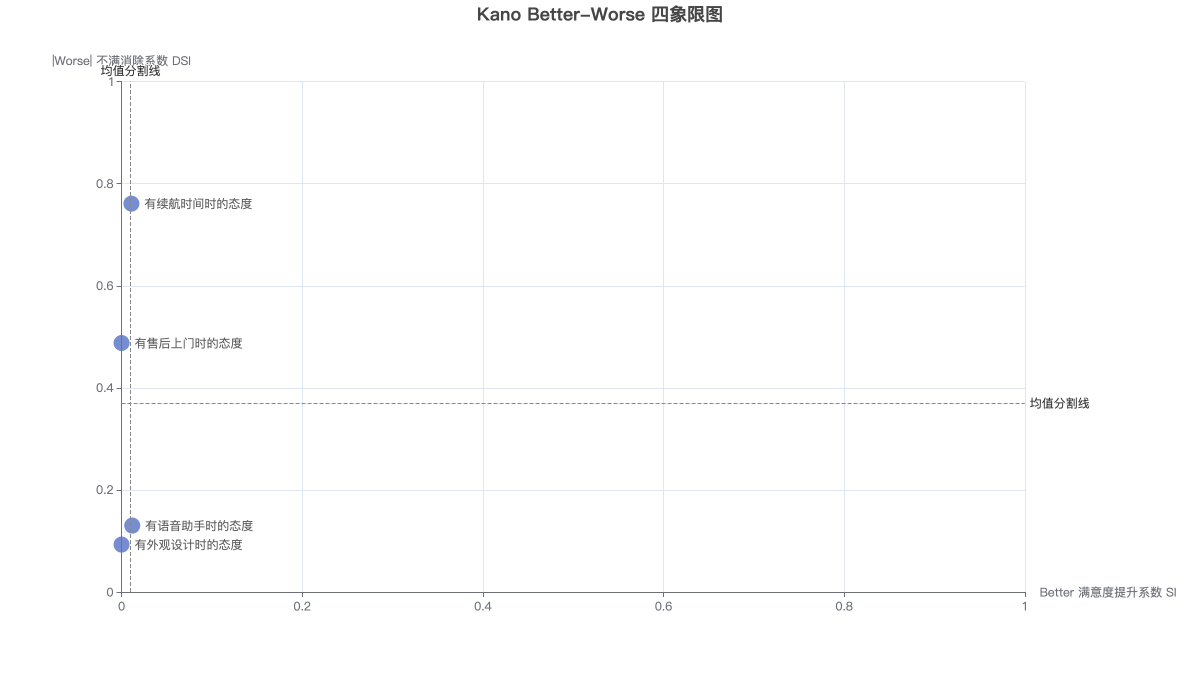
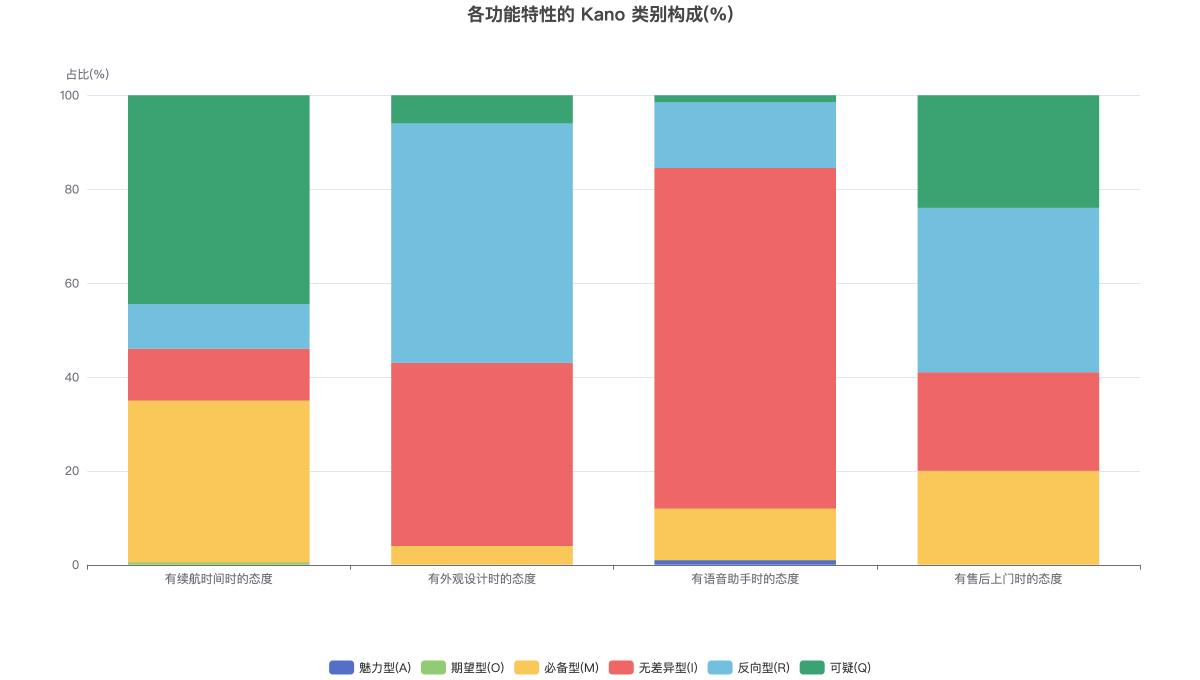
上图为 Better vs |Worse| 四象限散点(可切表格/柱图),下图为各特性的 Kano 类别构成占比。