
空间误差模型(SEM)
这个方法是做什么的
同样处理有地理坐标的数据,但空间结构放在扰动项里而不是因变量里:y=Xβ+u,u=λ·W·u+ε。含义是“相邻单元的未观测因素互相传染”——共同的气候带、流域、方言区、跨越行政边界的产业集聚,都会让相邻单元的误差同向偏移。λ>0 表示这种传染是正向的。空间权重 W 由经纬度按大圆弧距构造 K 近邻(k=min(8, n−1))再行标准化,没有可调开关;估计用 spreg 的广义矩估计(GM_Error,Kelejian–Prucha)。
这与空间滞后模型有一个决定性差别:误差型结构不产生溢出,β 就是边际效应,没有空间乘子、也没有直接/间接效应可分。所以卡④ 给的是标准化系数 β*、偏 ΔR² 与 Cohen f²,用来比较各自变量的相对强度。读这份报告的第一落点应当是卡① 最后那行“空间依赖形式综合判定”,它会按 Anselin 决策规则明确告诉你数据支持的是误差型还是滞后型。因为是矩估计而非极大似然,报告不产生对数似然,没有 AIC/BIC 与似然比检验。
需要准备什么数据
- 放入[定量]因变量 Y:不限
- 放入[定量]自变量 X(≥1 个):至少 1 个
- 放入[定量]经度:不限
- 放入[定量]纬度:不限
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 你关心的是 X 对 Y 的系数本身,空间相关只是必须清掉的干扰,而不是研究对象
- 卡① 的稳健 LM-Error 显著而稳健 LM-Lag 不显著,诊断明确指向误差型
- 因变量本身没有跨界扩散的机制,但有跨越单元边界的共同未观测因素(气候、地形、流域、共同的上级政策)
- 行政区划把本来连续的地理现象切开了,切割方式与研究变量无关,却让相邻区块的残差同向
- 只需要让 t/p 值重新可信,并不需要报告任何溢出效应
每行必须是一个带坐标的空间单元;经度与纬度各拖入一个定量列,两列不能相同、也不能与因变量或自变量重复,坐标须为十进制度且有空间变异。至少 10 个空间单元,有效样本量不少于“自变量个数+2”,因变量与自变量须为定量非常数列。
什么时候不要用它
- 诊断指向滞后型(稳健 LM-Lag 显著、稳健 LM-Error 不显著):用「空间滞后模型(SLM/SAR)」。演示数据恰好就是这种情况,报告会直接把这句话写进摘要与结论卡。
- 两个稳健 LM 都显著,或理论上邻居的自变量也会影响本地:用「空间杜宾模型(SDM)」。
- 你要报告的正是“邻近地区被带动多少”:误差型模型里根本没有这个量,用「空间滞后模型(SLM/SAR)」或「空间杜宾模型(SDM)」取它们卡④ 的直接/间接/总效应分解。
- 你需要对 λ 本身做显著性检验:本模块的广义矩估计不给 λ 的解析标准误,λ 行的标准误、z、p、95%CI 全部印成“—”。要单独判断空间自相关的强弱与显著性,用「莫兰指数(全局+局部LISA)」,它给全局 I 的伪 P 值与局部 LISA。
- 残差的相关来自重复测量或分组嵌套,而不是地理邻接(同一家医院的病人、同一个班的学生):用「混合模型」,只关心总体平均效应时用「广义估计方程(GEE)」。
- 手上没有坐标:本模块必须由经纬度构造 W。有个体与时期两维结构时用「面板模型」。
容易误读的地方
- 卡① 最后那行可能直接判你选错了模型,看到它就不要再往下解读。 演示数据里两个经典 LM 都显著(LM-Error χ²=34.956、LM-Lag χ²=74.117),但稳健 LM-Error p=0.5928 不显著、稳健 LM-Lag p<0.0001 显著,综合判定是“滞后型(应改用 SLM)”。摘要、卡① 与卡⑤ 三处都写明:λ 很可能只是被遗漏的空间滞后项吸收的结果,这份 SEM 结果不能用于论证“必须采用空间误差模型”。正确的反应是换模型重估,而不是照抄这张系数表。
- 经典 LM-Error 显著不足以选 SEM。 误差型与滞后型会互相把对方顶成显著:真存在滞后依赖时,经典 LM-Error 往往也拒绝。决策规则里起作用的是稳健版本的对比——稳健形式在对方设定存在时仍然有效——而不是两个经典统计量谁的 χ² 更大。
- λ 没有 p 值,别给它配星号。 报告在 λ 行把标准误、z、p、95%CI 全写成“—”,并在文案里说明它的显著性只能由卡① 的残差空间诊断间接判定。所以论文里写 λ=0.7537 时,必须同时写出所依据的残差 Moran's I 与 LM-Error 结果,否则读者无从判断这个数是否与 0 有实质差别。
- 别把 SEM 的系数当成“已经控制了空间溢出”的因果效应。 误差型设定假定空间结构只存在于扰动项,因变量之间没有互相影响;这个假定成立时 β 是一致的,不成立时(比如真相是滞后型)β 反而会被错误设定污染。卡⑤ 的模型局限用了“设定风险”这个词,说的就是这件事。SEM 买到的是标准误的可信度,不是因果识别。
- 模型该不该选 SEM 与拟合优度无关。 卡④ 的文案写死了这一条:判据是卡① 的形式判定,“而非 λ 的大小或拟合优度的高低”。演示数据里 SEM 的伪 R²=0.6265 略低于并排的 OLS R²=0.6341,这不说明 SEM 更差——最小二乘按定义就是让残差平方和最小的那个解。还要留意,卡④ 的偏 ΔR² 与 Cohen f² 表注写明是以“同变量组的普通 OLS 全模型 R²=0.6341”为基准算出来的,那一列并未计入空间误差结构,与上方 SEM 的系数不同源。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:回归系数表
- 输出结果三:自变量回归系数可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
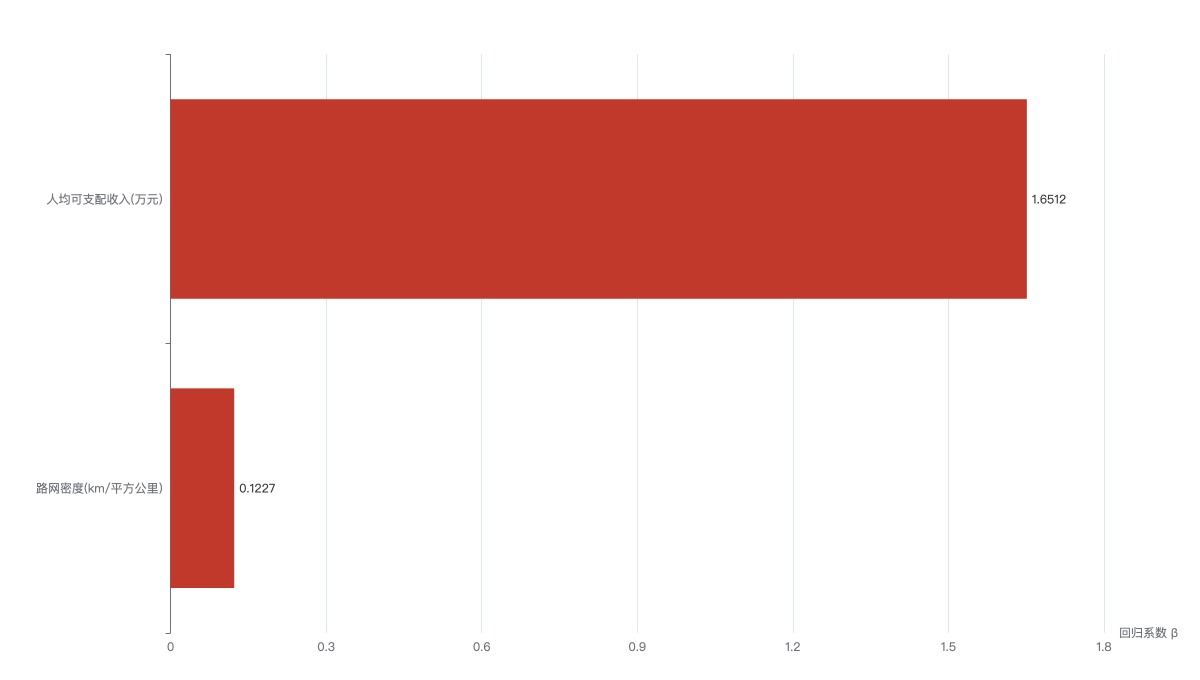
红色为正向效应、蓝色为负向效应;柱长表示效应大小(未标准化系数)。可用图上方切换器在「条形图 / 柱状图 / 表格」之间切换查看同一份系数数据。