
列线图(Nomogram)
这个方法是做什么的
把一个二分类结局的多因素 Logistic 回归,翻译成临床上能直接用手查的计分工具:每个预测因子按取值给一个分数,各分数相加得总分,再用总分查出这名患者的预测风险。它本身不是一种新的统计方法,而是 Logistic 回归结果的一种呈现方式——所以列线图靠不靠得住,完全取决于它背后那个回归模型靠不靠得住。
报告因此先花一整张卡体检模型:EPV(每自变量事件数,示例 45.67)、方差膨胀因子、Box-Tidwell 线性检验、是否收敛与有无完全分离。第四张卡才给计分体系:列线图计分表(定量因子按样本取值范围等距取 5 个代表值)、总分→预测风险对照表,以及跨变量可比的相对贡献(得分跨度与占总分比例)。同一张卡还做了 bootstrap 乐观度校正的内部验证——示例表观 C 指数 0.7403(95%CI[0.6851, 0.7955]),校正后 0.7332;校准斜率表观 1.0000、校正后 0.9672。
需要准备什么数据
- 放入[二分类]结局变量:不限
- 放入预测因子X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[二分类]结局变量」必须正好是 2 个类别。
- 「放入[二分类]结局变量」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 把已经建好的院内风险模型做成一页纸的查分表,供门诊或床边使用
- 论文里需要一个可视化的个体化风险预测工具(列线图是这类论文的标配)
- 想在同一把尺子上比较各预测因子对最终风险判定的话语权
- 想知道模型在自己数据上的过拟合有多严重——内部验证的乐观度就是答案
结局必须恰好两类且较少的那一类要有足够事件数:经验准则 EPV≥10,第一张卡给出实测值。预测因子可以是定量也可以是定类,定类会按排序后的首个水平作参照生成哑变量。第一张卡的三项前提要一起看:最大 VIF(示例 1.39)说明有没有共线,Box-Tidwell 各项不显著说明连续自变量与 logit 的线性成立,收敛与系数量级说明没有完全分离。三者任一不过关,画出来的刻度就只是拟合噪声。
什么时候不要用它
- 结局是“多久发生”且存在删失:Logistic 会把随访时长的信息整个丢掉,应改用「Cox比例风险回归」。
- 结局多于两类或本身有序(轻/中/重):本模块只接受二分类,有序结局用「有序逻辑回归」。
- 你只想报告各因素的 OR、不需要一个计分工具:直接用「逻辑回归」,它的输出更贴合关联性分析的写法。
- 某个连续自变量与 logit 明显非线性(Box-Tidwell 显著):直接线性入模会让那条轴的刻度间距整个错掉,先用「限制性立方样条(RCS)」看清形态,再决定分段或变换。
- 事件数太少、EPV 明显低于 10:系数会被系统性高估,刻度随样本轻微变动就剧烈改变;先用「特征筛选」把自变量压到“事件数 ÷ 10”以内,或按临床知识只留核心变量。
- 你要论证的是模型的临床价值而不是判别力:补做「校准曲线」与「决策曲线分析(DCA)」,列线图本身回答不了净获益。
容易误读的地方
- 判断哪个因子更重要要看得分跨度,看 OR 会得出完全相反的结论。 实测把示例里的收缩压从 mmHg 换算成 kPa(除以 7.5):OR 从 1.0299 一跃变成 1.2476,看上去重要性翻了好几倍;而它的得分跨度仍是 98.09 分、占总分 35.9%,一分未动。原因写在表注里——得分跨度 = |β| × 该因子在样本中的取值范围 × 定标系数,换单位时 β 与取值范围反向变化恰好抵消。示例中 OR 最小的收缩压(1.0299),恰恰是话语权第二大的因子。
- 统计上不显著的因子,照样在列线图上占一大块。 实测把年龄改成三分类后,两个哑变量的 p 是 0.095 与 0.194,都不显著,可“年龄组”的得分跨度仍有 32.26 分、占总分 14.0%——每一个使用这张表的患者都要为它加分。本模块不做变量筛选,拖进去几个就画几个轴;筛变量是建模之前你该用临床知识完成的事,不能指望列线图替你剔掉。
- 0 分不是参照水平,总分 0 分也不是零风险。 定标规则是每个因子在其最不利取值处记 0 分。实测三分类年龄:参照组是排序首位的“中年”,可计分表里中年是 14.0 分、青年才是 0.0 分、老年 32.3 分。同样,示例总分 0 分对应的预测风险是 0.0179 而不是 0,总分上限 273.2 对应 0.9854 而不是 1。
- 表观校准斜率恒等于 1.000,它不是“校准完美”的证据。 那一行是在拟合样本自己身上算的,数学上必然为 1,读它没有任何信息。真正有用的是紧接着的 bootstrap 乐观度校正值(示例 0.9672):小于 1 说明存在过拟合,把全部系数乘以这个数才更接近真实效应。C 指数同理,表观 0.7403 与校正后 0.7332 之差就是过拟合的量化。
- 刻度只在建模样本的取值范围内成立,内部验证也替代不了外部验证。 示例的年龄跨度是 28~90、收缩压 86~186、低密度脂蛋白 0.57~5.37;把一个 LDL 为 7 的患者往表上套,那一段刻度背后没有任何数据。此外列线图给的是关联性预测,不是因果效应——“把 LDL 降下来就能减掉多少分”这种读法在观察性数据上不成立。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(Logistic 回归系数与模型检验)
- 输出结果三:列线图可视化
- 输出结果四:效应量、列线图计分体系与内部验证
- 输出结果五:结论与解读
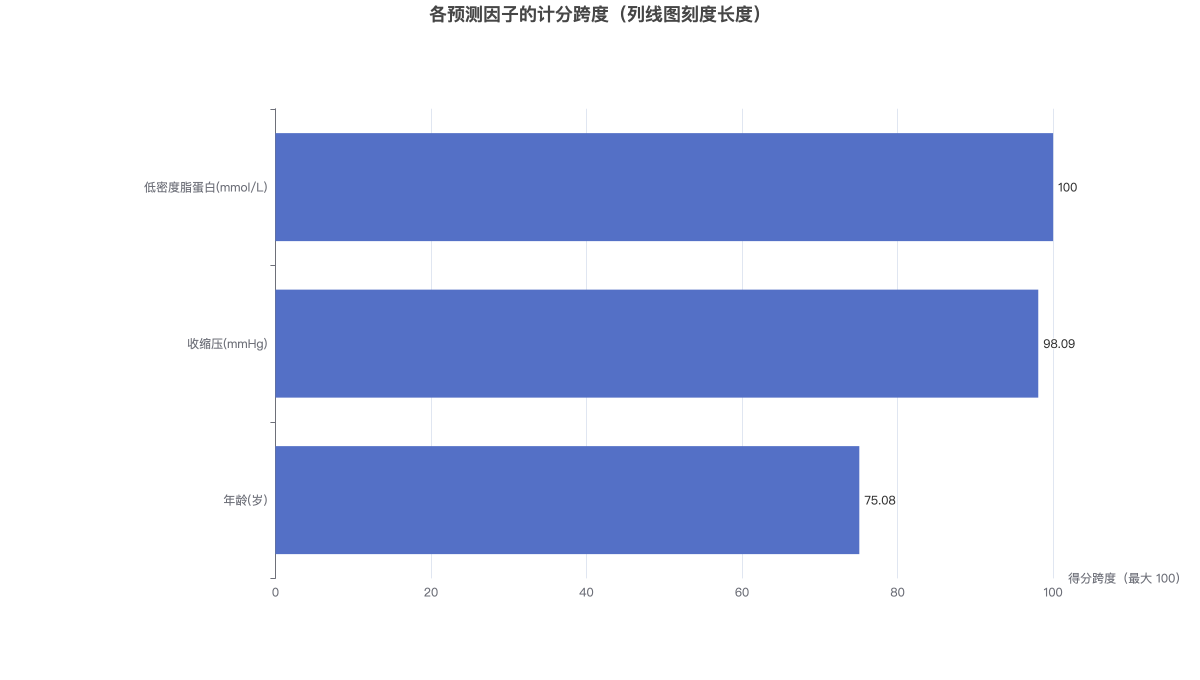
每个因子的条形长度即它在列线图上的刻度长度(得分跨度):从该因子的最不利取值到最有利取值可以带来多少分的变化。贡献最大者被定标为 100 分。
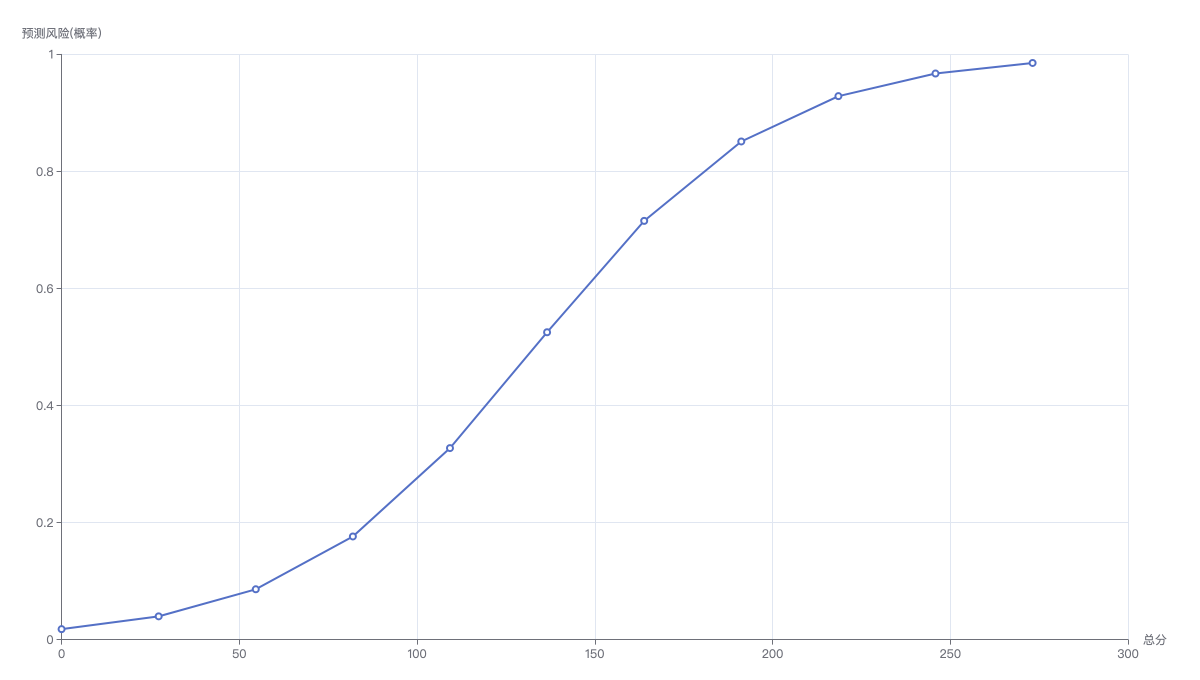
据列线图总分查对应预测风险;曲线呈 S 形(logistic)。这是列线图计分体系的风险映射可视化。