
缩尾处理(Winsorize)
这个方法是做什么的
把每个定量变量两端的极端值替换成分位点上的值:设单尾比例 5%,就是把低于第 5 百分位的观测全部改成第 5 百分位数、高于第 95 百分位的全部改成第 95 百分位数。样本量不变——这是缩尾与截尾(直接删掉极端值)的根本区别。可以一次放多个变量,单尾比例在控件里设,默认 0.05。
报告分两半。第一半回答"该不该缩、能不能缩":缩尾前的描述统计、两套口径的离群点检测(1.5×IQR 温和、3×IQR 极端、以及仅供参考的 |z|>3),以及可行性核对——实际替换个数是 ⌊单尾比例 × n⌋ 向下取整,这个值为 0 时该尾根本不会发生替换。第二半回答"缩完变成什么样":前后均值、标准差、极值的逐列对比;缩尾造成的均值位移用配对 t 检验并给 95%CI 与 Holm 校正后的 p;第四张卡给标准化均值位移 |Δ均值|/SD前、标准差与极差的压缩幅度、偏度峰度变化,以及缩尾前后的正态性检验对比。它只出对比报告,不修改你的数据集。
需要准备什么数据
- 放入[定量]待缩尾变量:至少 1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 少数极端值把均值和标准差拽得偏离了大多数样本,又不想删样本
- 想在做参数方法前压一压尾部影响,同时保住全部样本容量
- 需要一个可写进论文的交代:缩了多少比例、替换了多少个观测、中心位置动了多少
- 想在缩之前先看清"到底有没有离群点"(第一张卡的两套检测口径)
前提是各列为定量数值列、非常数列,且数据表至少 20 行——15 行的表进不来,会被直接拒绝:"当前数据表共 15 行,少于缩尾处理(Winsorize)所需的至少 20 行"。进得来之后仍可能出现"设了比例却一个都没换",第一张卡逐列核对,并在该尾不发生替换时算出所需的最小样本量。
什么时候不要用它
- 极端值本身就是你的研究对象:尾部风险、极端气候、暴发事件——缩尾会把研究对象直接抹掉。要刻画尾部就别动数据,用「分位数回归」直接对高分位建模,或用「描述性统计」如实报告 P97.5 与最大值。
- 那几个极端值是录入错误:缩尾不会删掉它们,只是把错值压到分位点上留在样本里,错误照样参与计算。先用「数据概览」或「描述性统计」定位到具体是哪几行,回原始数据核对。
- 偏态来自分布形状而不是个别点:右偏的收入、时长这类变量整条尾巴都是真实的,缩尾等于砍掉一大片真数据,用「数据变换(Box-Cox/Yeo-Johnson)」更合适。
- 你想在保留原始数据的前提下做稳健推断:不必改数据,直接换用不受极端值主导的方法——组间比较用「独立样本 Mann-Whitney U 检验」,关联用「Spearman相关分析」,回归用「稳健回归(Huber M估计)」。
- 变量是分类或等级:用分位点替换取值没有意义,看构成用「频数分析」。
容易误读的地方
- 缩尾是在改数据,一旦真的改了,后面所有推断都是在改过的数据上做的。 本模块只输出前后对比、不落库,但你若按它给的阈值真的替换了,那么之后每一个均值、每一条置信区间、每一个 p 值都属于缩尾后的样本,而不是原始总体。论文里必须写明缩了哪些变量、单尾比例多少、替换了多少个观测——省掉这句话,读者会按原始数据来理解你的结果。
- 它压低方差;真正的错误不是"方差变小了",而是接着照常用 s/√n。 示例两列的标准差被压掉 69.12% 和 74.96%(原始偏度 4.930、超额峰度 30.164,尾巴确实很重)。这里要分清两件事:厚尾数据下缩尾均值本身的抽样方差确实小于原始均值,那是稳健估计量的正常收益,不是作弊;出问题的是把缩尾后的标准差直接代进 s/√n 当标准误——被替换的观测已经被钉在分位点上,不再是独立抽出来的取值,这样算出的标准误系统性偏窄,于是 t 变大、区间变窄,本来不显著的检验可能变得显著。缩尾均值要配缩尾标准误(Tukey-McLaughlin 口径,自由度也要相应扣减),报告时必须写明用的是哪一套。
- 均值位移检验不显著,不代表"缩尾没有影响"。 那个配对 t 检验问的只有一件事:缩尾这个操作把均值挪了多少,不涉及任何研究假设。不显著只说明中心位置没怎么动——而方差已经被压掉七成了。而且缩尾前后天然配对,未被替换的那些观测差值恰好为 0,整个检验实际上只由被替换的那几十个观测驱动,它衡量的是"尾部对均值的拉扯有多大",与"缩尾该不该做"无关。判断影响大小应看第四张卡的标准化均值位移(小于 0.2 算影响很小)连同标准差压缩幅度一起读。
- 单尾比例是你主观选的,⌊比例×n⌋ 向下取整还会让它在小样本上失效。 5% 和 1% 会给出完全不同的阈值与结论,没有任何统计判据能替你定这个数。通行做法是同时报 1% 与 5% 两套结果做敏感性对照。另外比例太小时该尾一个观测都不会被替换:n=20、比例 0.01 时 ⌊0.2⌋=0,可行性表会判"无效"并算出"在 limit = 1.0% 下至少需要 100 个观测才会发生替换"——不看这张表的话,报告通篇正常,实际上什么也没发生。
- 缩尾不一定让分布更正态,有时反而更不像。 被压过来的观测全都堆在分位点这一个取值上,两端各形成一个尖峰,Q-Q 图的两端可能比缩尾前更难看。示例两列缩尾后 Shapiro-Wilk 仍然拒绝正态(p 从 0.0000 变成 0.0002 与 0.0006)。第四张卡的正态性对比表就是让你确认这一点的,不要默认"缩了就正态了"。
- 它保留样本容量,别把它当成"删掉异常值"。 n 一个都没少,自由度不变,所有基于 n 的公式照常成立;代价是那些被替换的观测现在带着一个不是它自己的取值继续参与计算。想删就是截尾,那是另一回事,两者不能混着说。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:缩尾前后统计量对比与均值位移检验
- 输出结果三:缩尾前后箱线对比
- 输出结果四:缩尾效应量与分布形态改善
- 输出结果五:结论与学术表述
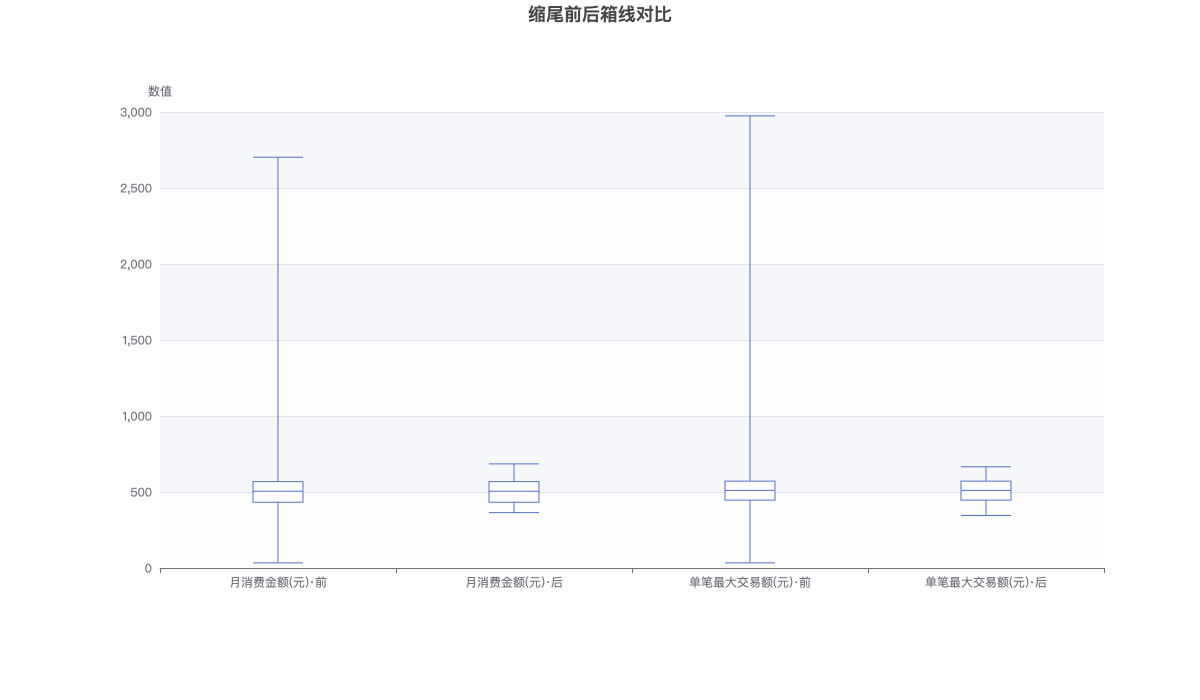
每个变量给出「缩尾前 / 缩尾后」两个箱,展示五数概括(最小值 / P25 / 中位数 / P75 / 最大值),共 2 个变量、4 个箱。可用右上角切换器切到「表格」读取精确的五数。